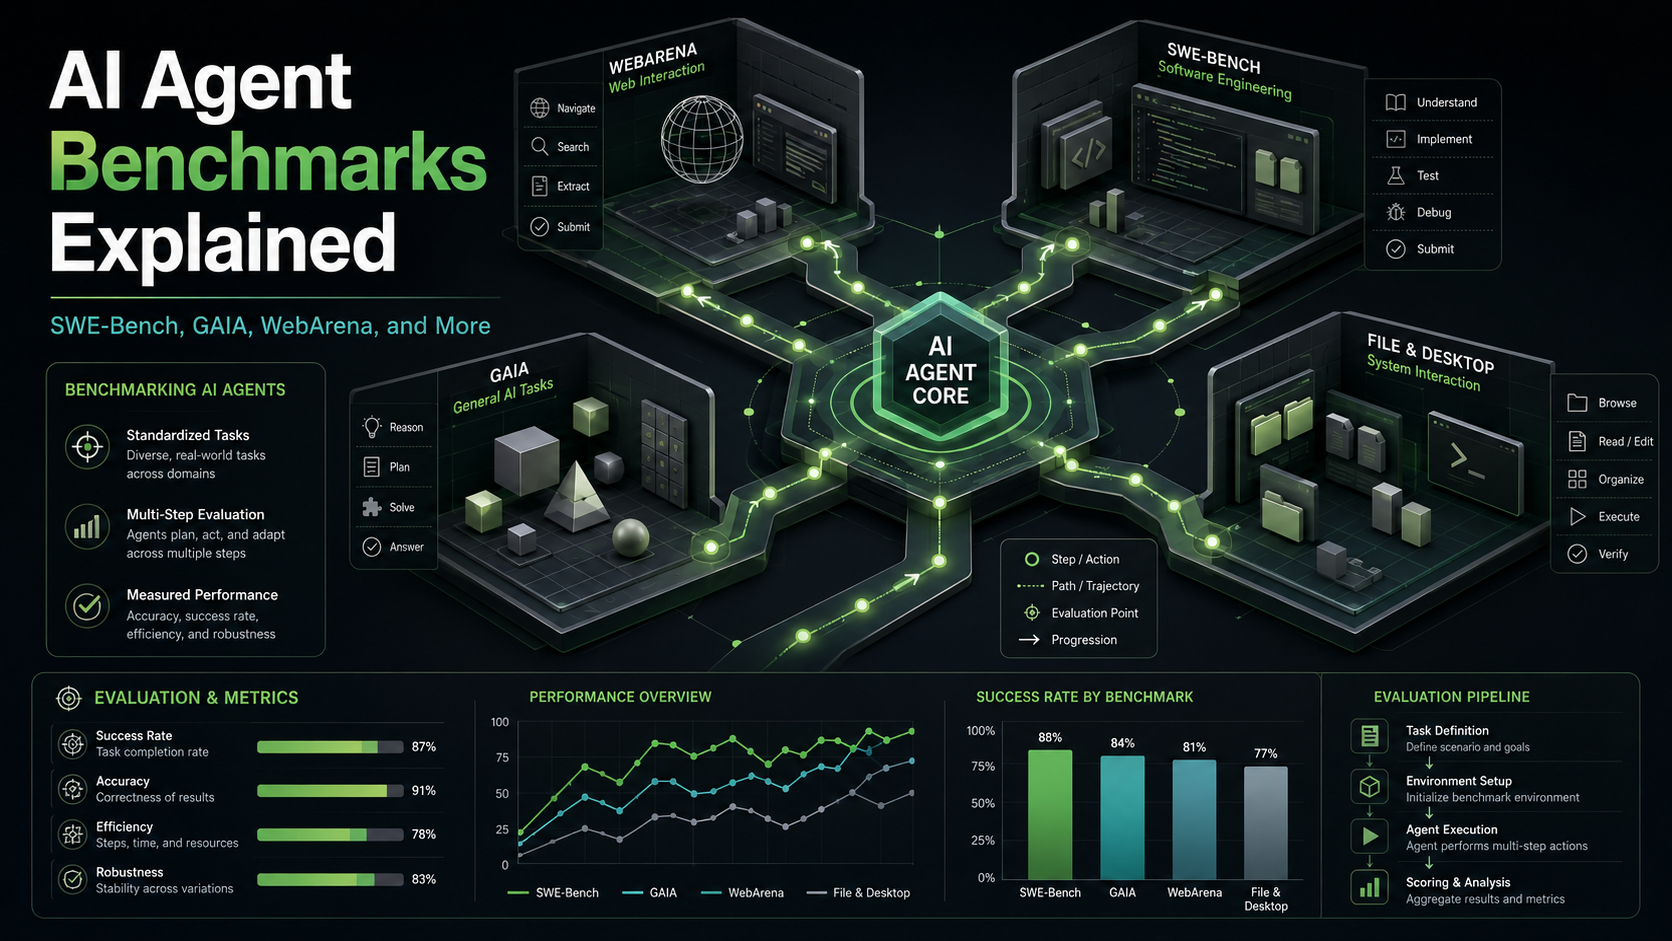
AI智能体基准测试各有侧重:SWE-Bench测代码修复,GAIA测多工具推理,WebArena测网页操作,OSWorld测桌面任务。但榜单忽略成本、延迟、安全与错误恢复,且存在数据污染和自动评分偏差。应将其作为初筛信号,再结合自身业务构建私有评测,才能可靠判断智能体能否真正胜任生产任务。
联想自研代码智能体框架TianxiCode与DeepSeek-v4.1-Flash配合,在SWE-bench-Live评测中以71%的问题解决率位列全球第一,并通过官方Verified认证。该框架支持跨文件检索、自主规划和闭环补丁生成,未来将应用于联想AI硬件产品,赋能开发者。
Cursor发布了新的AI编程评测基准CursorBench,评估不同模型的智能体表现。与SWE-Bench相比,Claude Haiku 4.5和Sonnet 4.5的分数显著下降,表明CursorBench更能反映真实开发场景。评测结合线上线下,任务真实且规模大,评分机制合理,结果与用户体验一致。
自2024年发布以来,SWE-bench Verified被广泛用于评估自主软件工程模型的进展。然而,分析显示其测试存在缺陷,导致模型能力的提升未能真实反映实际开发能力。OpenAI建议停止报告该基准分数,并开发新的评估方法。
JoyCode Agent在SWE-Bench基准测试中以74.6%的通过率跻身全球前3,并正式开源。该系统通过“补丁–单测协同生成与迭代验证”框架,显著提高了补丁的正确率和修复覆盖率,同时降低了计算资源消耗,展现了其高效的自动化修复能力和商业价值。
京东云JoyCode-Agent在SWE-Bench基准测试中以74.6%的通过率位列全球前三,展现出卓越的编程能力。该工具支持自动化编程,优化开发流程,降低成本,已服务数万研发人员。
Anthropic发布了Claude Sonnet 4.5,这是其最新的编码模型,显著提升了代理任务和计算机使用能力。该模型在安全性和训练方法上有显著改进,减少了谄媚和欺骗倾向,安全评分达到98.7%。用户反馈表明编码工作流显著提升,建议所有用户升级。
机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。
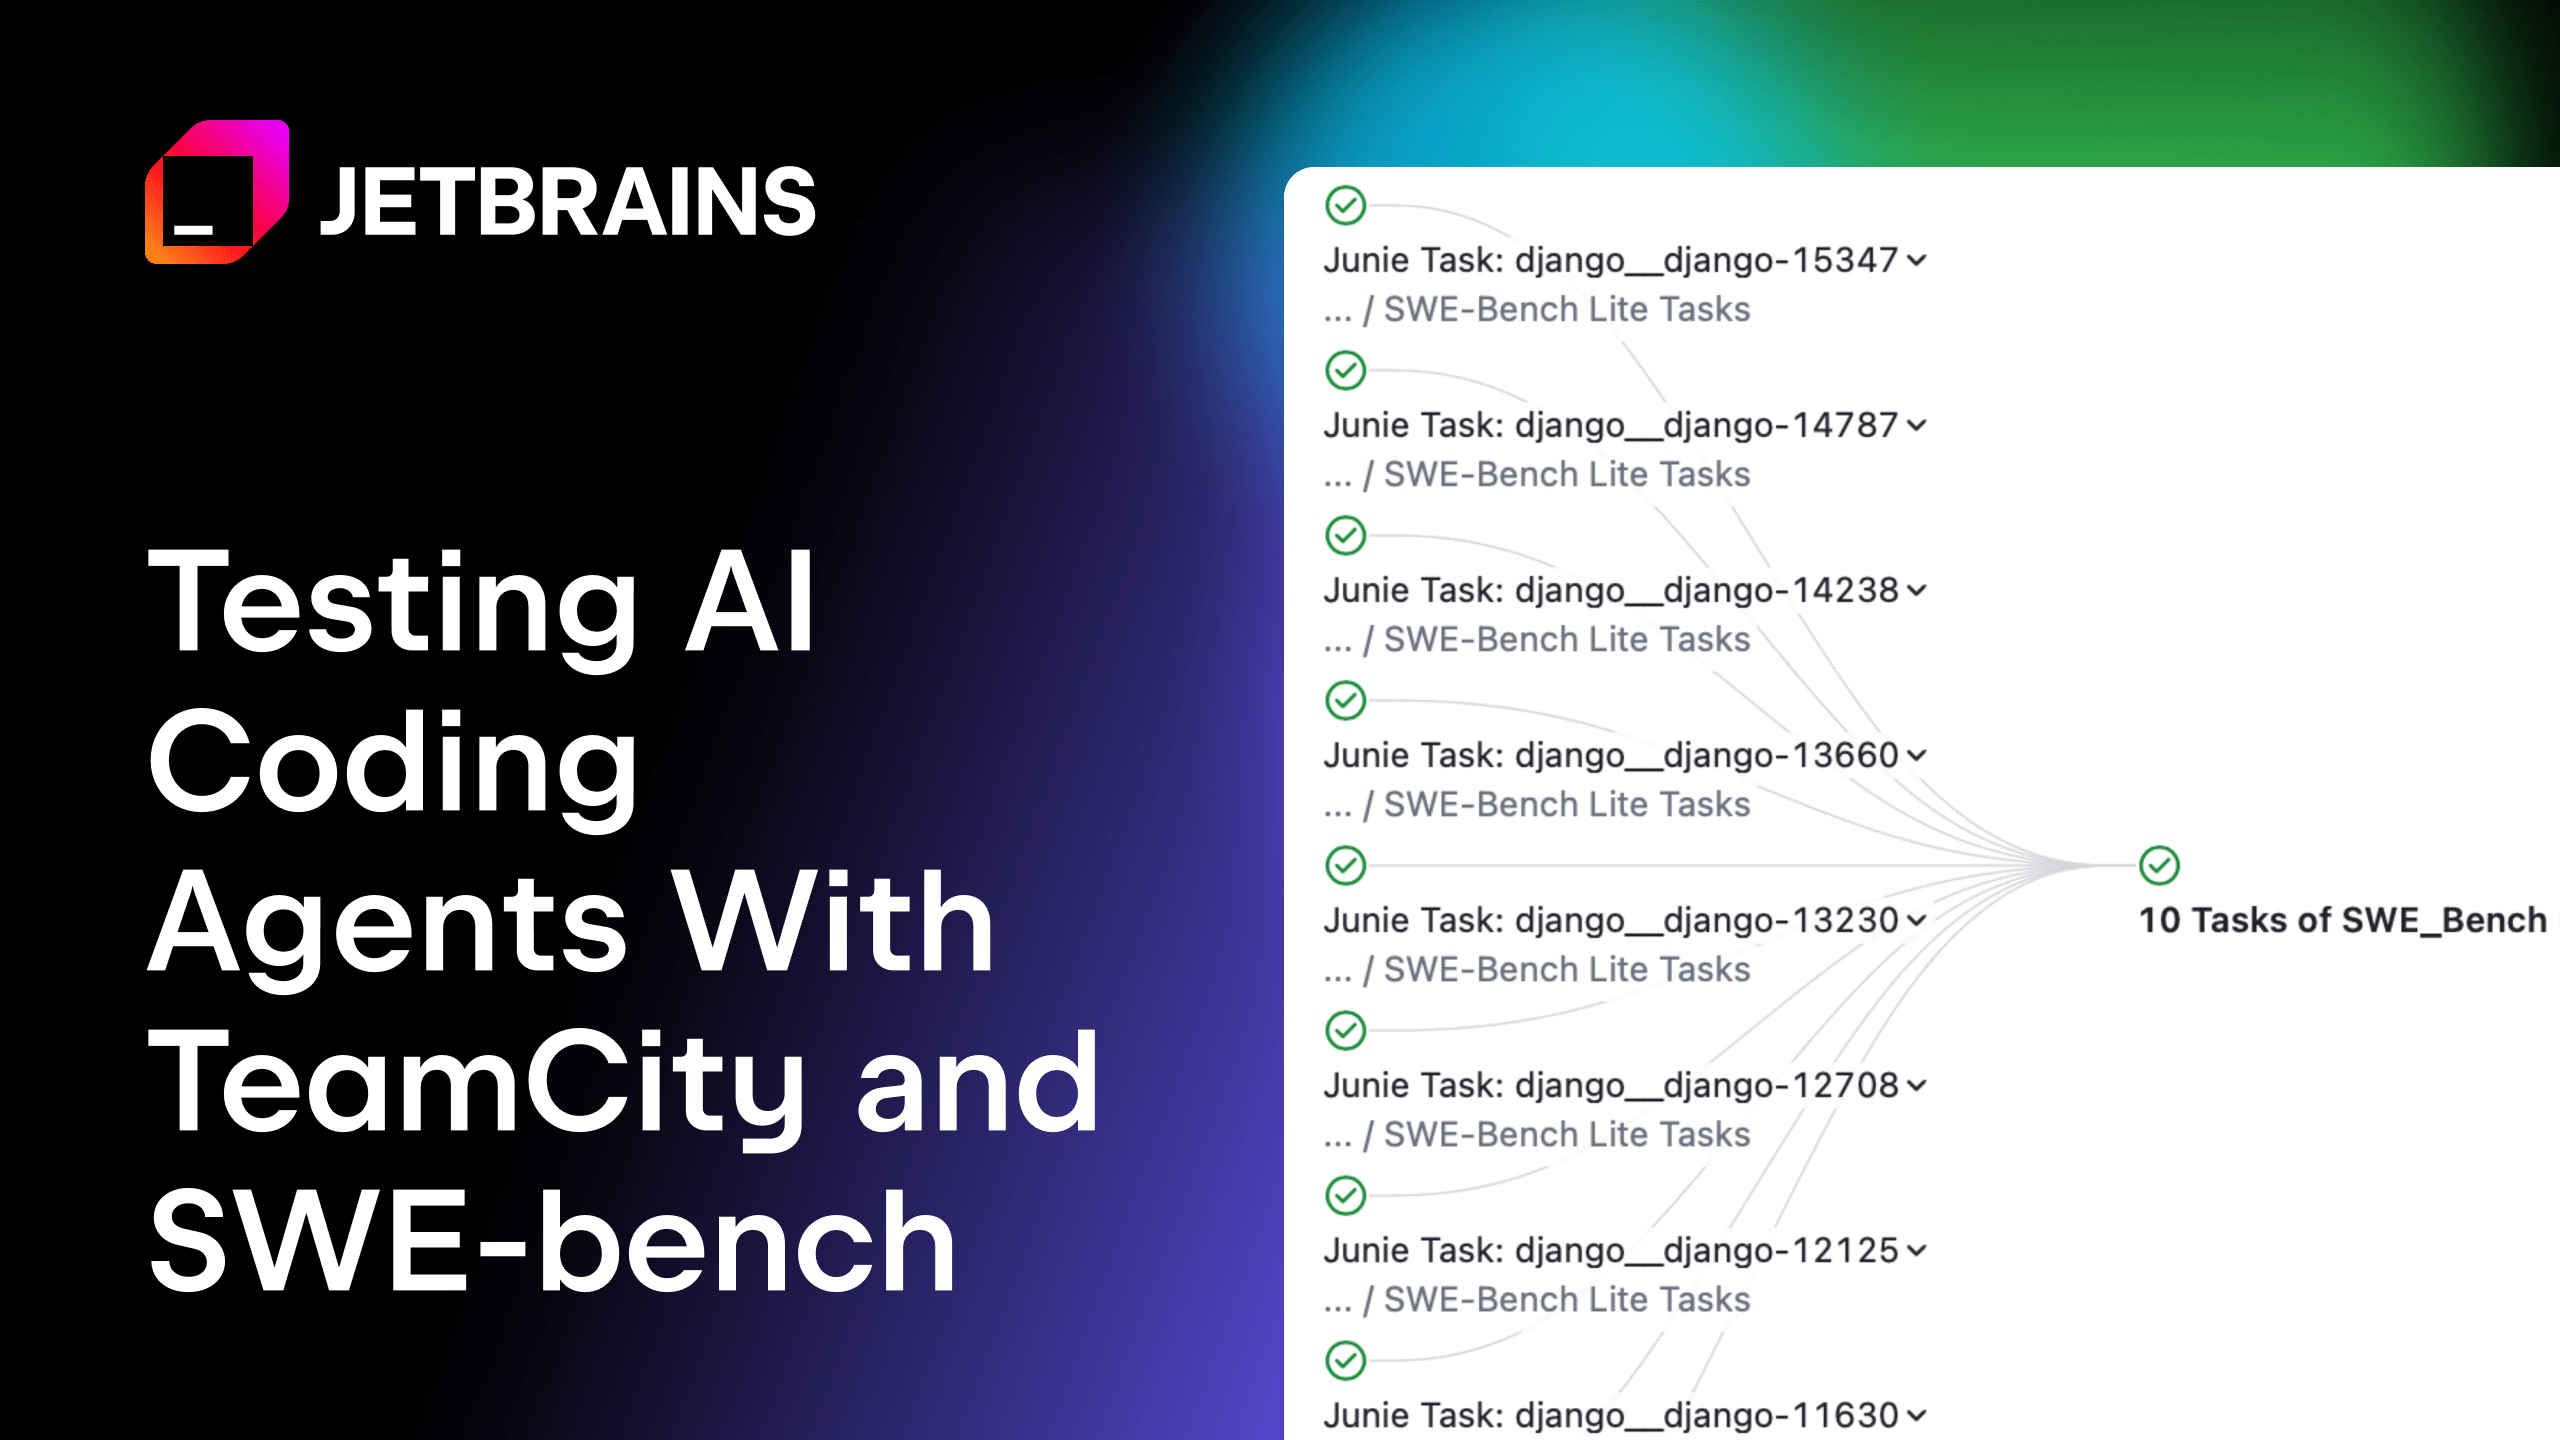
JetBrains开发了AI编码代理Junie的测试系统,利用TeamCity和SWE-bench基准进行真实任务评估。通过缓存数据集和Docker镜像,确保测试环境稳定,降低失败率,提高效率。该系统提供可靠的性能指标,帮助开发者评估AI代理的质量。
Anthropic推出Claude Opus 4.1,提升了多文件项目的编码可靠性和长时间交互的推理能力,SWE-bench Verified得分达到74.5%。新版本改善了代码重构和推理链跟踪,安全性提升,'无害响应率'达到98.76%。该模型现已向付费用户开放。
机器之心数据服务现已上线,提供高效稳定的数据获取服务,简化数据爬取流程。
蚂蚁推出的开源模型CGM在SWE-bench Lite上表现出色,修复bug成功率达到44%。该模型通过融合代码图模态,提升了代码理解和修复效率,减少了对复杂Agent的依赖,展现出强大的跨语言和跨项目能力。CGM的技术和代码已开源,提供灵活透明的解决方案。
Refact.ai Agent在SWE-bench Lite中成功解决了300个任务中的179个,成功率为59.7%。该代理完全自主,无需人工干预,具备规划、执行、测试和自我修正能力。使用的Claude 3.7模型展现了出色的多步骤指令处理能力,深度分析工具提升了解决方案质量,表明AI代理在软件工程任务中的自主处理能力日益增强。
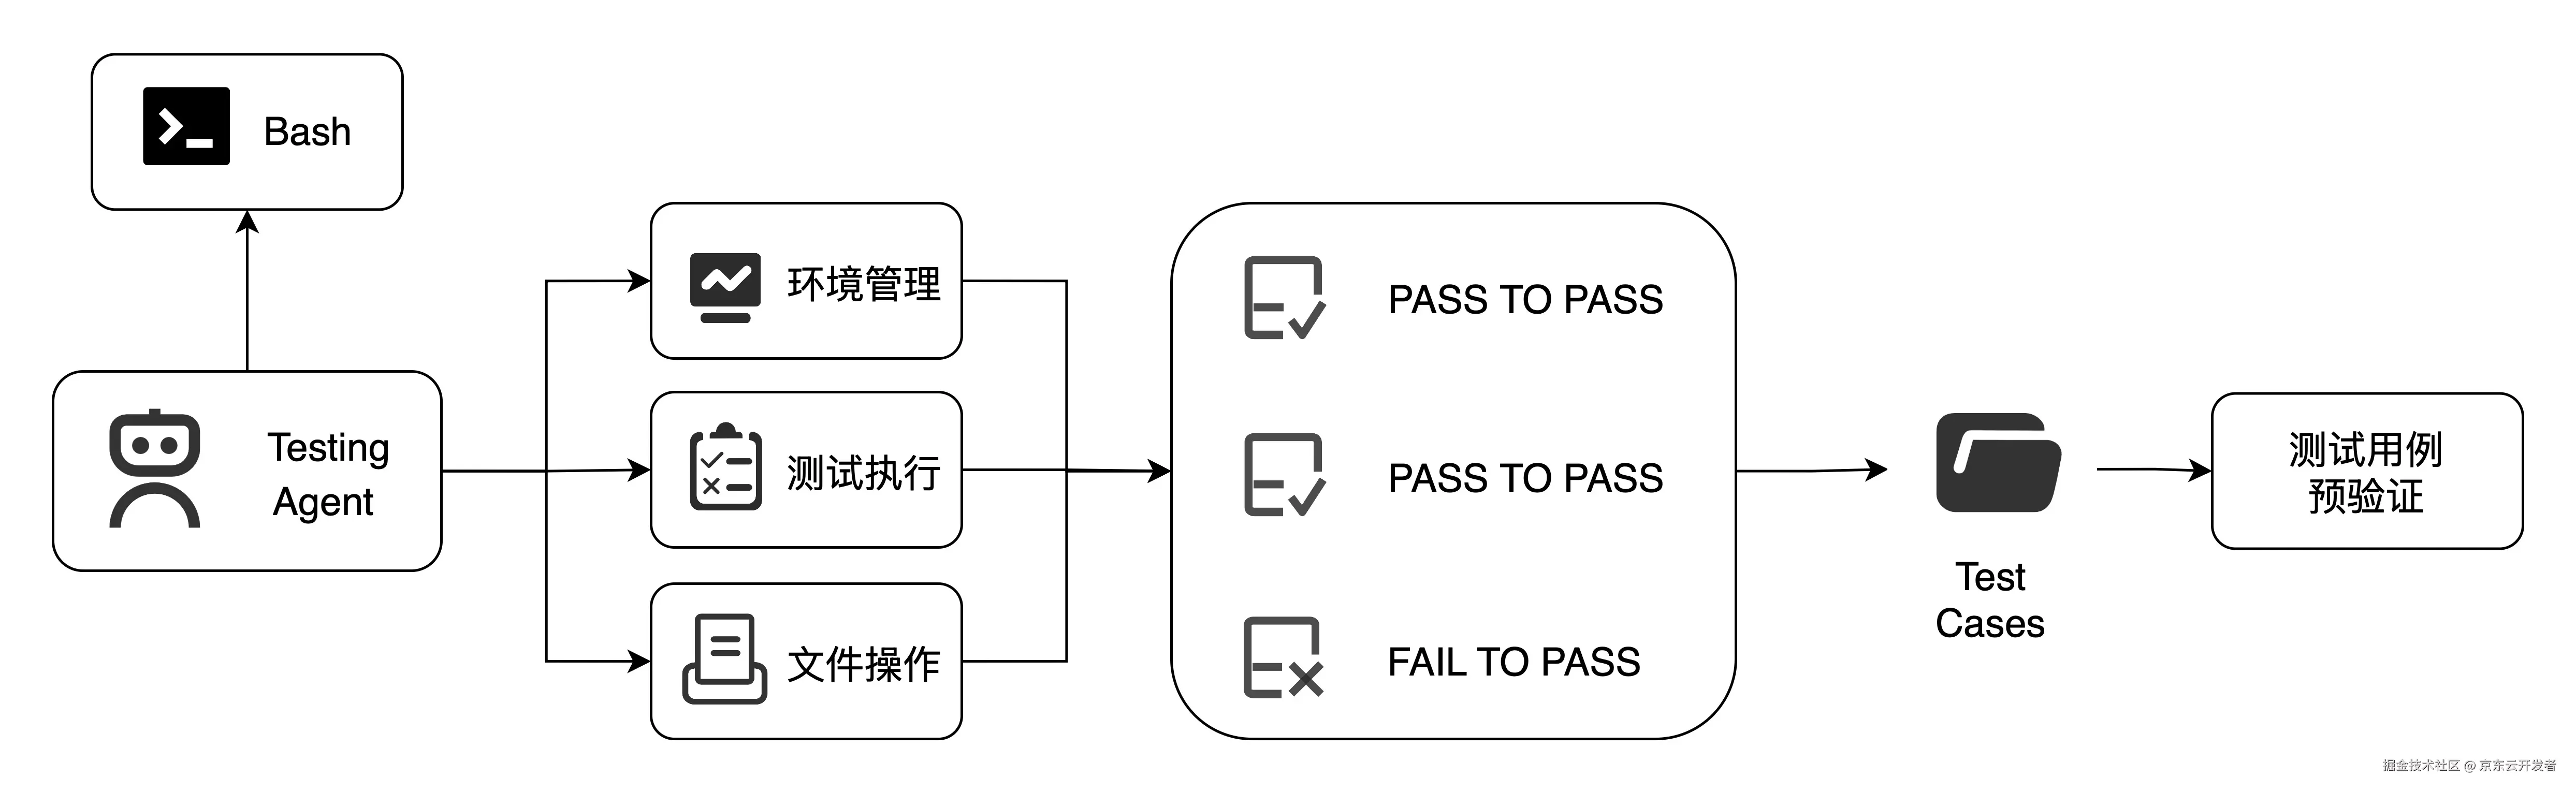
研究人员提出了SWE-bench评估框架,包含2294个来自GitHub的真实软件工程问题,旨在测试语言模型解决问题的能力。通过FAIL_TO_PASS和PASS_TO_PASS单元测试验证解决方案的正确性。OpenAI与开发者合作,改进了测试样本质量,发布了SWE-bench Verified,包含500个经过验证的样本。
本研究提出了Multi-SWE-bench基准,旨在解决现有基准在多种软件生态系统中评估大型语言模型的不足,涵盖多种编程语言,推动强化学习研究的发展。
Claude 3.7 Sonnet发布,显著提升了AI编码代理的能力。在SWE-bench和TAU-bench基准测试中,SWE-bench的解决率从49%提升至70%,TAU-bench也有明显进步。尽管测试仅限于Python代码,Claude 3.7的表现优于3.5,显示出AI在编码和理解用户意图方面的进步。
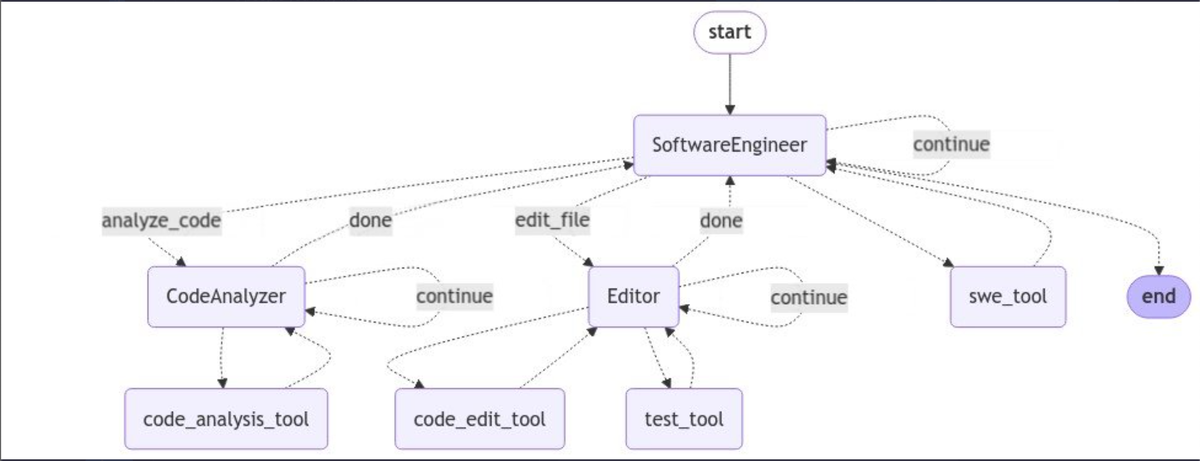
SWE-Kit是一个开源无头IDE,提供AI编码工具,支持安全代码执行和分析。通过LangGraph构建的智能代理在2294个GitHub问题中解决了243个,准确率为48.60%。该系统采用状态机管理代理,确保高效工作流,适用于软件工程等领域。
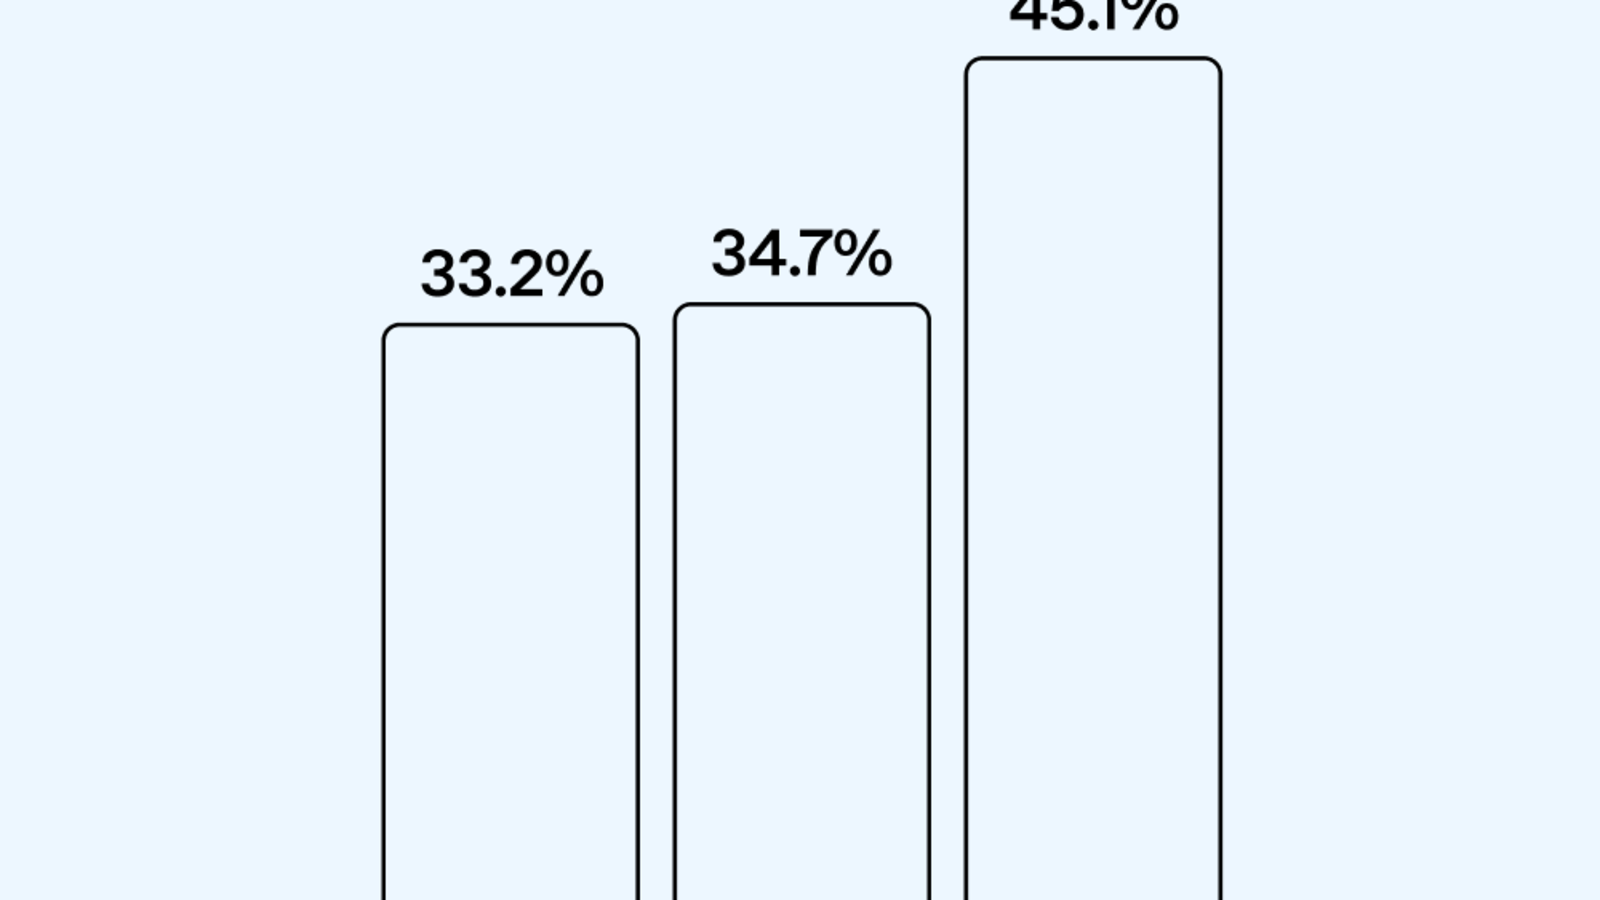
初创公司Cosine推出自主AI程序员Genie,其在SWE-bench上得分30%,超过了AI程序员Devin的13.8%。OpenAI发布了改进版本SWE-bench Verified,GPT-4o在该版本上的性能达到33.2%,是原始SWE-bench的两倍多。
SWE-bench测试集样本来自12个开源Python项目的GitHub问题,包含解决方案代码和单元测试,分为FAIL_TO_PASS和PASS_TO_PASS两组,编辑需通过这两组测试以确保问题解决且未影响其他功能。
完成下面两步后,将自动完成登录并继续当前操作。