小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

长时智能体上下文管理采用两阶段预压缩:用量达90%时后台摘要前缀,达100%时仅合并摘要与尾部增量,减少主循环阻塞。压缩保留原始记录与本地JSONL恢复指针,并冻结系统提示以维持缓存命中。优先裁剪旧工具输出,避免不必要的LLM摘要。实测每轮输入token降低40%,上下文稳定在约28万。

将上下文压缩移出关键路径:面向长时智能体的两阶段预触发与恢复提示

https://blog.ferstar.org/en/index.xml https://blog.ferstar.org/en/index.xml · 2026-08-31T15:20:00Z
通过更好的工具输出减少编码代理的Token使用

AI编码代理处理大量结构化数据时,JSON格式重复字段名会浪费token。TOON格式通过表头加行数据,减少字符和token消耗,如25条问题列表可省49%字符。选择格式需考虑数据形状和消费者,并测量实际效果,以优化代理成本。

通过更好的工具输出减少编码代理的Token使用

The New Stack The New Stack · 2026-08-31T15:00:00Z
为什么你的AI管道在演示后成本飙升10倍

AI应用成本飙升的根源在于token消耗过多,而非模型本身。优化token是架构设计问题,可通过提示缓存、语义缓存、对话压缩、工具输出精简、模型路由、上下文压缩和微调等策略,大幅降低成本并提升效率。优化不仅是省钱,更是让AI更智能、快速和可持续。

为什么你的AI管道在演示后成本飙升10倍

The New Stack The New Stack · 2026-08-13T16:00:00Z
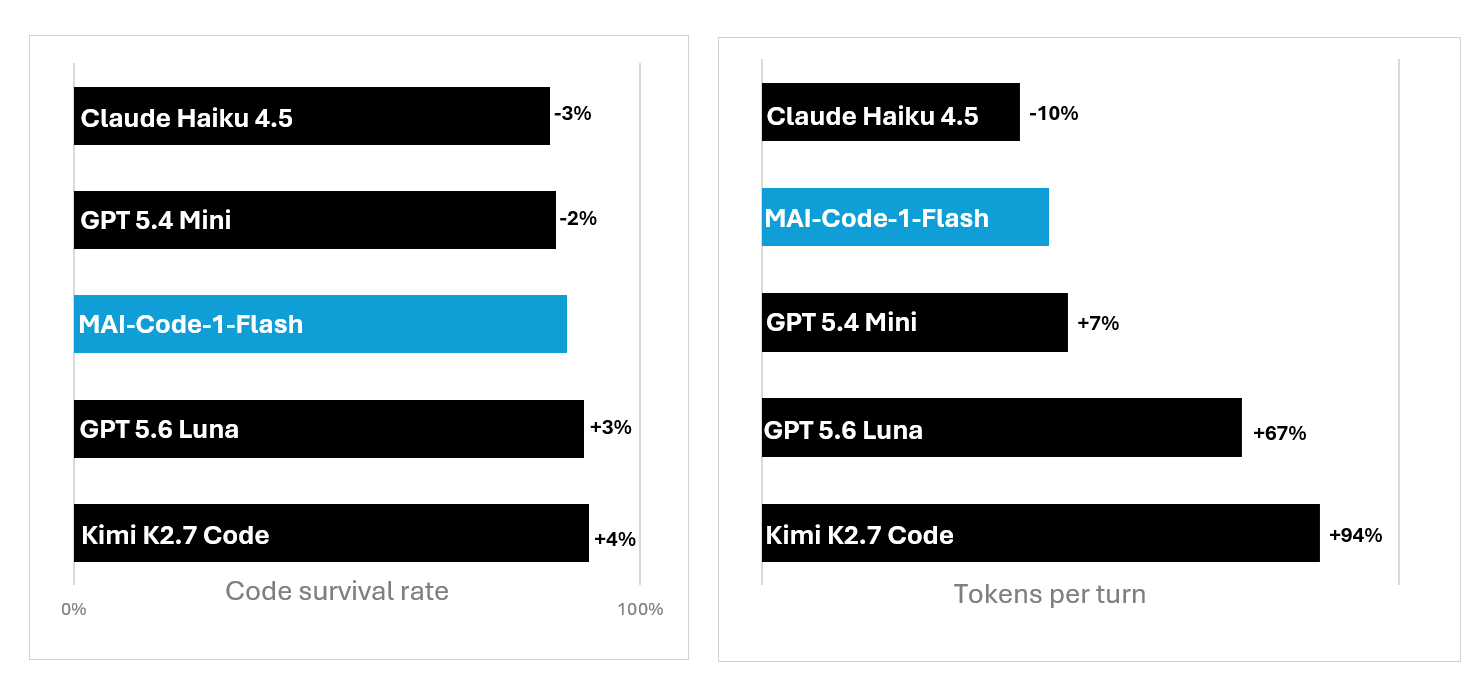
MAI-Code-1-Flash:来自真实开发者工作流的早期结果

VS Code团队推出轻量级编码模型MAI-Code-1-Flash,与GitHub Copilot集成,在保证编码质量的同时降低token使用量。生产数据显示其质量优于Claude Haiku 4.5和GPT-5.4 Mini,且比大型模型更高效。A/B测试表明用户参与度更高,token消耗更低。该模型适合简单迭代任务,未来将推出更大版本。

MAI-Code-1-Flash:来自真实开发者工作流的早期结果

Visual Studio Code - Code Editing. Redefined. Visual Studio Code - Code Editing. Redefined. · 2026-07-29T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码