Meta于10月12日发布Muse Wonder,标准版通过Model API和Muse Code提供,Full版仅限Muse Code高级订阅。定价为每百万输入4美元、输出20美元,比Anthropic的Fable 5.1便宜60%。实测三项任务:两者均通过事件调查;Fable修复漏洞略优;但Fable因“网络安全”误判拒绝常规后端项目,Muse完成并满分。Muse性能接近Fable,但token消耗更高,总成本反而更贵。
WorkSwarm推出个人知识空间,可自动采集本地文件夹、知乎、飞书、GitHub等来源资料,整理为有目录、有出处的知识库,供智能体渐进式读取,实现一次采集、反复使用,减少重复查找和token消耗,提升任务准确率。测试显示,启用后任务耗时与token消耗均明显下降。
AI可加速游戏开发,但生成代码存在逻辑、安全和可维护性问题。静态分析快速、确定、低成本,能覆盖正确性、性能、安全等六方面。两者结合可减少72%–92%的token消耗,降低33%的漏洞。建议先用静态分析打底,再用AI处理复杂逻辑,最后回归静态分析验证。
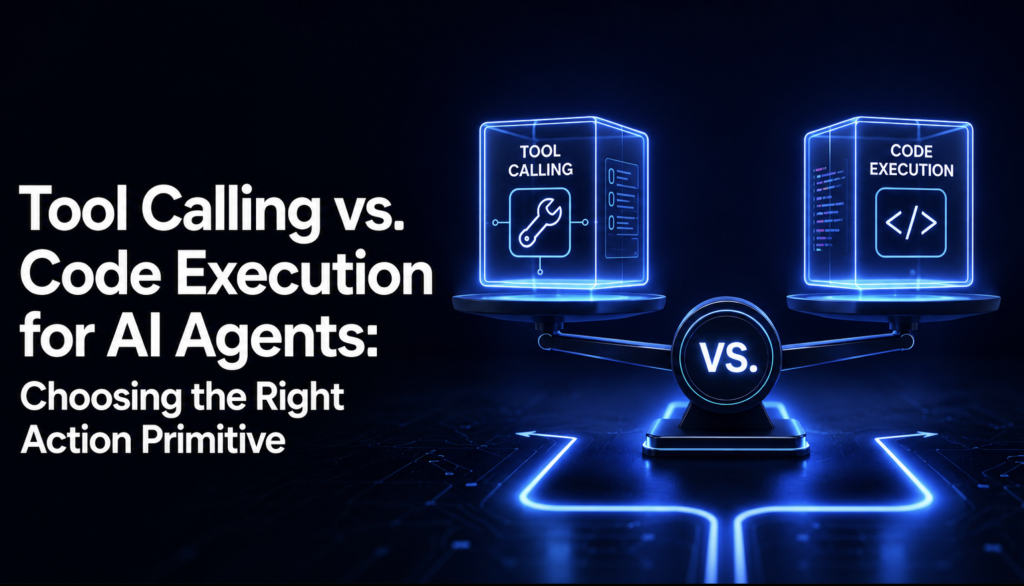
文章比较了AI智能体的两种动作机制:工具调用与代码执行。工具调用由模型逐次发起单个请求,结果返回上下文,适合单次、低延迟查询,便于审计;代码执行让模型编写脚本在沙箱中批量调用工具,仅返回最终结果,适合扇出与聚合任务,可减少token消耗并提升准确率。选择取决于调用次数、数据敏感性、延迟、基础设施与审计需求,多数生产智能体会按任务混合使用两者。
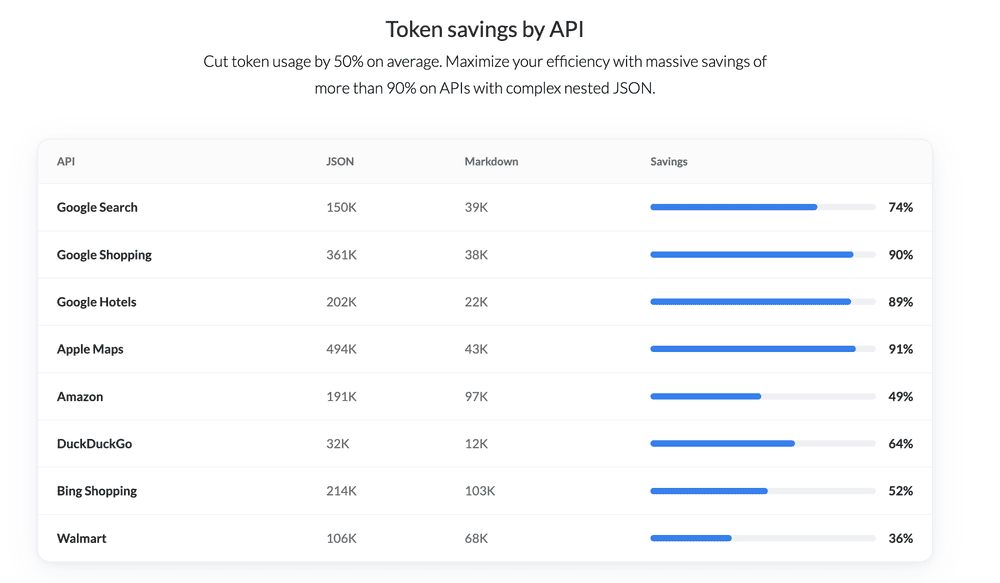
SerpApi推出Markdown输出,可大幅减少AI搜索结果的token消耗。以“coffee”搜索为例,JSON需24723个token,Markdown仅6435个,减少74%,进一步过滤后仅1298个。Markdown会移除跟踪链接、图标、嵌套元数据和重复字段,将标题与链接合并为可读行。若需精确数据类型,JSON仍更合适。该功能覆盖100多个API,不额外收费。
SerpApi 推出 Markdown 输出格式,可将搜索结果 token 消耗降低 74%(如“coffee”从 24723 降至 6435,进一步过滤仅 1298)。该格式去除追踪链接、图标、嵌套元数据等冗余内容,保留表格和链接,适合 LLM 代理使用,但需精确数据类型时仍应使用 JSON。通过 output=md 参数或 /search.md 端点即可启用,覆盖 100 多个 API 且不额外收费。
AI账单飙升并非因token单价上涨,而是代理式AI工作负载消耗的token量远超聊天场景,且缺乏成本可见性。文章建议通过记录每次运行的token数、模型、重试次数等字段,计算每项任务的真实成本,并采用成本/任务等指标来衡量价值,而非仅关注token价格。
Claude更新记忆系统,聊天与Cowork共享记忆,自动记录用户偏好,但默认开启引发隐私担忧,且消耗大量token。Claude Code未纳入,用户不满。记忆内容可管理但判断不透明,存在矛盾时无法解决,引发用户对隐私和效率的争议。
Claude Code循环工程虽能自动化AI编程,但token消耗惊人,可能烧钱失控。文章介绍四种循环模式:turn-based、goal-based、time-based和proactive,各有优劣。核心风险是循环易失控、验证不可靠,导致巨额费用。建议选对类型、明确完成条件、设上限、谨慎用auto mode、小范围试跑并监控用量,避免AI“自证正确”的陷阱。
20美元ChatGPT Plus搭配开源工具Oh My Pi,可将AI编程效率提升五倍。Oh My Pi通过哈希编辑、读取优化、压缩对话和顾问机制,大幅降低token消耗,解决官方工具的“上下文税”问题。但运行较慢、无图形界面,且大厂因商业利益不愿优化。
多智能体系统虽提升效率,但推理强度过高会致token消耗暴涨5至10倍。应匹配任务难度选择推理档位,如Scout用low、Worker用medium、Smart worker用high。协调者应专注分派任务,避免过度思考。设置fork_turns为none可减少上下文继承成本,并明确边界指令防止递归。合理配置可大幅节省成本,但需持续优化。
GPT-5.6模型系列大幅降低前沿智能体成本,提升性价比。通过模型选择、持久化推理、原生压缩、多智能体编排及程序化工具调用等新API功能,在保持性能的同时显著减少token消耗。例如Luna以1/18成本保持98%精度,Sol在ARC-AGI-3上性能提升近3倍且输出减少6倍。提示缓存延长至30分钟,进一步优化效率。
Fable和GPT-5.6 Sol等AI模型通过子智能体协作提升性能,但导致token消耗激增。文章介绍四种图谱结构(科研扇出、专家复核、异步执行、执行轨迹),强调理解执行图的重要性,并建议用户监控异常消耗,优化子智能体配置以控制成本。
智能手机主导数字生态,但AI需持续感知世界,语音交互正成为新入口。耳机、智能眼镜及独立硬件(如OpenAI Codex Micro)探索语音控制,但面临环境噪音、社交压力和成本问题。未来语音输入或转向无声识别,同时token消耗增加,厂商需平衡效率与成本,推动AI自然融入日常。
RTK工具宣称可减少Claude Code 60-90%的token消耗,但实测显示在低推理成本下费用反增7.6%,高成本下无差异。其压缩仅触及约20%工具输出,且自报节省基于错误假设。质量未受影响,但实际无节省,建议评估压缩工具应测量实际账单而非工具自报数据。
企业架构与智能体设计中,AI智能体因网页搜索返回碎片信息,反复抓取页面导致token消耗暴涨48倍。自建索引预先清洗网页为完整文档,一次调用直接推理,成本降76%。三种检索方式中,自建索引支持跨记录查询,解锁复杂问题,且与开放搜索分工,分别负责发现与深度查询,显著降低检索税。
加州大学洛杉矶分校与华盛顿大学合作提出了一种名为MemCon的记忆管理方法,将Agent的记忆操作建模为马尔可夫决策过程。该方法通过在线学习检索策略,自适应决定信息检索的时机和方式,显著提升任务成功率并减少token消耗。实验结果显示,MemCon在六个基准测试中成功率提升最高达15.2分,token使用量减少5%至20%。该方法可无缝集成到现有记忆系统中,具有良好的实用价值。
卡内基梅隆大学与国际金融管理学院的研究提出了SR2AM架构,将大语言模型的决策过程分为三个系统,显著提升了30B参数模型的性能,达到685B至1T参数级别,同时减少了25.8%至95.3%的token消耗。该架构通过自我调节模块优化了规划与执行的平衡,提高了效率与准确性,实验结果表明SR2AM在不同规模模型上均有效,能够动态分配计算资源。
该论文提出异构智能体群体架构,通过Disrupter、Validator和Broker角色分离,平衡开放探索中的安全与创造力。Scars机制将失败经验编译为约束,减少重复错误,降低15.1% token消耗。实验验证该方法能到达辩论方法无法实现的目标,并有效阻止违规操作。
完成下面两步后,将自动完成登录并继续当前操作。