
Figure、Dyna与亮源新创探索用人类视频预训练机器人。Figure的Index预训练将陌生家庭任务成功率从9%提升至56%,但未公开规模与闭环成功率的关系;Dyna验证人类视频规模扩大可持续提升真机表现;亮源新创用互联网视频验证迁移缩放定律。核心问题是人类经验能否成为可扩展的机器人预训练数据。
Shopify's engineering introduced gisting, a novel technique for compressing long LLM prompts into a smaller set of learned "gist" tokens, improving throughput and reducing inference cost. By...
本文介绍GeekAgent开发第七天,实现轻量TUI界面与用量面板。通过引入pi-tui库,程序接管终端,左侧显示消息流,右侧常驻面板展示模型、会话、上下文占用及本轮/累计tokens。接口回传usage数据,流式期间用字符估算。支持输入编辑、工具确认,退出恢复原终端。代码新增1115行,验证功能正常,为后续权限管理打基础。
华为云CodeArts推出“码力续航计划”,每日免费发放1000万Tokens,用于复杂算法、项目解析和批量代码生成。用户登录即送,无需点击,额度每日刷新、次日重置,总量价值100万元,发完即止。活动旨在减轻开发者算力负担,提升编码效率。
Frugal Tokens是一款本地运行的AI会话成本分析工具,支持Claude Code、Cursor等助手,提供Token用量、费用拆解、缓存效率及跨模型价格对比。数据本地处理,隐私安全,基于Deno和SQLite,适合开发者优化AI编程开销。
Baruch Sadogursky and Patrick Debois discuss why coding agents fail due to bloated context windows and stuffed prompts. They explain practical context engineering fixes, including lazy-loaded...
Meryem Arik discusses strategies for designing low-cost LLM inference architectures for high-volume, non-real-time workloads. She explains how software architects and engineering leaders can...
华为云推出开发者成长中心,用户通过每日签到、实名认证、开通码道、使用智能问答、发布文章、使用AI Shell、参加活动等低门槛任务赚取积分,可兑换代金券抵扣ECS、OBS等账单,实现免费运行轻量应用。连续打卡一个月可获400元代金券,并推荐开源项目实现任务自动化。
华为云OfficeAce办公智能体0.4.5版上线,取消邀请码,内置大模型限时免费。新增AI Excel多表自动生成透视表、AI PPT风格复刻、AI Doc专利简报撰写、DeepResearch增强,支持多模态解析、AI生图入PPT、OCR扫描件识别,并优化PPT编辑和生成速度,提升办公效率。
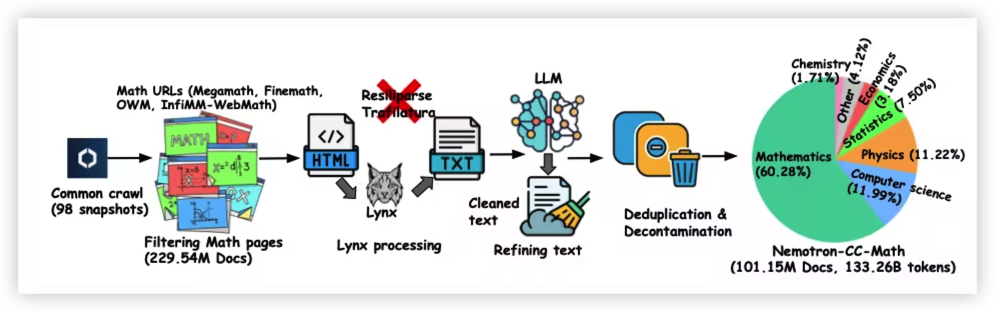
训练数据在大模型竞争中至关重要,NVIDIA推出的Nemotron系列数据集强调数据质量和任务适配性,涵盖通用文本预训练、监督微调和代码生成等核心能力,推动模型训练从数量向精准转变。这些数据集为大模型研究提供系统性支持,提升模型能力。
在AI编程助手的使用中,Claude Code的隐性消费显著高于OpenCode。测试显示,Claude Code在执行简单任务前消耗了四倍的token,并且在对话中频繁重写缓存,导致额外费用。尽管功能强大,但两者在任务完成质量上无明显差异,用户需关注隐性成本,合理管理资源。
OpenAI的新模型GPT-5.6显著提升了科研效率,研究员的角色从操作工转变为指挥员。该模型能够自动诊断故障、优化系统、设计实验和解读数据,显示出AI在科研中的重要性。尽管流程加速,研究的创造性和判断力仍需人类掌握。
EdgeOne Pages 升级为 EdgeOne Makers,新增 AI Agent 托管能力,支持快速部署 GitHub 上的 Agent 项目。开发者无需配置服务器即可获得可分享的 Demo 站点。当前活动中,填写邀请码可领取最高 50 万 Token 资源,便于快速验证和展示项目成果。
Claude Sonnet 4现支持高达100万tokens的上下文,适用于大规模代码分析和文档处理。该功能在Claude开发平台和Google Cloud的Vertex AI上进行公开测试,定价也进行了相应调整。
Meta 正在限制员工的人工智能使用量,因最近 30 天内消耗高达 60 万亿 Tokens,预计将导致数十亿美元的支出。公司采取 Tokens 最小化策略,设定团队预算上限,并开发工具实时监控 AI 用量。其他科技公司如 Uber 和 Microsoft 也在实施类似措施以控制成本。
小米推出了MiMo-V2.5-Pro-UltraSpeed模型,具备1T参数和1000+ TPS的推理速度,突破了GPU的性能限制。该模型在全栈开发任务中表现优异,能够快速生成高质量的复杂应用,推动了大模型的商业化进程。
苹果在WWDC 2026上推出了新的Siri AI,系统提示词长达1300行,包含9000个Token。提示词强调诚实原则,要求Siri在无法完成任务时明确告知用户,并在回答前进行思考,以提高准确性。Siri AI被定义为无情感的软件,具备结构化处理信息和智能响应的能力。
联想推出的百应AI主机旨在解决个人公司在AI应用中的Token费用和安全问题,提供本地与云端结合的智能解决方案,降低Token成本,推动AI技术的普及与应用。
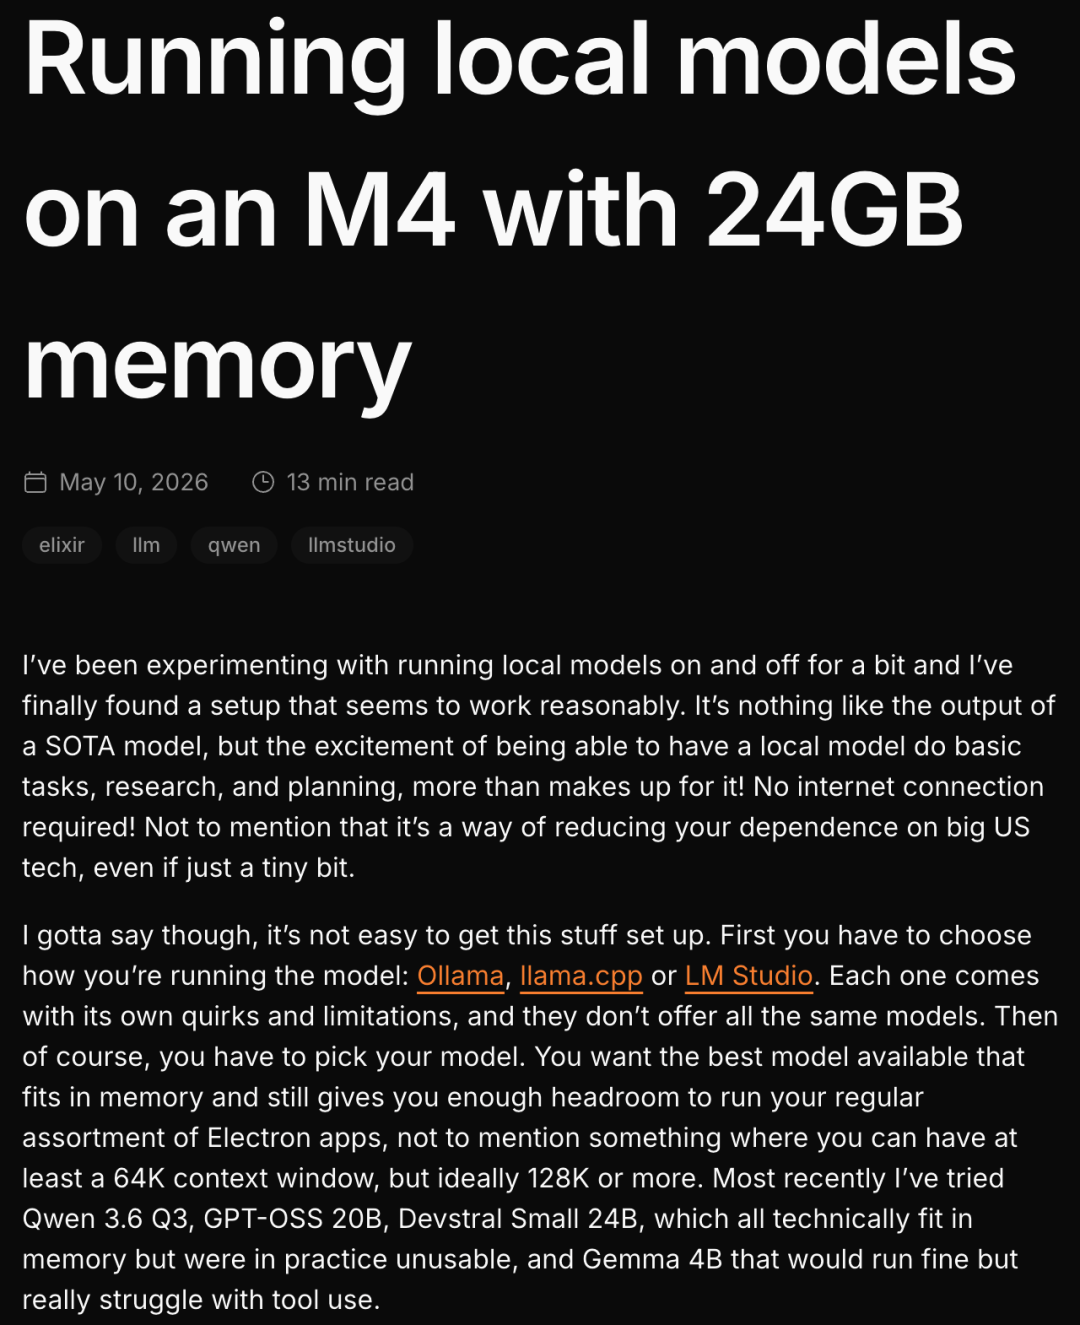
开发者jola分享了在M4 MacBook Pro上运行Qwen 3.5-9B(Q4_K_S量化版)本地大语言模型的经验,尽管该模型无法完成复杂任务,但它提升了开发者的参与度,成为一种可控的离线助手,适合24GB内存的用户。
Subquadratic公司推出了一种新模型,支持高达1200万tokens的上下文窗口,声称在检索效率上超越现有模型。其选择性注意力架构在计算和内存上实现线性扩展,速度比传统模型快52倍。公司计划未来推出5000万tokens的模型,并提供API和编码工具。尽管面临挑战,Subquadratic在多个基准测试中表现优异,吸引了投资者关注。
完成下面两步后,将自动完成登录并继续当前操作。