本文介绍Triton张量描述符,用于描述张量内存布局、简化GEMM核实现,并在SM90+ GPU上支持TMA操作。描述符分为设备端和主机端两类,包含基地址、形状、步长和块大小等元数据。作者分别用原始指针、设备描述符和主机描述符三种方式实现GEMM并测试,结果均正确。在RTX 5080上,大尺寸矩阵中描述符版本略快于原始指针,8192³时主机描述符约快7%。
文章探讨在CUDA中优化sigmoid函数以提升GPU指令吞吐性能。作者用Triton实现三种版本:原生tl.sigmoid、基于FTZ的近似实现,以及用tanh.approx.f32的近似实现。在RTX 5080上测试,tanh近似因只需一条MUFU指令,速度约为原生实现的两倍,FTZ版快约5%,但tanh数值误差略大。
本文介绍如何检查AOTInductor生成的Triton内核SASS。AOTInductor是PyTorch后端编译器,可生成预优化推理引擎,其Triton内核以cubin文件存于pt2包中。解压后用nvdisasm或cuobjdump反汇编即可查看SASS。示例验证了128位向量化内存指令LDG.E.128和STG.E.128确实被生成。
NVIDIA公布HSTU推荐部署流程,采用PyTorch AOTI编译、FlexKV缓存与Dynamo-Triton服务,八层模型满命中时延迟最高改善5.93倍,但收益取决于用户历史前缀复用率,50%命中时加速不足2倍。建议先验证输出一致性,再测试各命中率下的延迟、缓存失效与显存淘汰,并将推荐质量纳入验收,按每千次请求节省的GPU毫秒决策。
Triton是一种基于Python的并行编程语言和编译器,用于高效编写自定义DNN计算内核,并在现代GPU上实现最大吞吐量。其triton.language.fma(x, y, z)函数执行逐元素融合乘加运算。
CUDA线程块执行顺序会影响L2缓存命中与GEMM性能。文章介绍了线性、分组2D面板、Morton和异或等swizzle算法,并用Triton进行基准测试。结果显示,预测的缓存命中率与实际吞吐量几乎不相关,列主序明显慢于行主序,原因可能在于DRAM访问模式等底层因素。结论是应针对具体配置实测,而非依赖缓存命中率预测。
Triton是一种基于Python的并行编程语言和编译器,用于高效编写自定义DNN计算内核,并在现代GPU上实现最大吞吐量。文章还介绍了其函数triton.language.floor,用于逐元素向下取整,参数为Block类型的输入值。
Triton是一种基于Python的并行编程语言和编译器,用于高效编写自定义DNN计算内核,并在现代GPU上实现最大吞吐量。文章还介绍了其在线教程及函数triton.language.fdiv(x,y),用于计算x和y的逐元素快速除法。
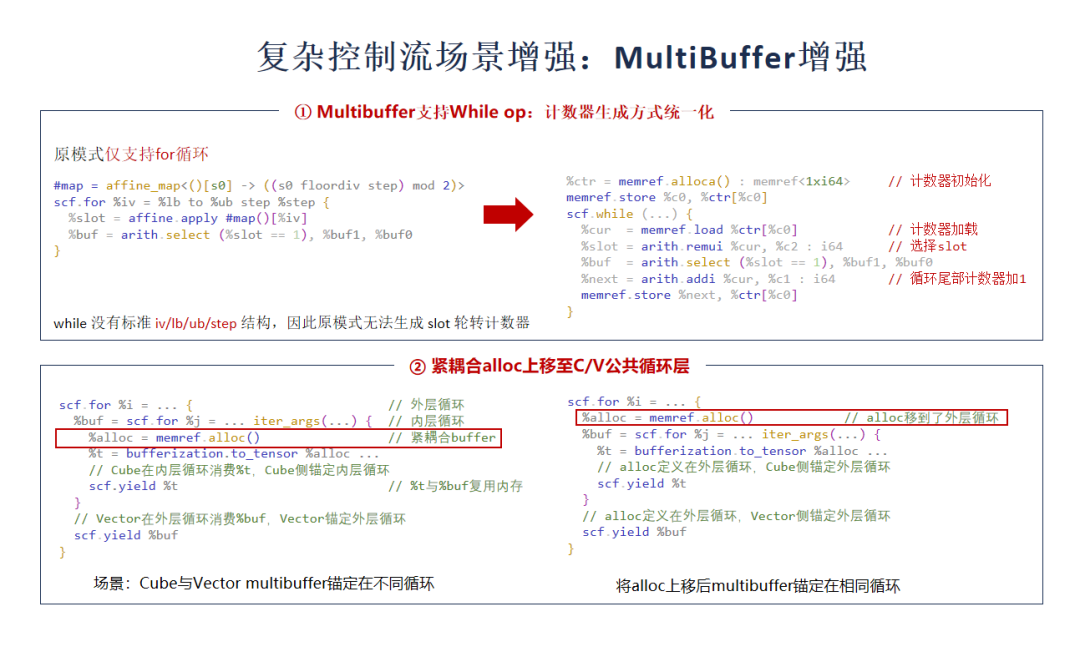
华为AscendNPU IR编译器架构师海丽娟在技术沙龙中介绍了其开源底座,该底座基于MLIR构建,提供Tile级抽象,支持多语言接入昇腾硬件,适配A2/A3至昇腾950架构,优化CV流水并行、寄存器融合、SIMT支持及多核切分,提升算子开发效率。项目已开源,社区提供任务和免费算力。
AI智能体Prime Agent发现手写CUDA内核在RTX 3090上性能比Triton自动生成代码慢15%,调整分块尺寸无效,瓶颈不在共享内存。AI辅助编程正从“写代码”进化到“发现人类想不到的优化方向”,人类仍负责最终修复。
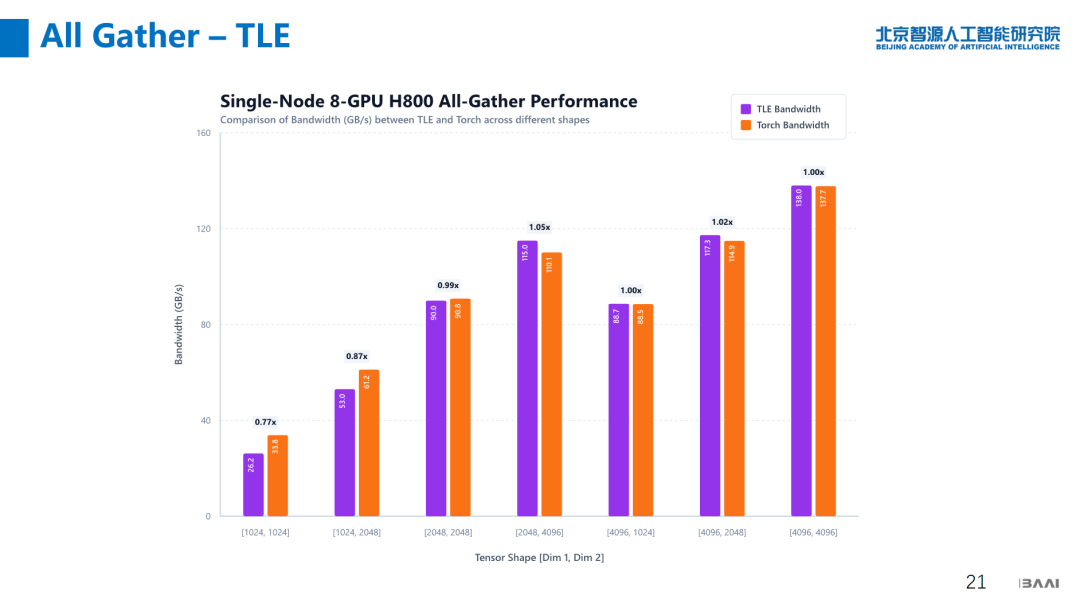
8月1日北京举办AI编译器技术沙龙,BAAI团队介绍FlagTree项目,通过Triton语言扩展TLE(分Lite、Struct、Raw三层)平衡抽象与性能,覆盖算子优化、架构调优及原生代码。编译优化包括TileIR后端、自动调优(FlagOSTune加速120倍)、数据布局转换消除及指令重排,显著提升DeepSeek等模型性能,未来聚焦NUMA和MegaKernel。
Triton是一种基于Python的并行编程语言和编译器,用于高效编写自定义DNN计算内核,并在现代GPU上实现最大吞吐量。文章还提供了在线教程链接及triton.language.exp2函数的说明,该函数用于计算逐元素以2为底的指数。
8月1日北京将举办AI编译器技术分享会,智源、TileRT、腾讯、华为昇腾、智元创新等专家出席。议题涵盖Triton语言扩展、TileRT低延迟推理、FalconGEMM低复杂度矩阵乘法、AscendNPU IR开源及具身智能编译器,探讨多层级协同优化。活动限150人,需报名。
Triton是一种基于Python的并行编程语言和编译器,用于高效编写自定义DNN计算内核,并能在现代GPU上以最大吞吐量运行。其triton.language.exp(x)函数可计算输入块x的逐元素指数值。
Netflix has described the production lessons behind bringing LLM inference into its internal serving platform, including the challenges of supporting different model sizes, hardware requirements,...
UTM推出新驱动Triton,为QEMU虚拟机提供更完整的DX11支持,改进Windows图形加速。Triton将DDI调用转为DX11,配合Neptune转发,减少转换层,提升兼容性。但macOS上因苹果授权限制,暂无法打包D3DMetal。代码已开源,仍处实验阶段,普通用户可等待后续版本。
Triton 是一种新型编程模型,简化了深度学习算子的开发。它通过编译器自动处理访存合并、共享内存管理和指令调度,减少了手动编码的复杂性。Triton 采用 tile 视角,允许开发者专注于数据块的处理,配合 autotune 功能自动优化配置,提升性能。总体而言,Triton 提高了开发效率,适合大多数自定义算子,但在极限性能和特定场景下仍需使用 CUDA。
本文讨论了如何在PyTorch中使用Triton内核进行透明追踪和编译。用户可以通过@triton.jit创建Triton内核,并利用torch.compile和torch.export进行优化。注册的自定义操作可以在追踪和编译中被识别,而未注册的操作需使用TorchDynamo进行追踪。最终,Triton内核可通过AOTInductor进行预编译,以提升性能。
本文探讨了NVIDIA的CUDA生态系统,包括编译链、高层工具、分层结构、数学库(如cuBLAS和cuDNN)、通信库(如NCCL)及Triton DSL。文章比较了AMD ROCm和华为CANN的定位,分析了CUDA在大模型训练中的重要性和优势,并强调了性能调优工具Nsight的使用,以及FP8训练的潜在问题和解决方案。
Triton是一种基于Python的并行编程语言和编译器,旨在高效编写自定义深度神经网络计算内核,并在现代GPU上运行。它提供了多种处理张量的函数,如argmax、argmin、max、min、reduce和sum。
完成下面两步后,将自动完成登录并继续当前操作。