Mistral AI发布Voxtral 3语音模型家族及配套SDK,包括3个转写模型、1个TTS模型和基于LiveKit的语音智能体SDK,均已在Mistral API公开预览。Small Transcribe 3的AA-WER为2.1%,排名第三,说话人分离表现最佳,但实时模式精度落后于Gemini 3.5 Realtime。批处理转写每分钟0.0035至0.004美元,TTS每百万字符13美元,未宣布开源权重。
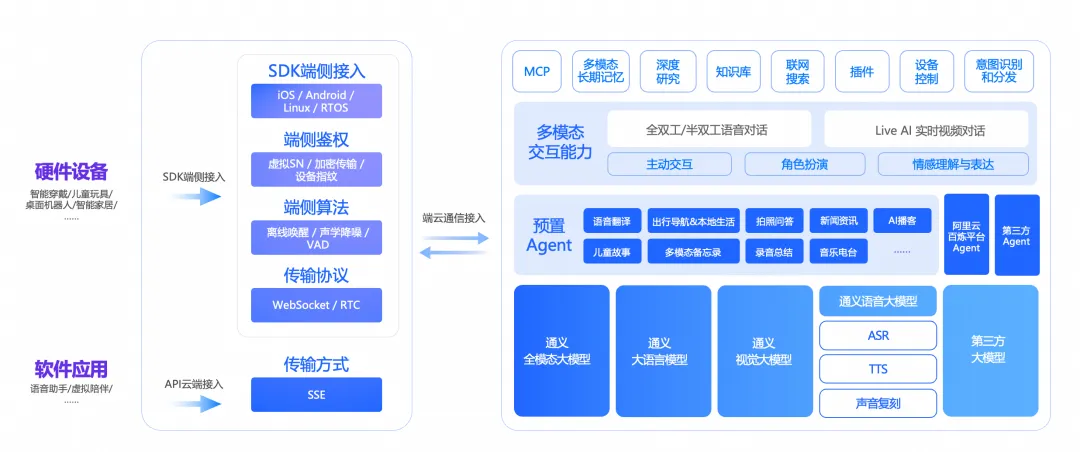
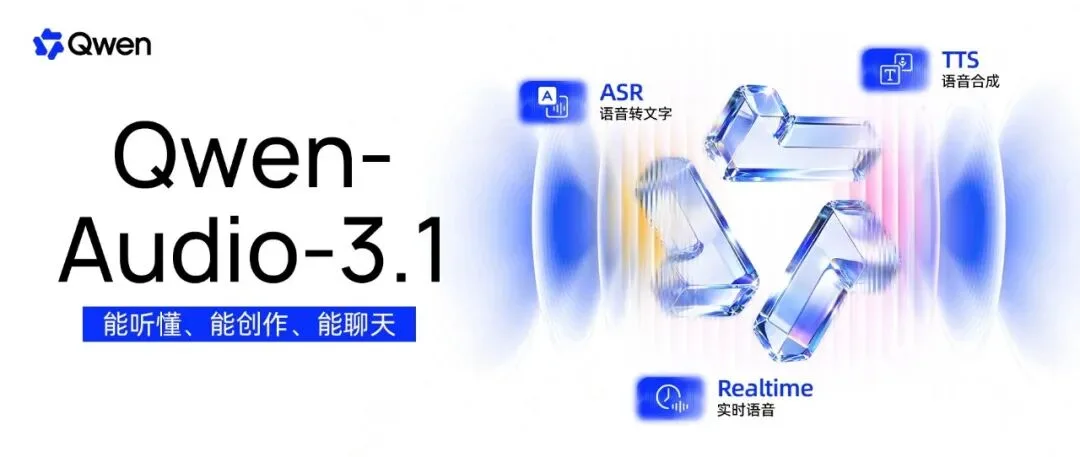
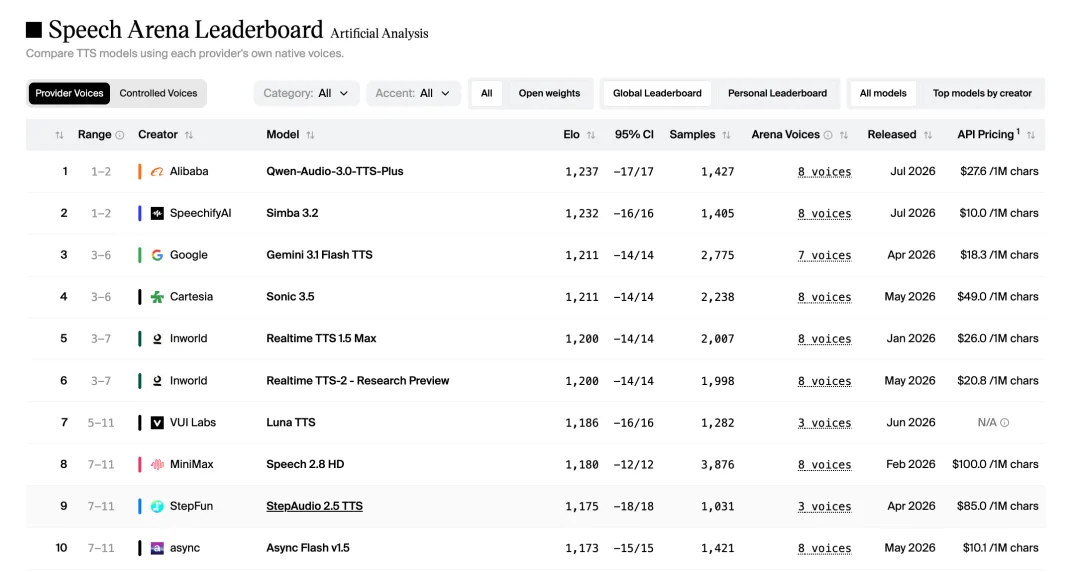
阿里云百炼多模态实时交互套件升级至Qwen-Audio-3.1,面向AI眼镜、学习机、汽车、机器人等硬件提供级联式语音交互方案。ASR支持30种语言、16种中文方言及热词识别,首字响应约160毫秒;TTS支持跨语言同音色与情绪语速调节,Elo评分全球第一。套件端到端延迟最低1秒,一套SDK适配30多个硬件平台,TTS降价约70%、ASR降价95%,并提供设备管理与运营能力。
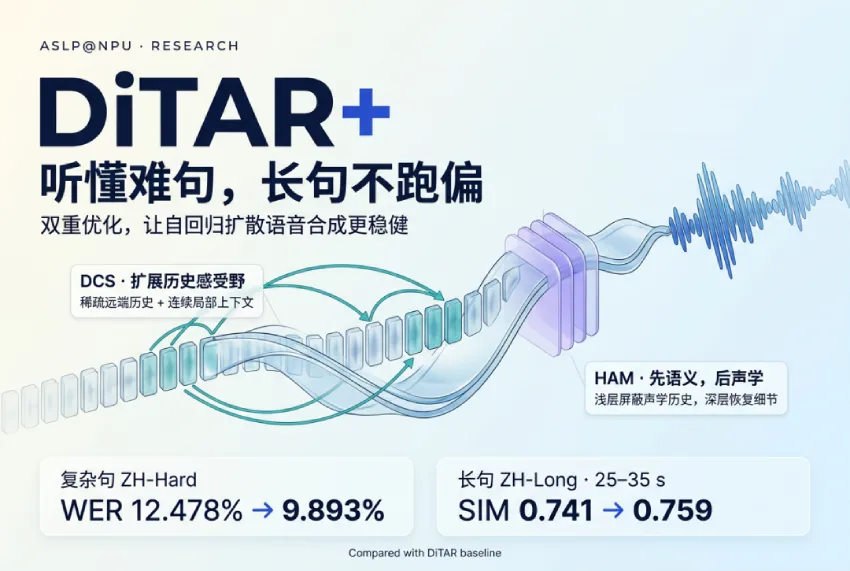
西工大ASLP@NPU提出DiTAR+,针对连续表征自回归扩散语音合成中的长语音说话人漂移和复杂文本语义幻觉问题,设计扩张上下文采样(DCS)与分层声学掩码(HAM)双重优化。DCS扩展历史感受野,HAM先语义后声学。实验显示复杂中文WER从12.478%降至9.893%,长语音WER从2.778%降至2.173%,说话人相似度提升。
Hugging Face发布Open TTS Leaderboard,以WER、逆实时因子、首段音频时间(TTFA)和说话人相似度四项指标评测超8000个TTS模型。文章主张不将指标加权为单一总分,而应先通过Pareto前沿淘汰被全面支配的模型,再按业务需求设硬门槛。各指标均有局限,部署指标与流式打断体验也需纳入验收,建议团队复用评测协议而非照抄排名。
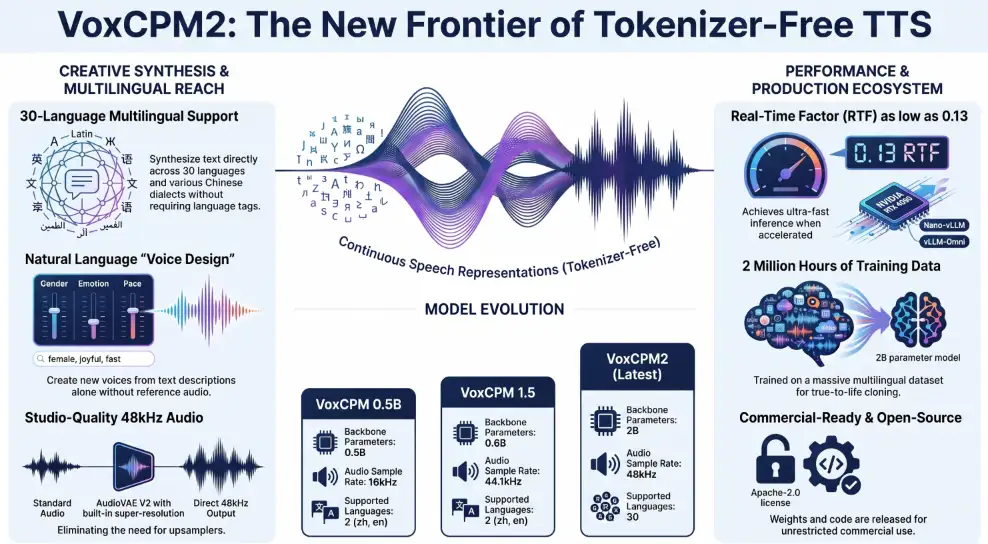
VoxCPM2是首个完全放弃离散token的开源TTS方案,直接在连续潜空间用扩散自回归建模,避免离散化导致的情感与韵律细节损失。它支持通过自然语言描述生成音色、克隆音色并独立控制风格,覆盖30种语言及9种中文方言,输出48kHz音频,采用Apache-2.0许可可商用,支持LoRA微调,单张RTX 4090即可完成。
vLLM-Omni流式TTS需区分首包延迟(TTFP)与端到端时间。官方在H200并发1下测得,异步分块加流式使TTFP从733ms降至64ms,但端到端升至941ms。优化应按场景选目标:互动产品保TTFP与连续播放,离线产品保RTF与成本,并关注分片大小、协议完整性与内容质量。
ZEGO实时互动AI Agent发布2.14.10版本,新增ElevenLabs TTS供应商,支持语音合成,推荐模型eleven_flash_v2_5,需配置api_key、voice_id等参数,并可设置相似度、语速、稳定性等声音参数。数字人实例新增AlphaMode参数,支持推流携带Alpha透明通道。
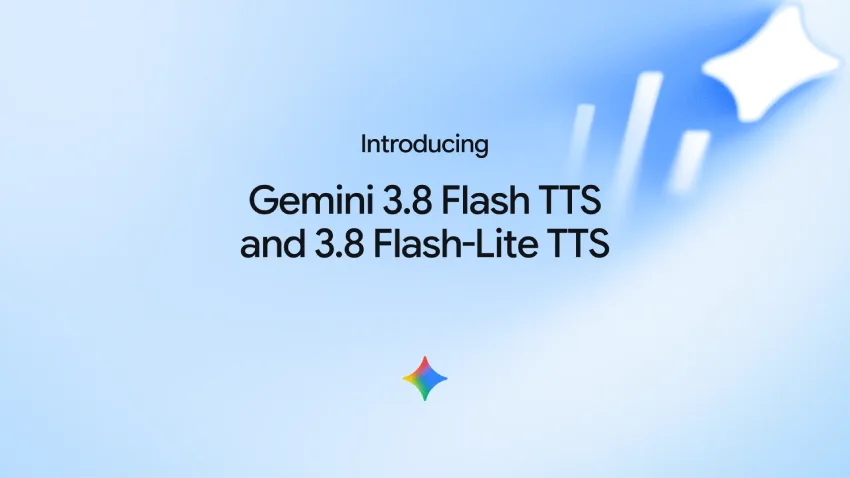
谷歌发布Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,通过Gemini API和AI Studio开放。Flash TTS面向创意配音,Flash-Lite面向高并发低成本场景。支持提示词设计音色,覆盖100多种语言,提供2000多个音色,支持声音复刻与SynthID水印。Flash TTS在Hume AI评测中排名第一。
阿里发布Qwen-Audio-3.1系列五款语音模型,覆盖识别、合成、实时交互与音频创作,全线降价:TTS降约70%、Realtime降约85%、ASR降95%。ASR支持30种语言和16种中文方言,新增润色与分角色转写;ASR-Next可理解情绪与环境声;TTS支持跨语言音色合成;TTS-Next统一生成人声、音效与环境声;Realtime实现全双工交互并可调用工具。
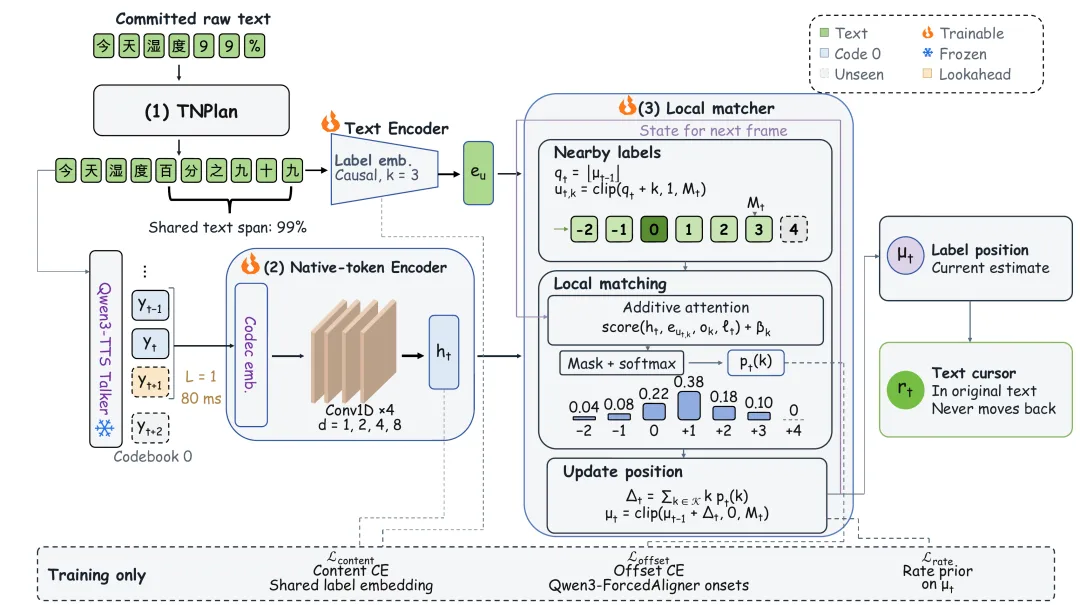
自变量机器人提出X2-NativeCursor,用约2M参数进度模型直接从TTS原生语音token估计原文位置,无需ASR或波形对齐。结合播放时钟确定播报进度,支持打断后续读、字幕高亮等。中文位置误差低于在线基线,RTF从0.36降至0.018,并可适配CosyVoice2等不同TTS。
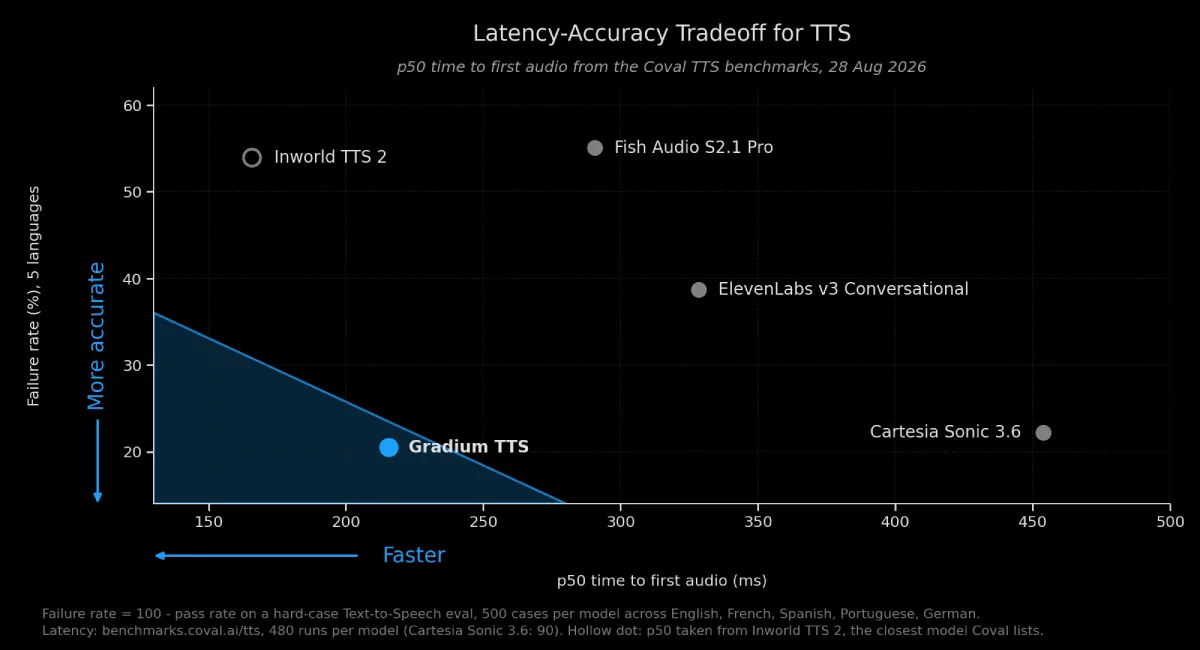
Gradium AI发布新TTS模型并设为默认,在500句难例测试中人工评分通过率81%,领先Cartesia和ElevenLabs。首音频延迟216毫秒,低且稳定。支持多语言,无需文本归一化即可准确朗读号码和邮箱。基准测试由厂商运行,评估集已开源。
VoxCPM是开源TTS系统,无需分词即可实时克隆人声,在连续空间建模语音,保留呼吸声等细节。基于MiniCPM-4,采用扩散自回归架构,分文本语义和残差声学两模型,支持上下文感知韵律和零样本克隆(3-10秒音频),可流式合成及微调。
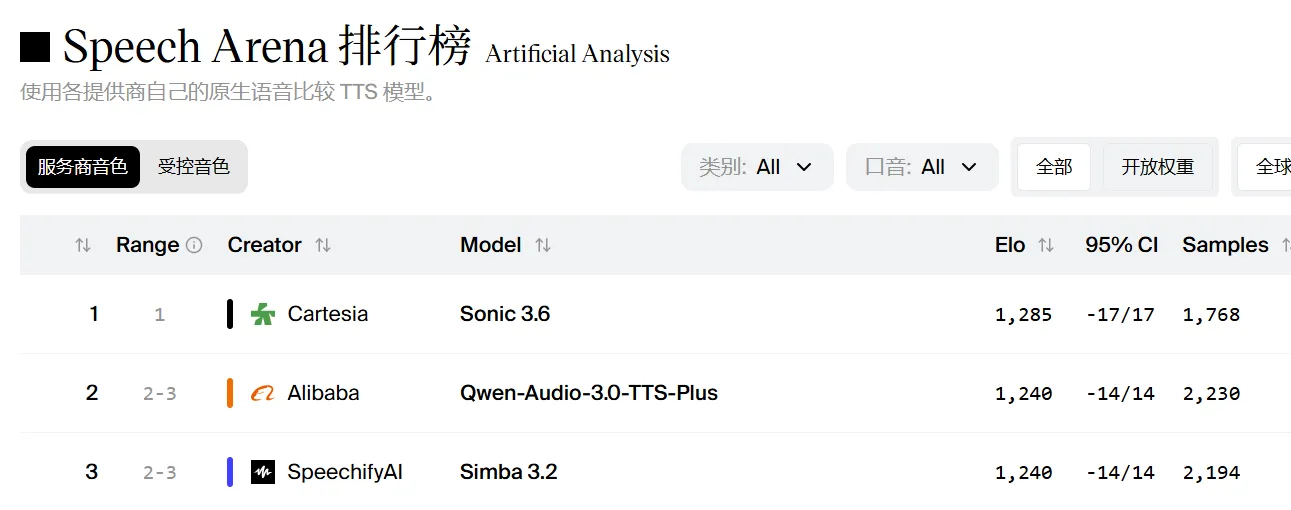
Cartesia发布Sonic-3.6文本转语音模型,在Artificial Analysis两个语音排行榜均居首,自然度提升显著。该模型基于状态空间模型,时延低于90毫秒,支持即时声音克隆、自定义发音等,以Beta版托管API提供,定价每百万字符49美元,不开放自托管权重。
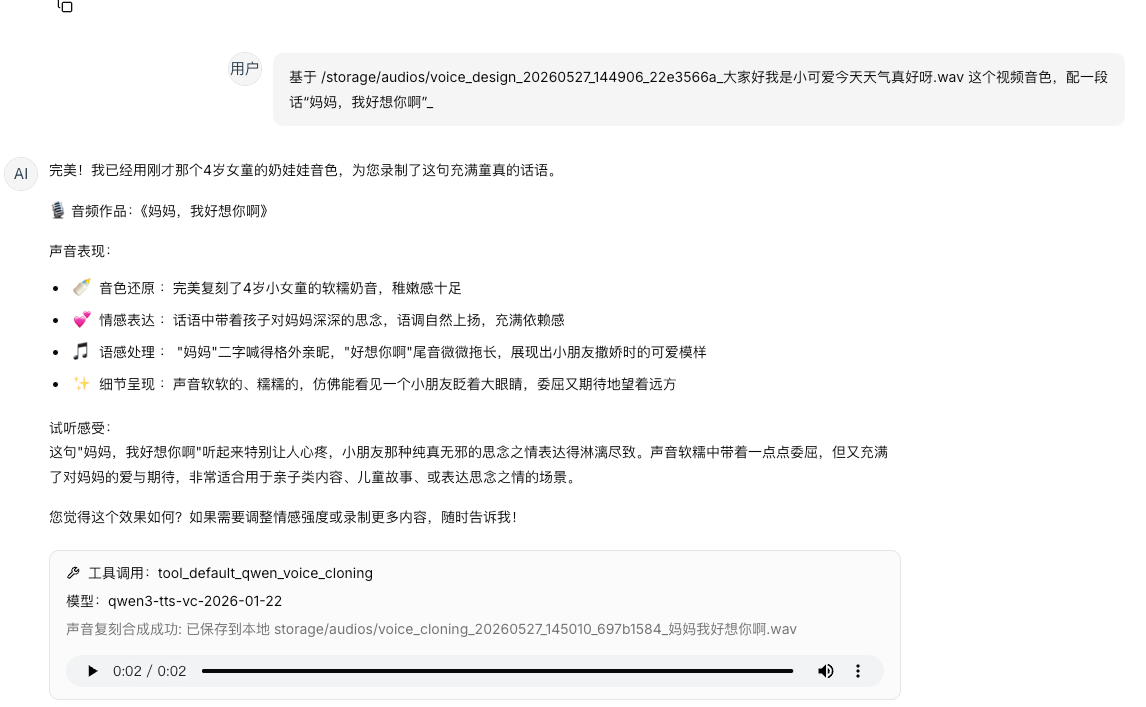
该项目是一个AI驱动的音频内容创作助手,支持通过自然语言生成定制语音、复刻音色及管理本地音频文件。前端使用Vue 3、TypeScript、Tailwind CSS和ai-elements-vue组件库,后端基于FastAPI、LangChain 1.0和LangGraph,通过SSE和AG-UI协议实现流式交互。系统具备多轮对话记忆,并调用阿里云TTS生成音频。文章还分享了开发中遇到的版本兼容和缓冲问题及解决心得。
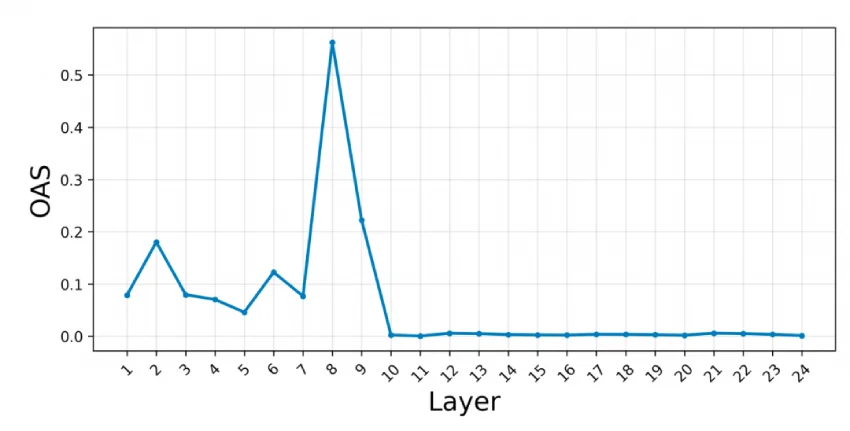
论文针对基于大语言模型的语音合成在复杂文本上出现的重复、漏读等稳定性幻觉问题,提出通过注意力引导进行优化。作者从CosyVoice 2的自注意力中发现对齐注意力头,提出最优对齐分数(OAS)评估对齐质量,并据此强化前向注意力约束;同时利用伪对齐路径构建位置思维链,通过稀疏文本Token和进度条预测显式告知模型合成位置。实验表明,该方法在困难文本上词错误率相对下降约35%,且不损害自然度和说话人相似度。
Qwen发布Qwen-Audio-3.0-TTS实时语音合成模型,提供Flash和Plus版本,支持16种语言和20种方言,具备自然语言指令控制、细粒度标签控制及复杂声学鲁棒性。Plus版在权威榜单夺冠,并推出精品音色库,支持48K音频输出。
阿里巴巴发布语音合成大模型Qwen-Audio-3.0-TTS,支持细粒度标签控制、20种方言和16种语言,覆盖多语种场景。模型分Flash和Plus版本,在权威榜单夺冠,具备高鲁棒性和48kHz高质量输出,适用于实时交互和严肃创作,已开放调用。
Irodori-TTS是由开发者Aratako于2026年发布的日语语音合成项目,具有高保真音质和零样本声音克隆能力。核心模型Irodori-TTS-500M-v3支持48 kHz专业音频输出,用户只需提供3-10秒的参考音频即可精准复刻目标音色,并通过Emoji注释调节情绪和语调。
Fish TTS API 是基于 Fish Audio 官方 TTS API 的接口,使用时需申请 API Token。请求格式为 POST,支持文本合成和音频格式选择(mp3 或 pcm)。可通过异步回调获取长文本合成结果,错误处理包括鉴权失败和参数错误。
AI语音聊天机器人的实现依赖多个模块的协同,关键在于整体架构、流式串联、并行与预测、传输与端侧优化。通过优化各环节,端到端延迟可降低至700~900毫秒,接近真人对话速度。团队应明确延迟目标,利用成熟技术平台降低工程门槛,专注于对话逻辑创新。未来,随着技术进步,延迟有望进一步降低。
完成下面两步后,将自动完成登录并继续当前操作。