小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
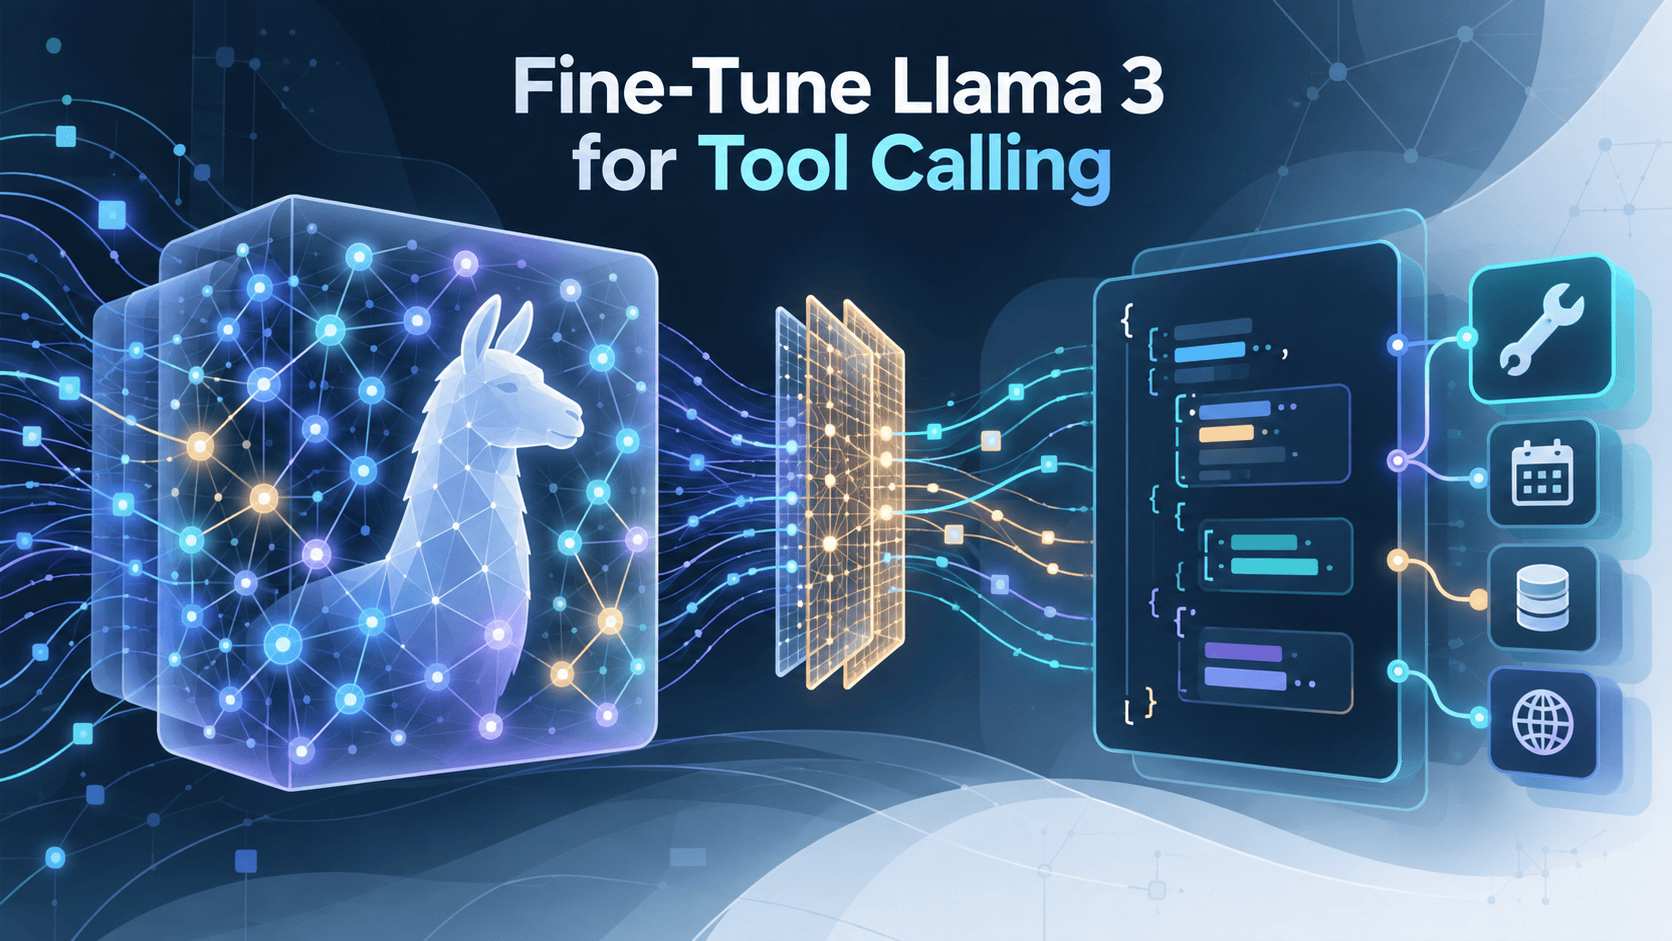
如何在Python中使用Unsloth微调Llama 3以实现自定义工具调用

本文介绍用Unsloth和QLoRA微调Llama 3 8B以实现自定义工具调用。仅靠提示工程难以稳定输出JSON,微调可从权重层面改变模型行为。教程涵盖在免费Colab T4上搭建环境、加载4位量化模型、配置LoRA适配器、构建含系统提示、用户查询和JSON输出的数据集,并用SFTTrainer训练。约10分钟完成,模型能对未见查询返回干净JSON,最后保存适配器。

如何在Python中使用Unsloth微调Llama 3以实现自定义工具调用

MachineLearningMastery.com MachineLearningMastery.com · 2026-10-09T11:00:00Z
Kimi K3本地使用版(1.56TB → 594GB),由Unsloth压缩并发布

Unsloth团队将Kimi K3模型从1.56TB压缩至594GB,体积缩小近三倍,最小版本保留78.9%准确率。量化技术降低参数存储位数,使顶级模型可在个人电脑运行。文章还讨论剪枝技术、显存焦虑及低成本部署梦想,推动压缩技术发展,让AI从奢侈品变为消费品。

Kimi K3本地使用版(1.56TB → 594GB),由Unsloth压缩并发布

极道 极道 · 2026-07-29T23:21:00Z

本文介绍了如何使用Unsloth Studio合并语言模型。Unsloth Studio是一个无代码的本地界面,支持多种流行模型。合并模型可以结合不同适配器的优点,提升AI性能。主要合并方法包括SLERP(平滑合并)、TIES(解决冲突)和DARE(减少冗余参数)。合并过程简单明了,适合AI从业者使用。

使用Unsloth Studio合并语言模型

KDnuggets KDnuggets · 2026-04-20T14:00:24Z
模块化:如何在没有GPU经验的情况下,使用Mojo击败Unsloth的CUDA内核

一位Mojo社区成员利用AI在Mojo中解决了量化挑战,其速度比C++/CUDA实现快1.07到1.84倍。Mojo简化了GPU编程,适合开发者使用。

模块化:如何在没有GPU经验的情况下,使用Mojo击败Unsloth的CUDA内核

Modular Blog Modular Blog · 2026-01-14T00:00:00Z
模块化:我如何在没有任何GPU经验的情况下,使用Mojo击败Unsloth的CUDA内核

我参加了一个量化挑战,使用Mojo编程,结果比C++/CUDA实现快1.07到1.84倍。Mojo简化了GPU编程,适合开发者尝试。

模块化:我如何在没有任何GPU经验的情况下,使用Mojo击败Unsloth的CUDA内核

Modular Blog Modular Blog · 2026-01-12T00:00:00Z
文心大模型牵手Unsloth,消费级硬件也能微调文心多模态大模型!

文心大模型与Unsloth合作,发布多个微调教程。Unsloth是一个开源框架,专注于大语言模型的微调和强化学习,提升训练速度并降低资源需求。此次合作支持ERNIE-4.5及PaddleOCR-VL模型的微调,并提供详细实操指南,帮助开发者快速上手。

文心大模型牵手Unsloth,消费级硬件也能微调文心多模态大模型!

百度大脑 百度大脑 · 2025-12-26T14:35:17Z
如何在自己的数据集上微调本地Mistral或Llama 3模型

本文介绍了如何使用Unsloth和QLoRA微调开源大语言模型,以提升客户支持效率。内容包括数据集准备、训练、测试和比较。通过微调,模型在特定领域的响应速度和一致性显著提高。教程涵盖Colab环境设置、数据集准备、模型训练及性能评估等步骤。

如何在自己的数据集上微调本地Mistral或Llama 3模型

MachineLearningMastery.com MachineLearningMastery.com · 2025-12-19T09:00:17Z
如何在NVIDIA GPU上使用Unsloth微调大型语言模型

Unsloth利用NVIDIA RTX AI PC和DGX Spark加速流行AI模型的微调,构建个性化助手。微调方法包括参数高效微调、完全微调和强化学习,适用于不同任务。新发布的Nemotron 3系列模型高效准确,适合代理AI应用,DGX Spark则提供强大的本地微调能力,支持更大模型和复杂任务。

如何在NVIDIA GPU上使用Unsloth微调大型语言模型

NVIDIA Blog NVIDIA Blog · 2025-12-15T14:00:11Z
Unsloth教程旨在简化大型语言模型的比较与微调

Unsloth在Reddit上发布了全面的开源模型教程,涵盖Qwen、Kimi等模型的优缺点和性能基准,适合架构师和开发者。教程包括模型描述、使用案例,以及微调、量化和强化学习的指导,旨在简化模型的训练和使用。

Unsloth教程旨在简化大型语言模型的比较与微调

InfoQ InfoQ · 2025-08-16T09:00:00Z

GPU Mode Lecture 32: Unsloth

GPU Mode Lecture 32: Unsloth

Josherich的博客 Josherich的博客 · 2025-02-17T00:00:01Z
Unsloth AI:教程(Github:今日仅1874颗星)

Unsloth AI是一个开源框架,支持快速、低资源的LLM微调,速度提升2倍,内存使用减少80%。该框架优化了LoRA微调,适用于多种大型语言模型,适合研究人员和初创企业。

Unsloth AI:教程(Github:今日仅1874颗星)

DEV Community DEV Community · 2025-02-12T08:36:10Z

本文介绍了如何使用Unsloth库对DeepSeek模型进行微调,包括安装库、加载模型、应用LoRA适配器、准备数据集、格式化提示、配置训练器及训练过程。最后,提供了模型推理和保存步骤,并强调了微调大型语言模型的最佳实践。

如何针对您的自定义数据集逐步微调DeepSeek-R1

KDnuggets KDnuggets · 2025-02-03T15:00:49Z
使用Unsloth微调Llama 3.2

Unsloth是一个用户友好的框架,支持大语言模型的快速推理和微调,节省GPU内存。它能在旧GPU上实现类似ChatGPT的效果,并支持多种模型格式。本文介绍了如何使用Unsloth微调Llama 3.2模型,处理心理健康对话数据集,并将模型保存为GGUF格式。

使用Unsloth微调Llama 3.2

KDnuggets KDnuggets · 2024-10-24T12:00:41Z

产品语音校正技术不成熟,未成功。PopTranslate是首个可用产品,但成本高。unsloth和YouTube项目有良好开端。远程工作项目失败,安全投资项目问题多。需专注目标,深度阅读发现需求。unsloth是长期有价值项目。计划转向LLM项目,三个月后深入学习。下周计划包括YouTube视频、安全项目、PopTranslate及阅读写作练习。

两个月周报总结-第7期

informal informal · 2024-10-13T00:00:00Z

作者发现Chrome扩展被拒是因为API密钥被写入.gitignore,导致上传zip失败,谷歌团队邮件确认了该原因。他在Reddit发帖被封号,需养新号。学习了unsloth的快速交叉熵损失,理解了llm-accelerate项目原理:将通用代码和理论针对特定任务优化可提升训练效率。本周上传两个LeetCode视频,跑步五次,计划下周总结发布效果。

周报-#4 LLM加速的初步见解

informal informal · 2024-09-14T16:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码