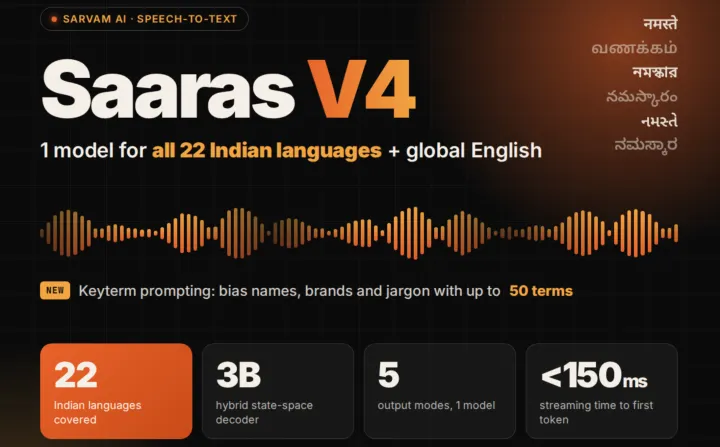
Sarvam AI 发布语音识别模型 Saaras V4,覆盖 22 种印度法定语言及全球英语口音,宣称均达最先进准确率。模型采用编码器-解码器架构,解码器为自研 30 亿参数混合状态空间模型。支持 5 种输出模式、最多 50 个关键词提示,流式首 token 时延低于 150 毫秒,定价 ₹30/小时。目前仅 API 可用,权重未公开,自托管仅支持 v3。所有数据均为厂商自报,尚无独立复现。
美光将向全球逾六万员工发放史上最高奖金,台湾员工最高获35至68个月薪资。美国司法部调查英伟达是否借Groq交易规避反垄断审查。黄仁勋称网络安全将成AI下一个重大市场。谷歌斥资超150亿美元在芬兰建AI基础设施。DeepSeek下调旗舰模型V4部分服务费,最高降幅60%,并筹备上海IPO。
深度求索原计划将DS V4 Pro请求自动路由至新上线的DS V4.1 Flash,因部分开发者反对,将V4 Pro下线时间从9月10日推迟至9月14日12:00,之后仍会强制路由,开发者需尽快适配。
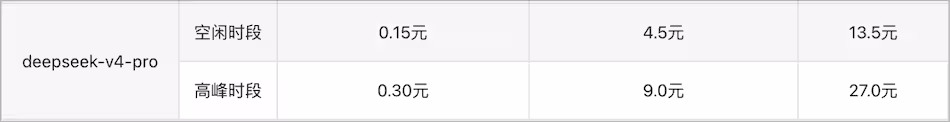
DeepSeek宣布自2026年9月10日起调整flash系列API定价,空闲时段输入缓存命中降至0.02元、未命中降至1元、输出降至4元,高峰时段为两倍。此次降价距8月涨价仅24天,降幅最高达60%,Pro版本价格保持不变。
深度求索宣布DS V4 Flash模型将于9月10日降价,缓存命中降幅60%,未命中降33%,输出仅降11%。相比8月17日涨价前,仅闲时缓存价格持平,其他模式仍贵100%至300%,整体降幅有限。
DeepSeek-V4模型采用混合压缩注意力(mHC),将KV缓存分为状态缓存和分页缓存,分别管理滑窗KV与压缩条目。上下文并行通过点对点通信和all-gather处理跨rank压缩窗口。磁盘前缀缓存中,压缩条目易存,滑窗KV需重算或周期检查点。mHC通过融合内核、重算和DualPipe优化,将访存开销压至6.7%。
DeepSeek-V4采用Muon优化器,通过谱范数最速下降实现逐矩阵正交化,用Newton-Schulz迭代逼近SVD,混合系数提升小奇异值并精确稳定大值。RMS匹配对齐AdamW,部分参数仍用AdamW。Q/KV归一化替代QK-Clip防logit爆炸,Anticipatory Routing打断MoE路由正反馈,MTP预测多token,训练配方含32T token等细节。
本文介绍DeepSeek-V4模型结构中MoE层的四处改动:路由打分从sigmoid改为sqrt(softplus)以消除饱和;前三层用固定hash routing替代稠密层;增加极小序列级平衡损失;SwiGLU加硬截断防离群值。模型采用FP4量化,61层全MoE,每token激活6个expert,稀疏度64,总参数约49B。
该文详解DeepSeek-V4的mHC残差结构:将单条残差流拓宽为4条,通过读、写、混三算子连接子层。为保稳定,混合矩阵被约束为双随机矩阵(非负、行和列和均为1),经Sinkhorn-Knopp迭代投影实现,使复合映射增益从3000降至1.6。初始化时等价于普通Transformer,参数量仅占0.005%,带来推理性能提升,并与Kimi K3的Attention Residuals形成对比。
本文详解DeepSeek-V4模型结构:HCA将128个token压缩为一条目,无需稀疏选择;CSA与HCA交错排布,确保全局信息不丢失;滑窗分支弥补压缩导致近token不可见;Q/KV归一化替代QK-Clip;部分RoPE加输出反旋转消除绝对位置;attention sink解决softmax权重分配缺陷;1M上下文KV cache仅5.3GiB,FLOPs约38G。
本文介绍DeepSeek-V4模型中的压缩稀疏注意力(CSA)机制。KV缓存每4个token压缩为一条,1M上下文仍有26万条目,故用lightning indexer打分选择top-1024块。Indexer源自V3.2的DSA,采用64头128维、ReLU加权和FP4量化,通过KL散度模仿主注意力分布训练。V4将索引对象从token改为压缩块,query共享低秩latent。文章详述了indexer实现细节、一层CSA的完整维度流程及参数统计。
本文介绍DeepSeek-V4的注意力机制,从MHA到CSA/HCA的演进,重点分析压缩KV缓存的方法。V4将每4或128个token压缩为一条512维KV向量,采用重叠窗口和逐通道softmax加权,K与V共享单头,配合分组输出投影降低参数。相比前代,V4首次压缩缓存条目数,以支持1M上下文的高效推理。
本文介绍DeepSeek-V4模型架构:Pro版总参数1.6T、61层,Flash版284B、43层,均采用4条残差流、交错CSA/HCA压缩注意力与MoE结构。相比V3.2,推理FLOPs降至27%、KV缓存仅10%。文章提供层排布、维度对照表及参数明细,并预告后续将分篇详解各模块设计。
DeepSeek V4 Flash通过Autoprompt自动生成提示词,在Terminal-Bench 2.1测试中完成率从67.42%升至82.02%,提升14.61个百分点。Autoprompt规划、构建、测试、审查、修复提示词,减少人工翻译意图的循环,但耗时增3倍、Token翻倍。官方82.7分因框架不同不可直接比较,提升稳定性待验证。
DeepSeek宣布V4系列API新定价,采用峰谷错峰计价:高峰时段(9-12点、14-18点)价格翻倍,空闲时段减半。V4-Pro转正式商用,两款模型支持384K上下文及多种功能,旨在调节算力负载,提升服务稳定性。
作者使用DeepSeek V4 Pro改进PHP扩展Yaconf,实现子目录支持和compact存储。V4 Pro速度快、理解力强,但稳定性差:Edit失败超百次,一次git操作丢失核心代码,上下文压缩后遗忘决策。性能实测随机访问提升40%,内存降16%。作者认为V4 Pro虽快,但当前国内模型中Qwen3.8更稳妥。
AMD MI300X显卡成功运行3040亿参数的DeepSeek V4 Flash模型,实测单流解码168.6 tok/s,总吞吐达830 tok/s。但部署过程充满挑战,需修复FP8格式不兼容、MoE路由错误等问题,显存使用接近极限,系统脆弱,仅适合技术验证,不适合生产环境。
DeepSeek V4 Flash以极低价格提供高性能,7分钱生成3D游戏,5毛钱完成CS任务,性能接近Opus 4.8,成本仅为顶尖模型的百分之一。海外平台争相加码补贴,开发者大量使用,推动开源模型普及。文章认为这标志着AI应用黄金时代开启,并预告DeepSeek Code编程工具即将推出。
DeepSeek-V4-Flash正式版发布一周内登顶全球大模型调用量榜首,周调用量达7.1万亿Token,中国模型包揽前五。其Agent能力大幅提升,价格极低,单任务成本仅3美分,吸引海外开发者迁移,推理成本降60%-85%。分析认为,中国AI以性能与价格优势改写全球市场规则,冲击美国头部模型。
Reddit用户用24GB显存和96GB内存的电脑成功运行DeepSeek-V4-Flash-0731,引发硬件门槛讨论。量化技术和开源社区推动本地AI普及,虽速度慢且成本高,但提供隐私和掌控感。对比云服务,本地运行代表技术民主化趋势,未来可能成为主流。
完成下面两步后,将自动完成登录并继续当前操作。