本文介绍用PostgreSQL逻辑复制将多个数据库整合到单一数据仓库。每个应用在源端有独立schema,仓库按应用建schema并各建一个订阅。由于订阅无法重命名表,命名须在源端完成。Postgres 15的列清单和行过滤器可排除敏感字段与无关租户数据,但过滤器仅对之后变更生效。DDL和序列不会复制,需手动处理;可用队列表加触发器模拟pglogical的DDL复制。Postgres 16支持从物理备库解码,减轻主库负担。
Postgres 可能因代价估算的微小波动为同一查询选择截然不同的执行计划,导致堆块访问从 73 暴增至 3449。作者用 ExoBench 在合成 FEC 数据上复现了这一“计划抛硬币”现象,发现两索引方案不稳定。最终通过创建单个多列 GIN 索引(结合 btree_gin 与 pg_trgm)将交集下推到索引内部,消除规划器决策,使查询从 193.8 毫秒降至 0.76 毫秒。
ClickHouse Managed Postgres 备份使用 Direct I/O 绕过页缓存,避免驱逐数据库热数据,并减少内核拷贝与 CPU 开销。但 Direct I/O 失去预读,在 RAID0 上小读仅占用单盘。按磁盘数将读放大到整条条带(如 4 MiB),并根据硬件调整并发读者数,可恢复吞吐。实测备份延迟从基线的 4.7 倍降至 1.5 倍,CPU 节省约 14%。
本文介绍在Azure RHEL9虚拟机上,将JFrog Artifactory与富士通企业版PostgreSQL集成,并启用透明数据加密(TDE)保护Artifactory元数据,涵盖安装配置Artifactory、部署数据库、设置加密表空间与密钥库、创建用户数据库及扩展磁盘分区等步骤。
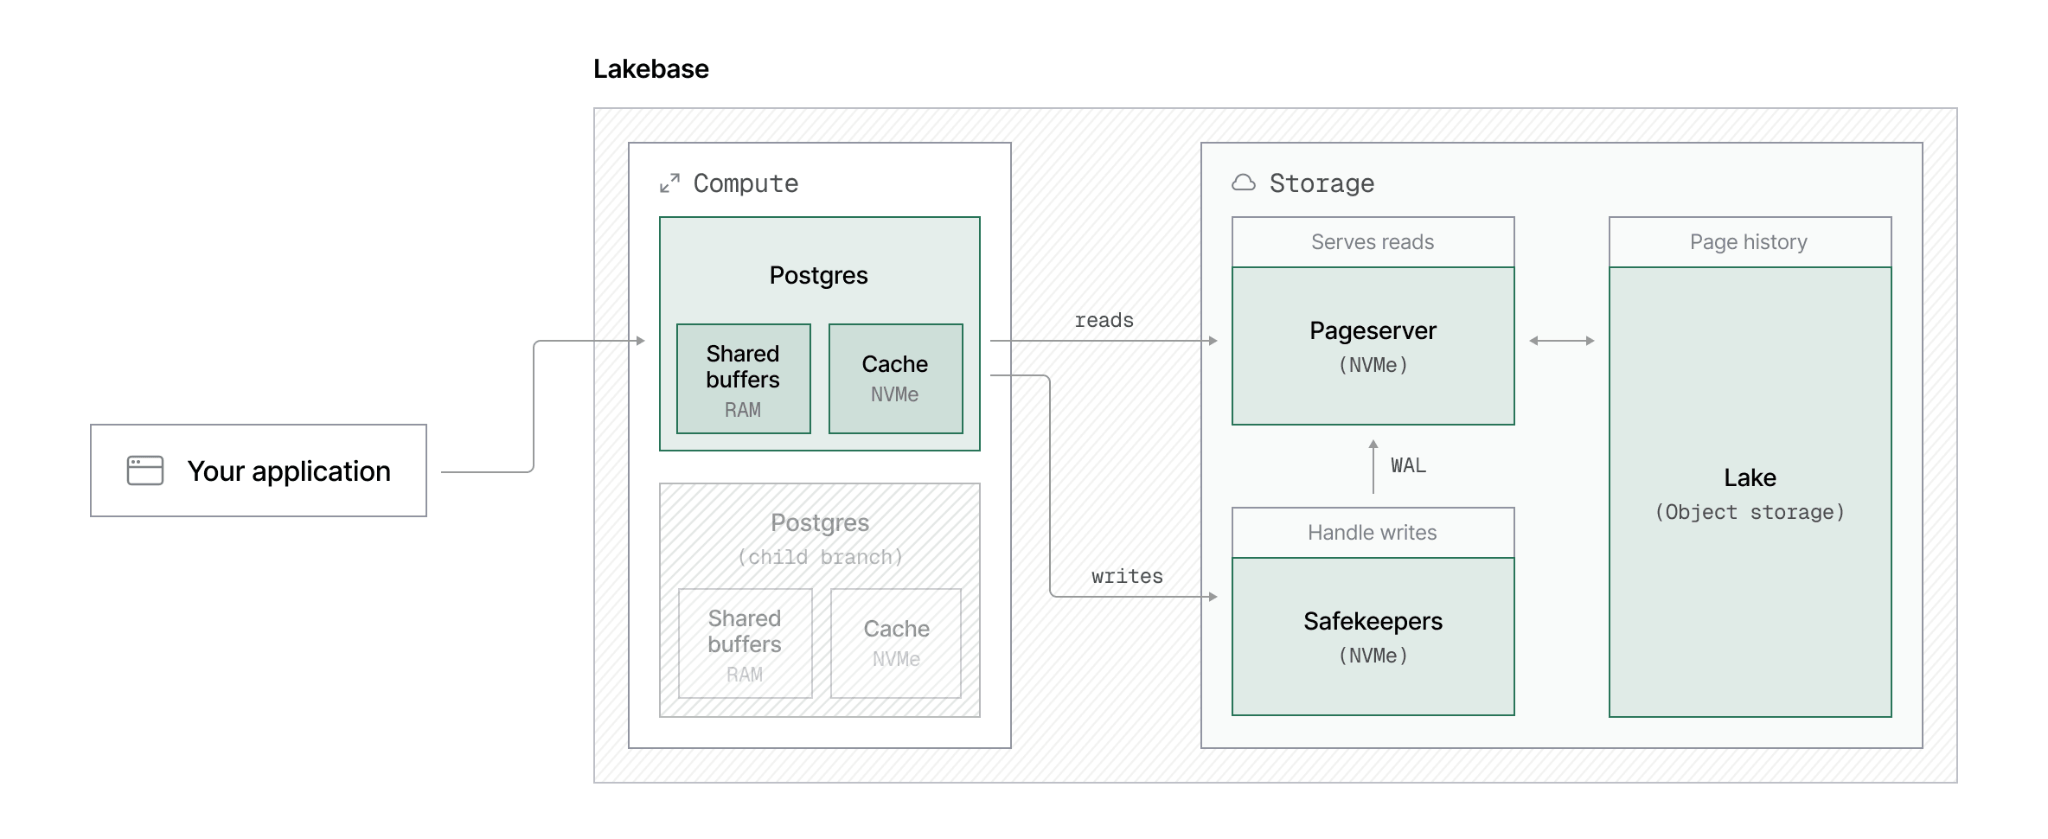
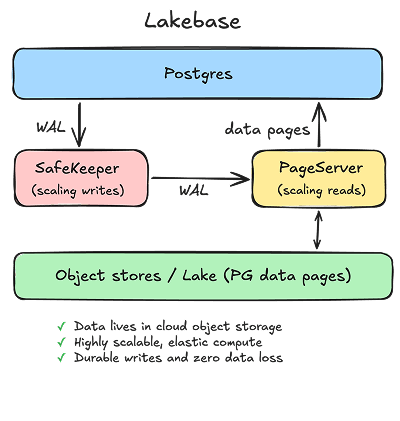
Lakebase Postgres 采用计算与存储分离架构,数据历史存于对象存储,恢复时按时间戳创建分支,无需复制数据或重放 WAL。分支恢复仅需数秒,即使 100TB 数据库也一样,而传统托管 Postgres 恢复需数小时。该机制支持代理自动执行,可用于实时版本控制和撤销。
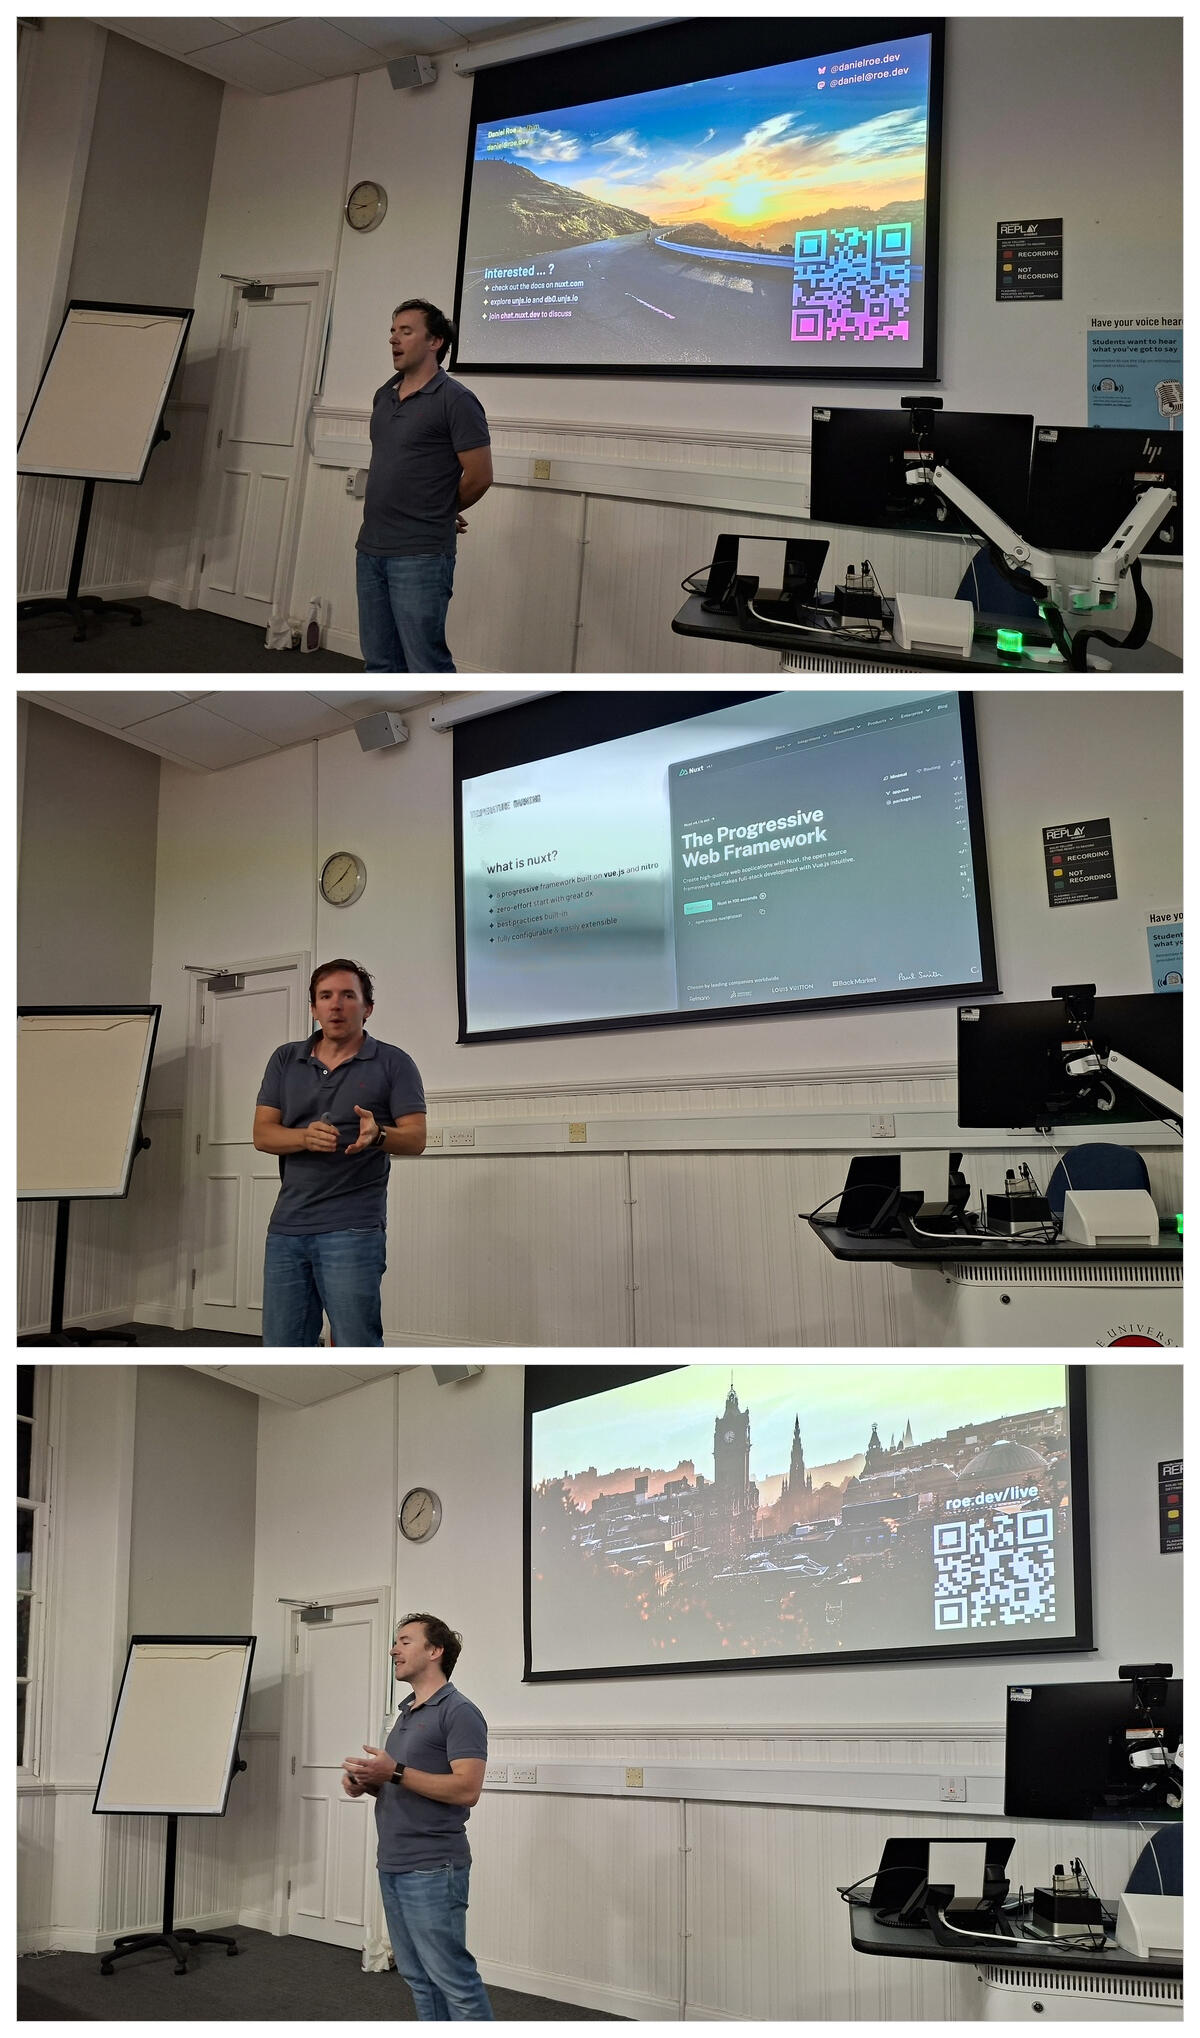
2026年9月Postgres EDI聚会回顾:Jimmy Angelakos介绍ColdFront,可将Postgres冷数据以Iceberg表存至对象存储,仍可从Postgres查询,并用TLA+建模多节点写入协议。Daniel Roe展示Nuxt、Nitro与db0连接Postgres并现场编码,还谈开源渐进采用与团队协作。下次10月15日由Snowflake的Elizabeth Garrett Christensen讲Postgres 19新特性。
多租户SaaS使用PostgreSQL队列时,FIFO会导致大租户的千个任务阻塞其他租户,小租户中位等待4.5秒。改用按租户轮询后等待降至0.1秒,但按id排序在积压不均时会走全表,单次出队耗时10秒。改为按(tenant_id, enqueued_at, id)部分索引排序可降至1毫秒级。
实测PostgreSQL 17多租户审计日志触发器开销:2万次单行更新每次增加32微秒;10万行批量更新慢3.6至4.4倍。语句触发器配转换表比行触发器快约两成,但仅限AFTER且不能指定列。只存变更列可使日志缩小五倍,但比较更耗CPU。用行级安全策略限制租户只能读自己的日志,应用角色仅可SELECT和INSERT,日志追加不可改。
实测 PostgreSQL 17 行级安全策略的性能开销:简单等值策略几乎无成本;调用 PL/pgSQL 等不可内联函数的策略会退化为全表扫描,耗时近 2 秒;成员子查询策略每查询约 80 毫秒。lower()、LIKE 等非 leakproof 函数会阻止索引使用,使大租户查询从 0.2 毫秒增至 45 毫秒。建议将辅助函数声明为 STABLE PARALLEL SAFE,使用生成列或 leakproof 操作符,并提前解析租户归属。
PostgreSQL 19 将新增查询提示功能,通过 pg_plan_advice 等扩展模块,用户可指定连接顺序、扫描方式和索引,覆盖优化器默认计划。该功能适用于无法修改的查询或函数估算错误场景,但官方提醒优化器通常正确,应优先分析表和调优索引,提示仅按查询 ID 精准使用,并常检查执行计划。
Lakebase 是基于存算分离架构的托管 Postgres,成本优势显著。数据库分支共享存储,适合短期开发测试;自动扩缩容可按需调整算力,配合缩容至零可进一步降本。读写分离与高可用无需复制存储。同步表应只同步活跃子集,并按需选择快照、触发或连续模式。合理配置计算规格、连接池和恢复窗口,可避免资源浪费。
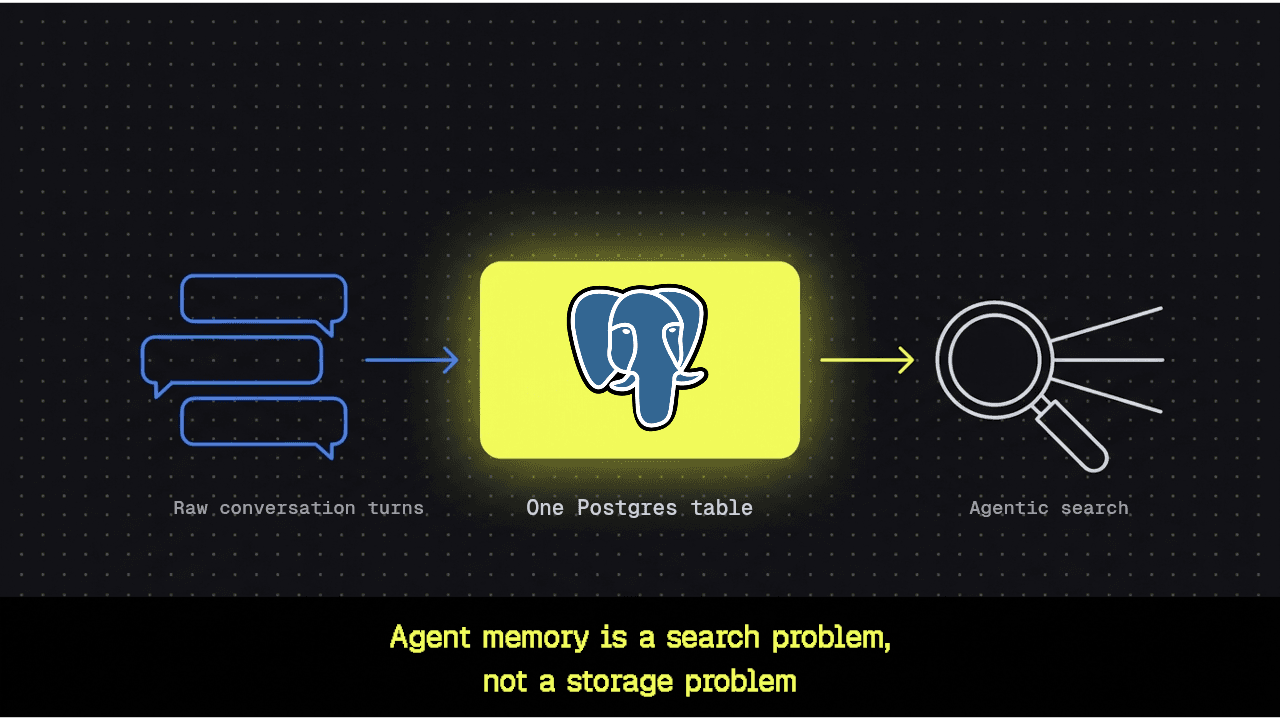
文章主张AI智能体的记忆本质是搜索问题而非存储问题。作者仅用单个Postgres表和三个搜索工具,在LoCoMo测试中取得F1 0.665,无需事实提取、知识图谱或记忆管理器。六天内进行41次实验,将F1从0.392提升至0.666,其中Claude负责写代码,人类负责识别失真的指标。
本文介绍用Go构建小型湖仓引擎,模仿DuckLake架构:元数据存于Postgres,数据用Parquet。核心是八张元数据表,涵盖快照、表、列、数据文件、列统计、删除文件等。通过begin_snapshot和end_snapshot实现快照可见性与时间旅行。相比Iceberg的清单文件树,数据库方案让文件裁剪变成SQL查询,原子提交只需事务,但依赖运行中的数据库。
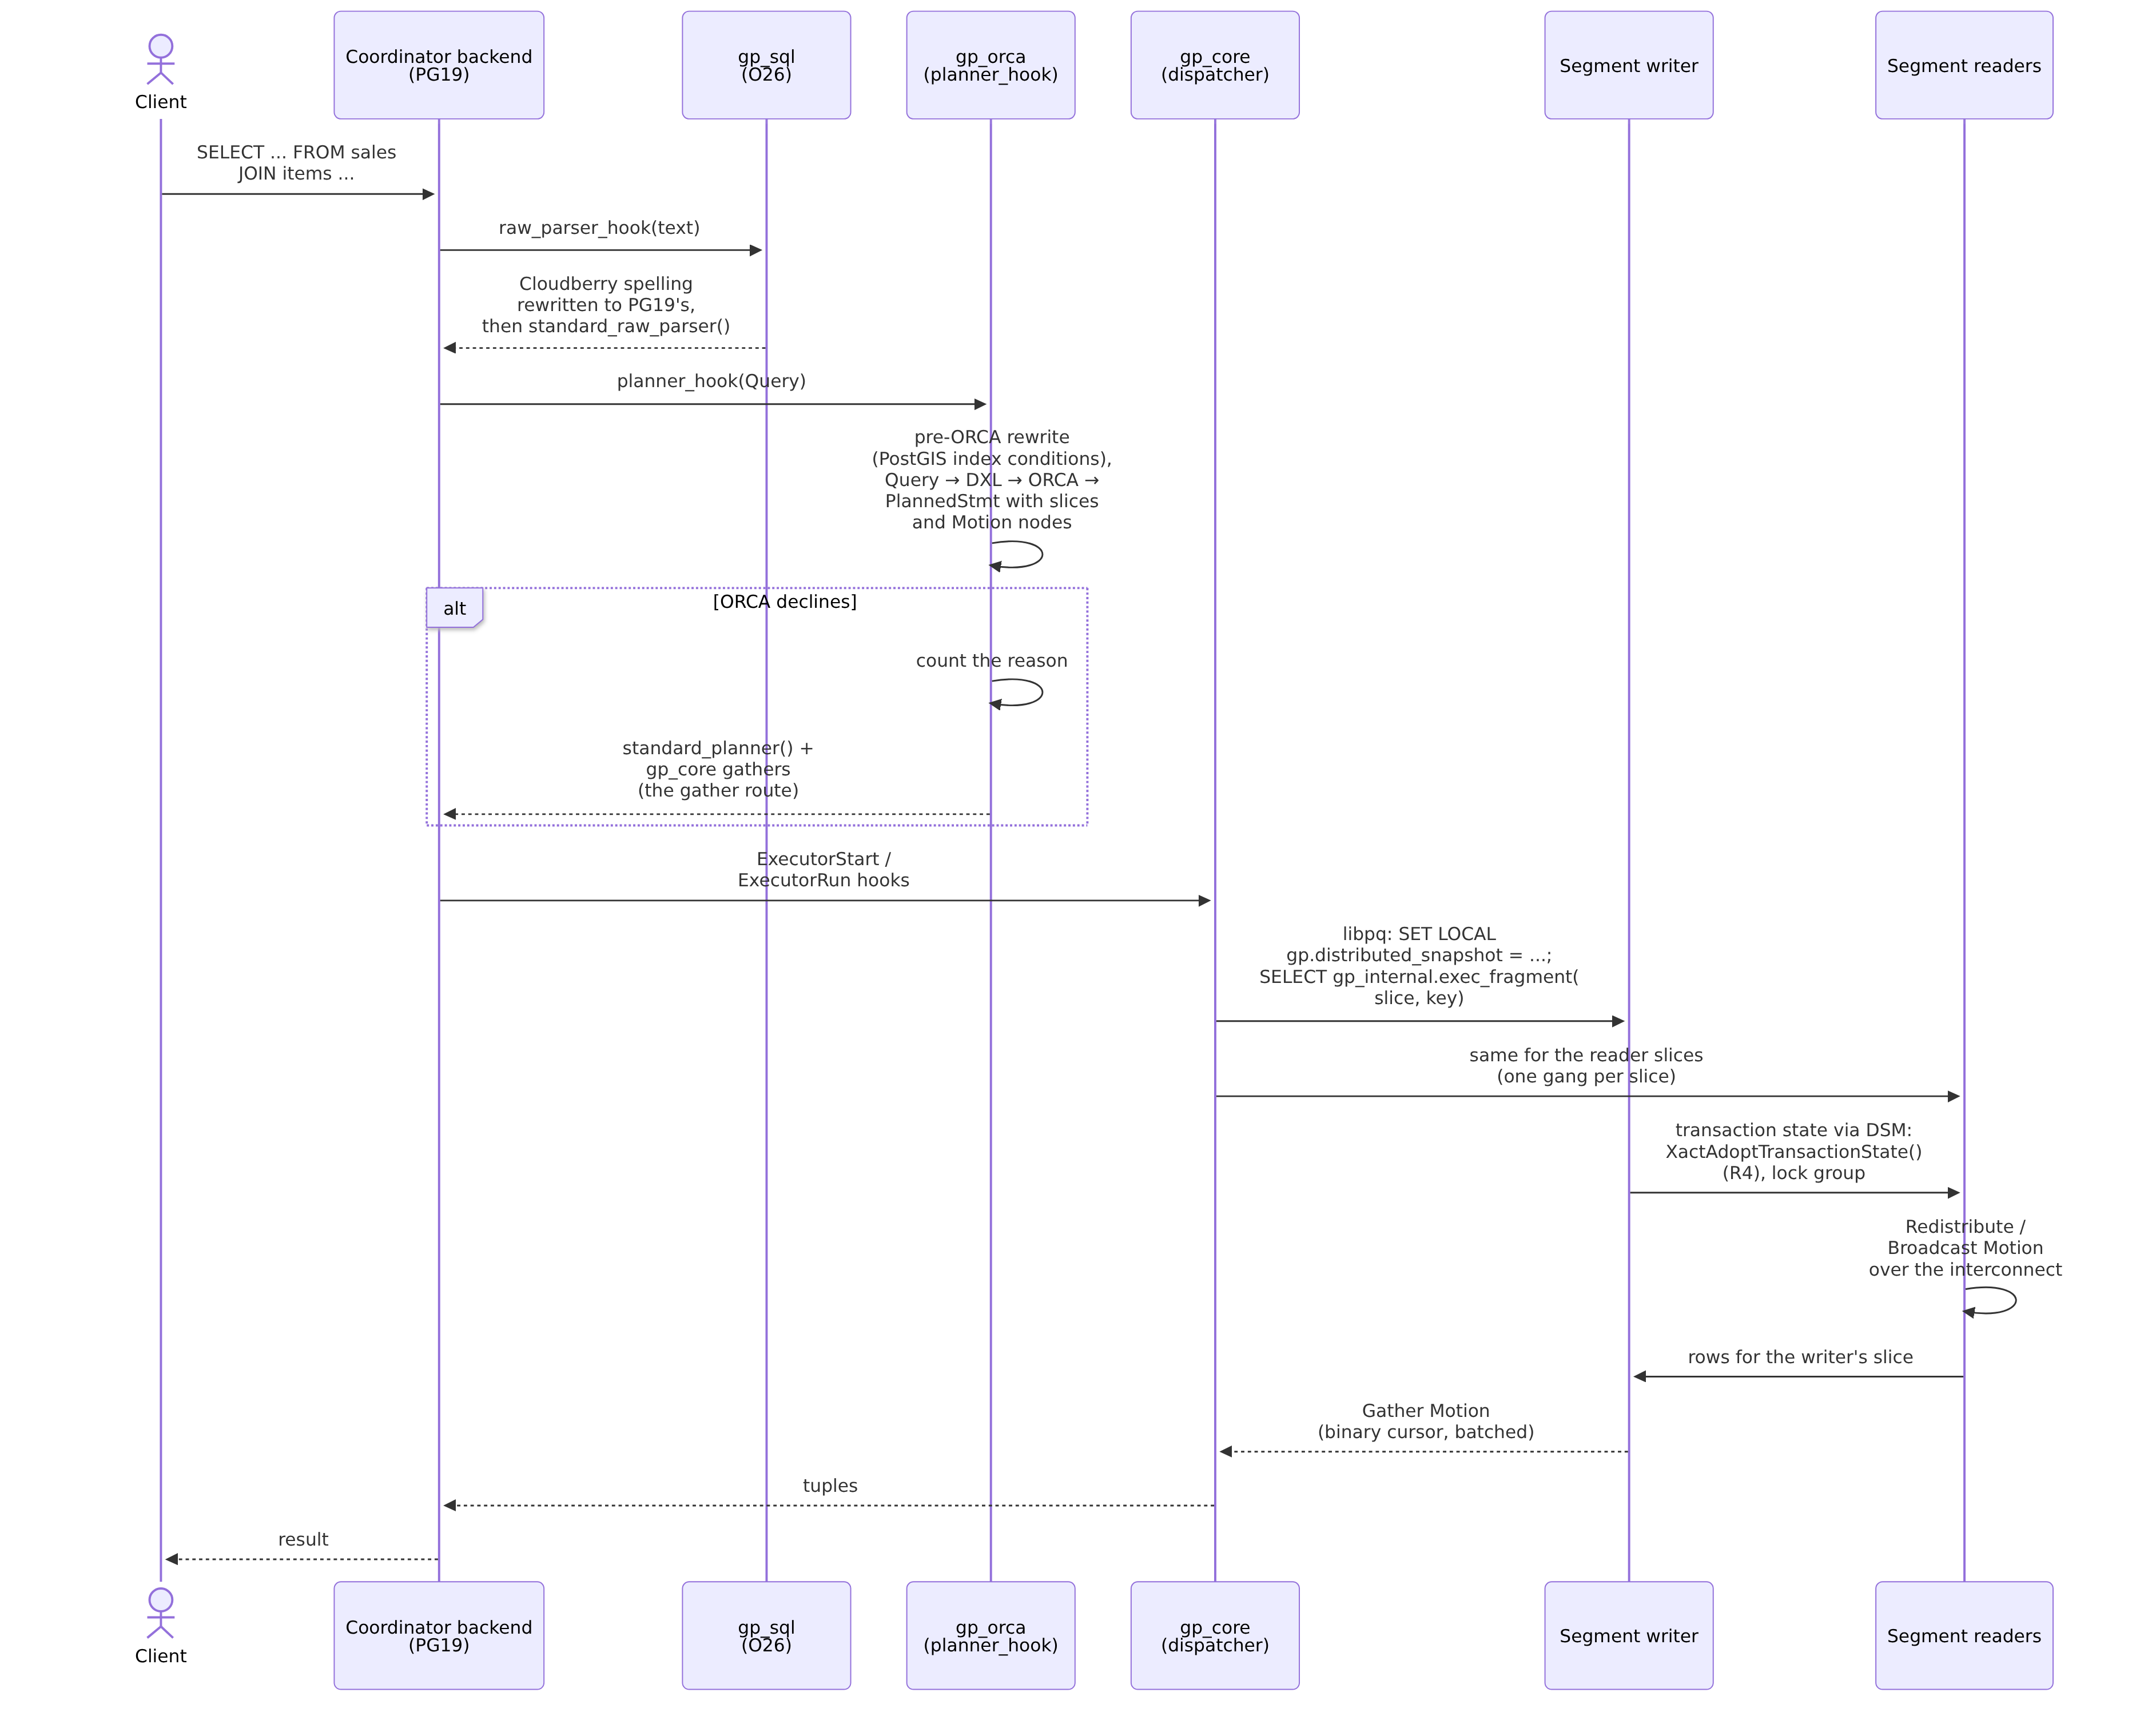
作者借助LLM,仅用12天、629次提交,将Apache Cloudberry(Greenplum的开源延续)移植为PostgreSQL 19扩展而非分支,移植了约93%的数据库代码,59%的原测试通过。核心仅22个小补丁,未加载扩展时行为与原生PG 19一致。ORCA优化器原样复用,TPC-H和TPC-DS全部121条查询均由ORCA规划,比回退方案快3-4倍。
PGDG RPM仓库新增Rust扩展pgrx和postgresql_anonymizer及打包指南,目前有限制,计划11月支持RHEL 10.3和9.9。修复了仓库RPM随系统小版本更新的问题,建议尽快更新。Amazon Linux 2023已成为PGDG YUM仓库的一等目标,提供完整扩展生态和一致布局。
订单API在无部署变更时吞吐量骤降,原因是fetch_all_products()函数排序超宽产品行时超出默认work_mem,每天向磁盘溢出150GB。全局调高work_mem会危及服务器内存,因此使用ALTER FUNCTION ... SET work_mem TO '128MB'仅对该函数生效,磁盘写入降为零,延迟恢复。
PostgreSQL 18 内置 uuidv7(),作者用 500 万行数据对比 bigint、UUIDv7 和 UUIDv4 主键。UUIDv7 插入耗时 27 秒,UUIDv4 需 46 秒,索引大 29%。因 v7 按时间递增,写入集中在最右叶页,页密度达 90%;v4 随机插入导致页分裂,密度仅 70%,WAL 多写 147MB。随机查询三者相近,但按主键取最新 1000 行时 v4 需读 1008 个缓冲区,v7 仅 17 个。注意 v7 会暴露创建时间。
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
文章对比四家Postgres托管服务在内存压力下的可靠性:递归UNION查询会生成不受work_mem限制的哈希表,可能耗尽内存。测试中,ClickHouse Managed Postgres通过内存上限使查询干净失败,集群保持存活;RDS触发OOM崩溃并进入恢复;Cloud SQL和PlanetScale则杀掉连接。结论是较低内存上限虽牺牲部分查询,但换取了数据库整体可用性。
本文介绍使用Percona Operator在MySQL组复制中实现跨数据中心灾备,突破单集群限制,提升高可用与容灾能力。
完成下面两步后,将自动完成登录并继续当前操作。