PostgreSQL 16 中,无法内联的 SQL 函数(如调用 regexp_matches)每次调用都会重新生成执行计划,而 PL/pgSQL 函数会缓存计划。某每小时任务循环调用该函数 1000 万次,SQL 版因反复规划耗时约 47 秒;改用 PL/pgSQL 后仅规划 6 次,降至约 24 秒;改用 regexp_match 使函数可内联后进一步降至约 12 秒。PostgreSQL 18 已修复此问题。
PostgreSQL 19 的 SQL 与开发更新包括:新增 ON CONFLICT DO SELECT,冲突时返回已有行;COPY 支持 on_error set_null 及含 FORCE_ARRAY 的 JSON 导出;jsonpath 增加 lower、upper、replace 等字符串方法;修复 IS JSON 对域类型的支持;postgres_fdw 传递 READ ONLY 和 DEFERRABLE 模式;允许将 CHECK 约束改为 ENFORCED,并修改带约束的虚拟生成列表达式;新增 uuid 与 bytea 直接转换及 base32hex 编码;PL/pgSQL 简单表达式绕过 SPI;新增 tid_block、tid_offset 函数;默认 TOAST 压缩改为 lz4。
文章介绍PostgreSQL的SQL/PGQ图查询扩展:可在现有表上定义属性图,并用类Cypher模式查询;重写器将图模式转换为普通JOIN和UNION,复用索引、统计与并行查询,无需新执行器。已提交实现仅支持100项标准特性中的26项,缺少量词、路径模式和变长边等关键功能。该功能因目录表示和依赖问题从PostgreSQL 19撤回,预计在20回归;变长边是未来重点。
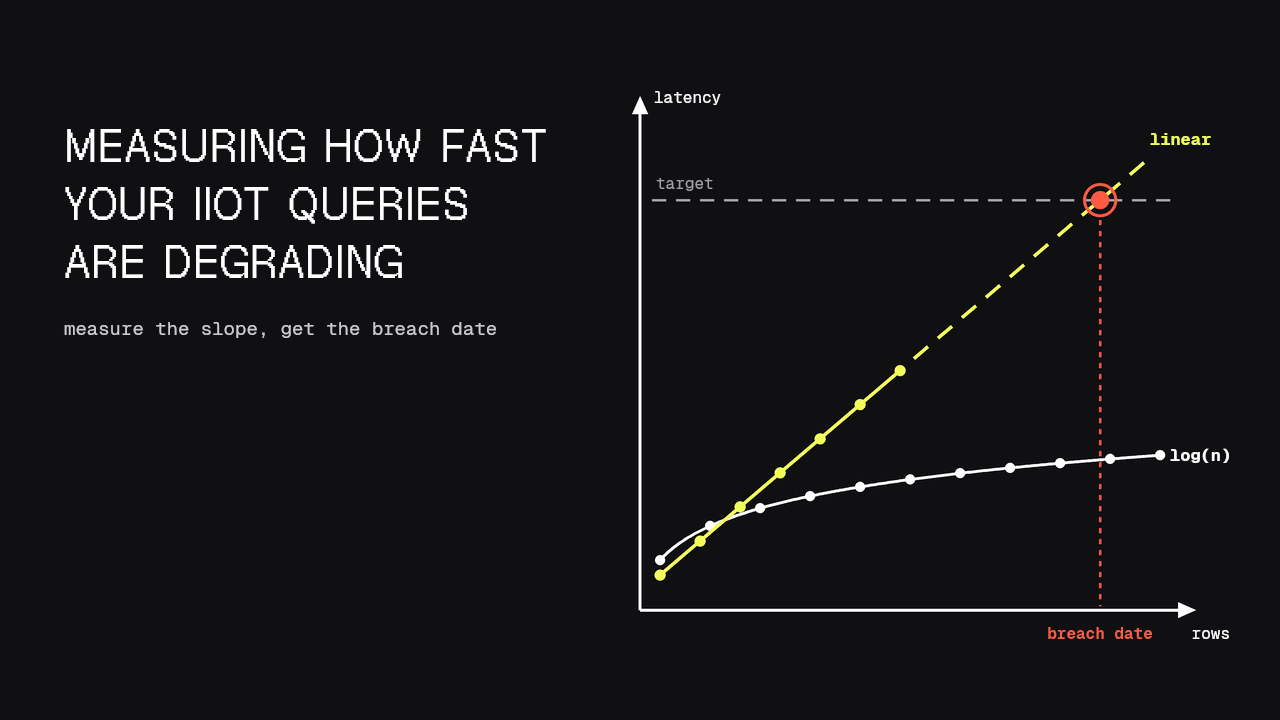
通过记录工业物联网数据库查询延迟与数据行数的关系并拟合曲线,可预测查询何时超出目标延迟,提前发现仪表板变慢问题,避免被动等待。
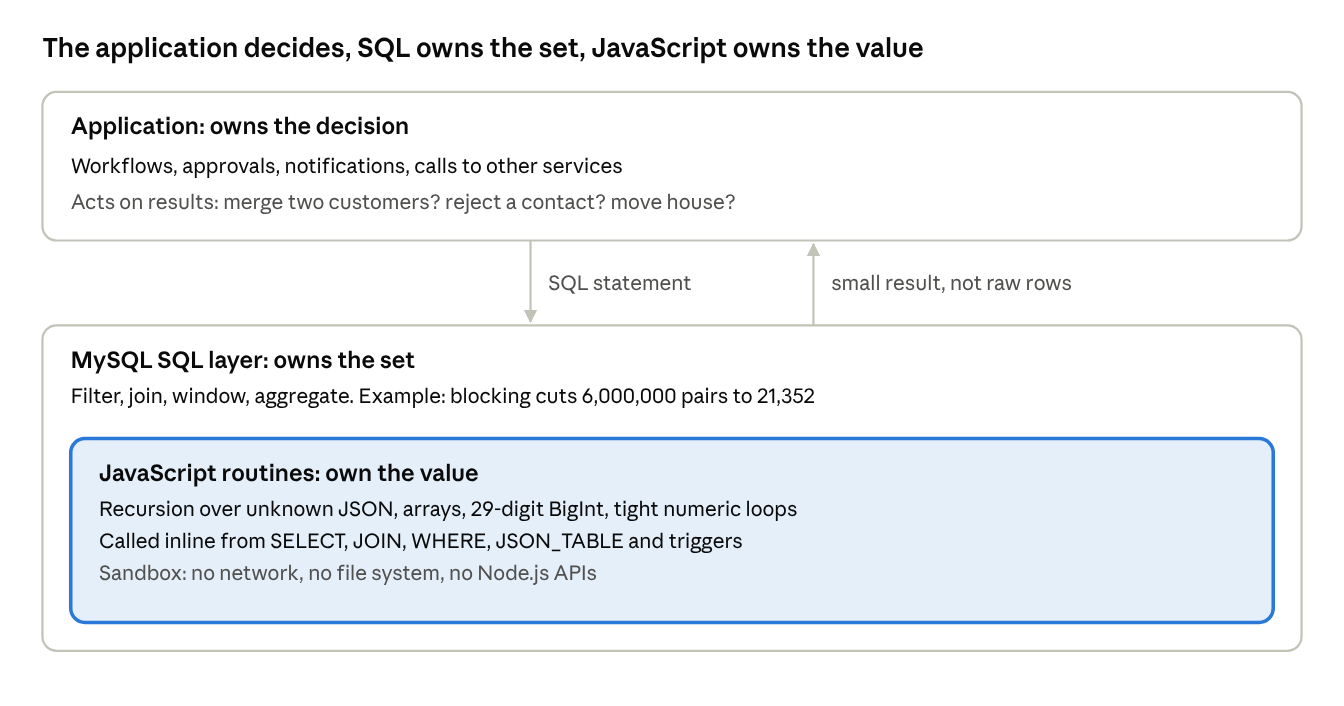
在Percona Live Europe 2026上,作者介绍了Percona Server for MySQL 8.4的V8 JavaScript引擎组件component_js_lang。它并非将数据库变为应用服务器,而是扩展SQL能力:SQL负责集合操作,JavaScript负责单值计算,适用于递归、数组、大数和紧循环等SQL难以表达的步骤。业务逻辑仍保留在应用层,JavaScript例程仅填补SQL与存储过程之间的空白。
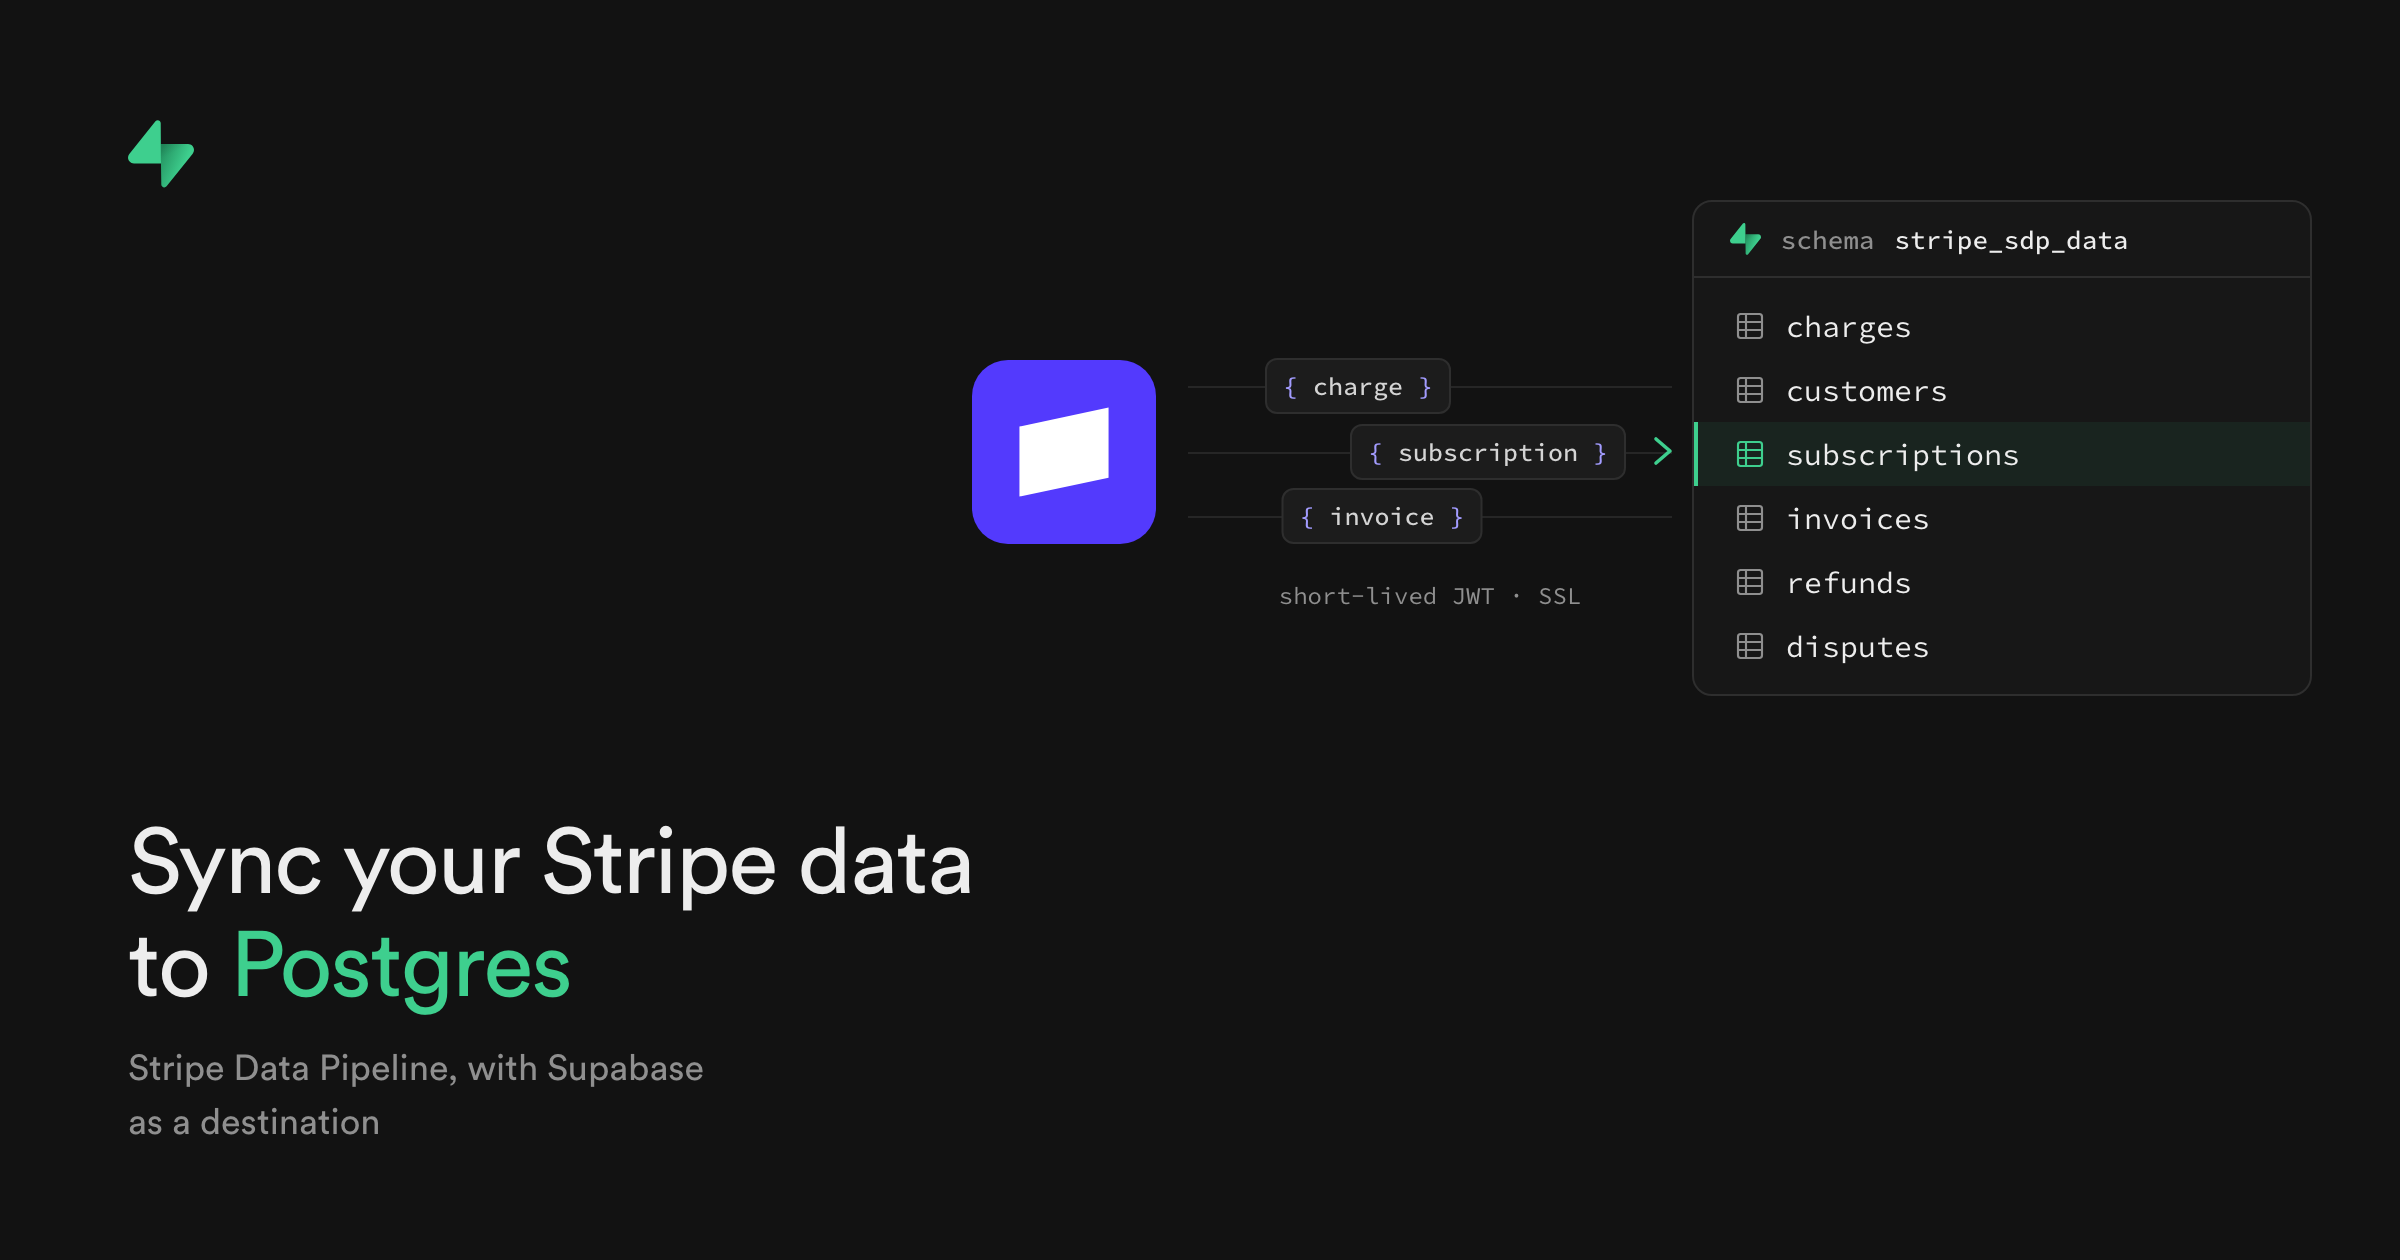
Stripe 数据管道新增 Postgres 支持,Supabase 成为首批可连接目标。用户可在 Stripe 后台直接连接 Supabase 项目,自动回填并持续同步支付、客户、订阅等数据到专用 schema,无需维护 webhook 或担心 API 限流。数据可用标准 SQL 查询,并与应用数据关联,实现功能门控和收入指标计算。
Cloudflare为Logpush推出Transformers功能,可在日志导出前用SQL查询过滤、脱敏和重塑数据,无需额外处理服务。该功能基于Apache DataFusion和Arrow,在Go编写的Bufstream中内嵌Rust查询引擎,实现高吞吐、低延迟的进程内转换,失败时自动重试并禁用问题任务。
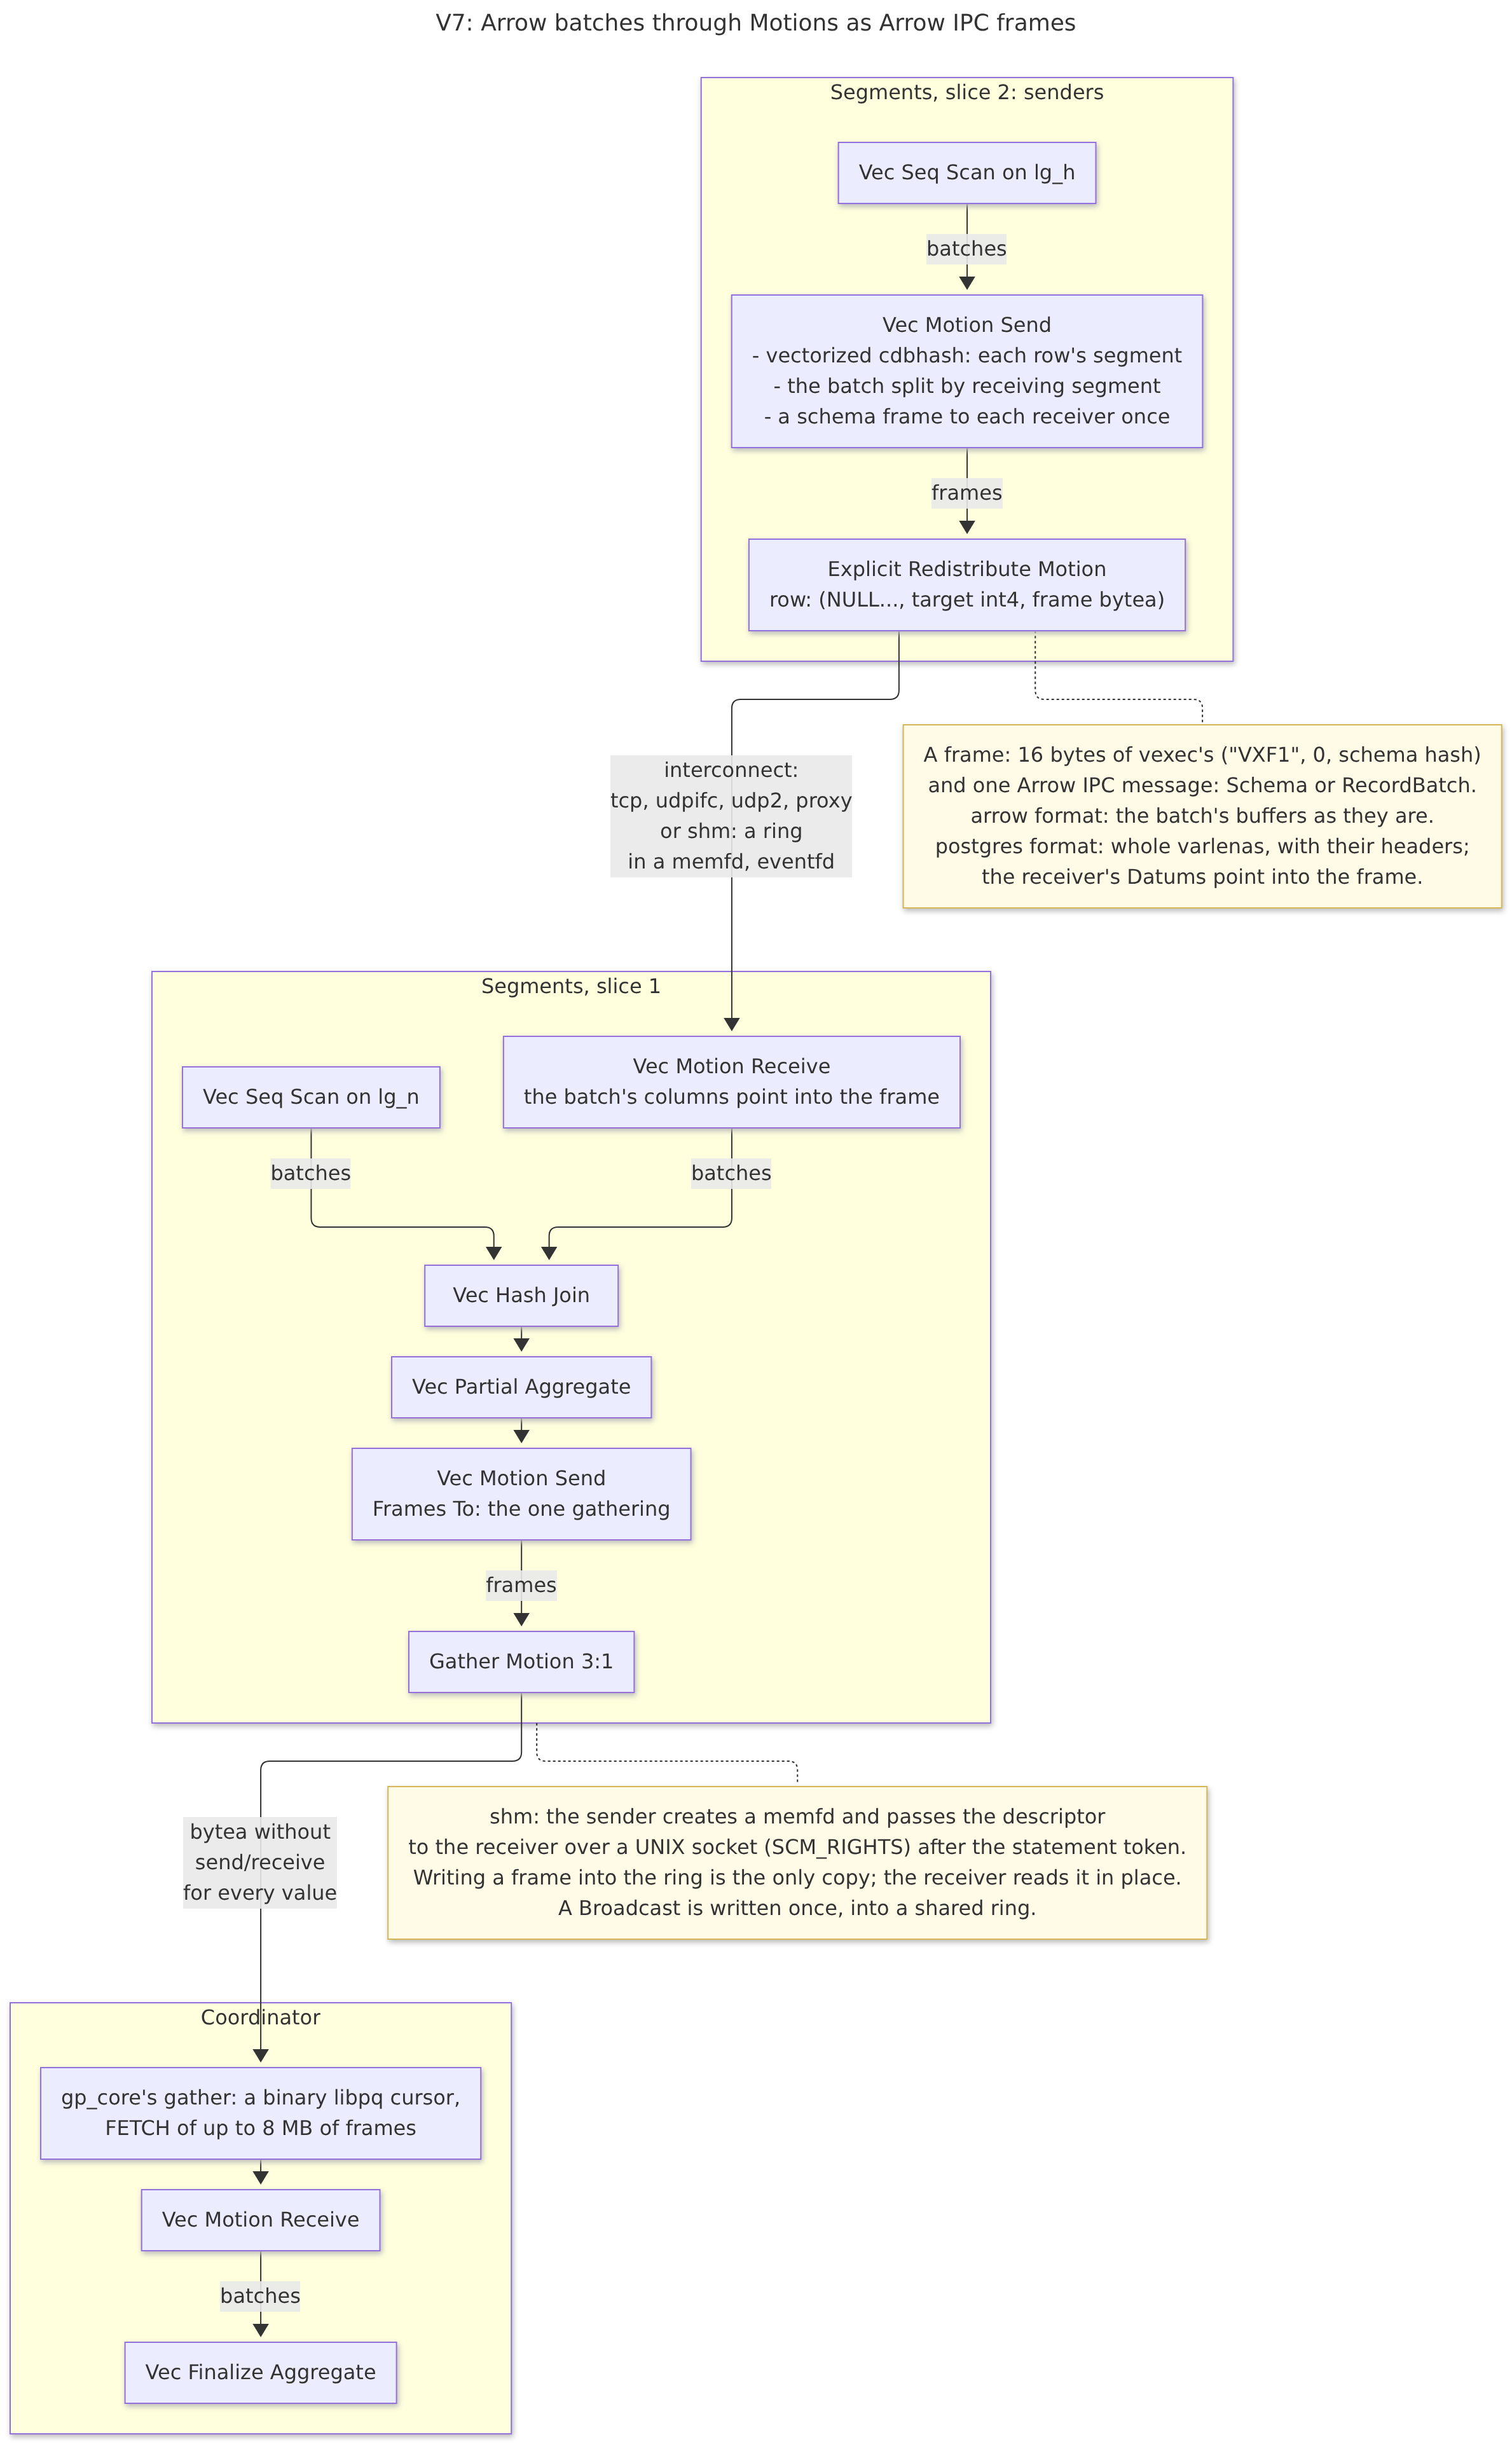
作者开发了pg_vexec扩展,为PostgreSQL 19实现向量化查询执行,无需修改内核。该扩展通过规划器钩子让向量节点与行式路径按代价竞争,支持ORCA向量化规划、PAX列存批量读写、Arrow IPC帧跨节点传输及Flight SQL接口。239项回归测试通过,ClickBench提速19–24%,Flight SQL比二进制COPY快4.7倍。
Databricks产品营销总监Richard Tomlinson指出,自然语言分析长期未兑现承诺,瓶颈不在大模型,而在缺乏业务上下文。可信的AI分析需三层基础:受治理的数据、明确可读的语义定义,以及可追溯验证的信任层。语义锚定将问题绑定到企业实际指标、关系与规则,治理则贯穿AI代理的每个决策。Genie通过本体、对话上下文管理和权限控制,让非专业用户也能获得可信答案。
Databricks 正式发布原生 IP 函数,使 IP 地址分析成为湖仓上的高性能 SQL 工作负载。此前处理 IP 和 CIDR 需依赖正则、位运算或 UDF,性能差且难维护。新函数原生支持 IPv4/IPv6、CIDR 包含判断和范围连接,可加速威胁检测与网络可观测性,成本比传统仓库低 2 至 6.4 倍。
2026年4月,微软、亚马逊、戴尔和Snowflake集中公开或授权了四件NL2SQL专利,均将自然语言转SQL从提示词工程转向结构化中间层,例如先生成实体关系图或数据目录。竞争焦点已从“会写SQL”变为“元数据与校验是否足够厚”。生成层已被大厂占据,但判断SQL是否真正回答问题的校验层仍属空白。个人可构建金标准问题集与自动回归校验,创业机会包括查数质检服务和校验插件。
Databricks 推出新方案,支持在无服务器 GPU 上部署开源决策模型,并通过 ai_query 对受治理数据直接运行。用户无需管理 GPU 基础设施,即可从 SQL 控制台或生产作业调用模型,对酒店评论等数据分类并返回结构化结果与概率。该模式支持自定义模型 API,便于大规模应用和企业场景微调。
knitr 的 SQL 引擎近期新增多项功能:sql.interlaced 支持拆分并逐条执行多语句;sql.result.fun 可返回惰性句柄供 dplyr 处理;引擎能识别非查询语句并返回影响行数,可通过 sql.statement.msg 报告;sql.args 用于传递后端参数。
Databricks 推出 MATCH_RECOGNIZE,使用类似正则表达式的语法直接匹配行序列,简化事件序列分析。可检测连续登录失败后成功、股价V型反转、用户加购后放弃、设备温度上升伴振动等模式,替代复杂的 gaps and islands、自连接和窗口函数,代码更少、易维护。
SQL数据类型定义数据库列可存储的值及存储空间,影响数据完整性、存储效率和查询性能。主要分为数值、字符、日期时间和二进制四类,各数据库实现略有差异。选择最小且安全的类型可优化性能,如DECIMAL用于财务精确计算,VARCHAR节省空间,TIMESTAMP记录精确时间,BINARY存储固定长度数据。正确选型能提升可扩展性并避免错误。
本文汇总了Python社区的最新动态,包括Polars与SQL的差异、Python内置常量的怪异行为、利用类型检查提升AI编码代理质量、deque数据结构教程、AWS支撑PyPI基础设施、str.lower()的安全隐患、可复现构建的挑战,以及用AI代理调试Python代码等文章和项目资源。
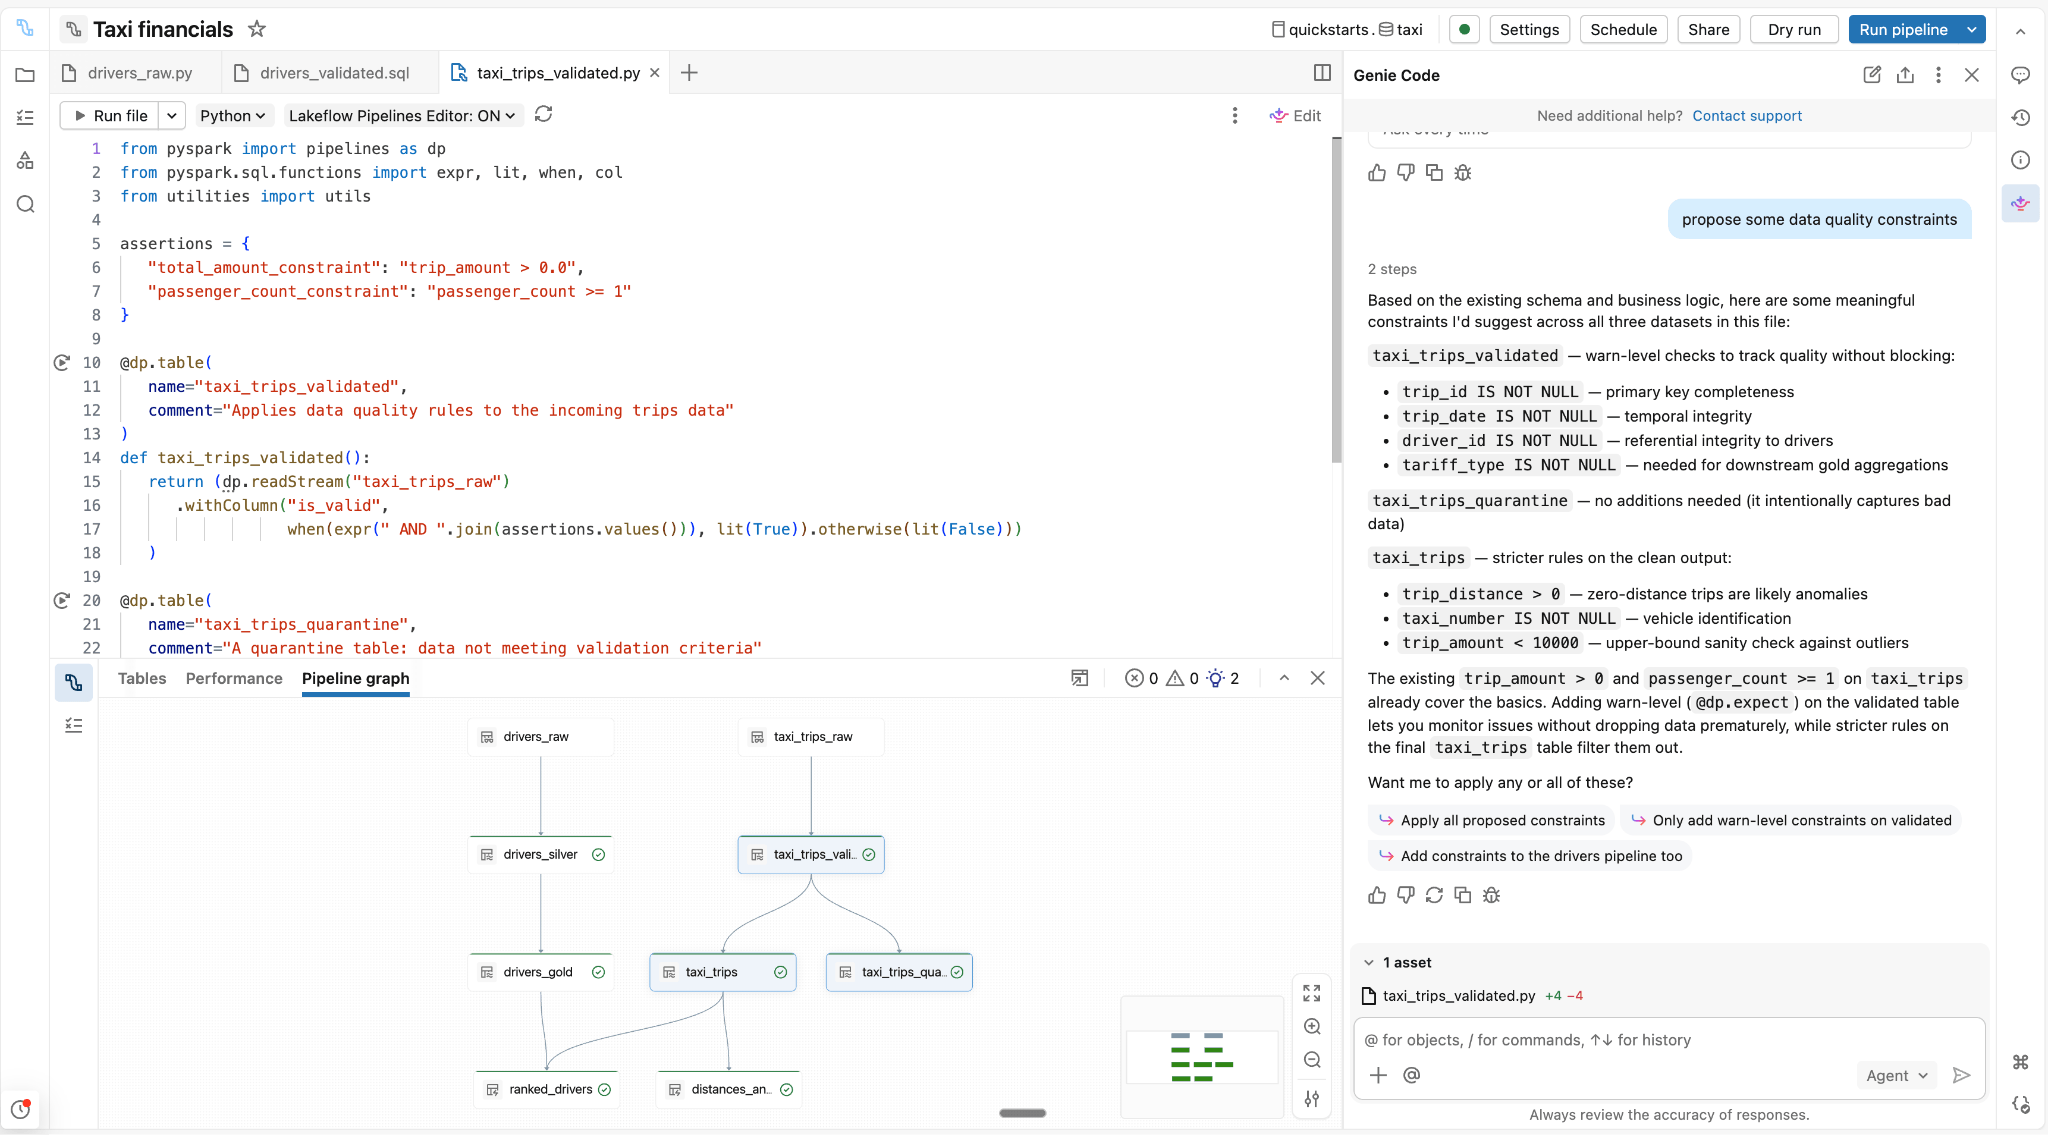
Databricks在SQL编辑器中引入声明式ETL,支持追加、CDC和批量覆盖三种模式,简化数据转换流程。用户可直接在SQL查询中定义流程,平台自动处理增量处理、调度和编排。CDC模式支持SCD类型1和2,REPLACE WHERE提升性能。用户可混合传统SQL与声明式操作,并借助Genie Code生成和优化流程。
本文介绍如何将自托管Forgejo实例的议题和拉取请求起始编号设为10000,以避免与GitHub迁移前的编号冲突。通过直接修改数据库,使用SQL语句`update issue_index set max_index=10000;`可全局设置,或按仓库ID单独调整。作者提醒编号需高于现有值,并已验证适用于Postgres,其他数据库未测试。
本文介绍将传统数据仓库中的存储过程迁移至Databricks湖仓的方法。通过示例展示游标、临时表、事务等SQL脚本的翻译过程,保留原业务逻辑,无需重写为Python或Spark。迁移后由Unity Catalog管理,支持访问控制和血缘追踪,并发处理更高效,迁移时间可减少50-75%。
SQL子查询是嵌套在主查询中的查询,用于提供派生列、派生表或过滤数据。本文介绍了子查询的执行顺序、非相关与相关子查询的类型,并通过示例展示了子查询在SELECT、FROM、WHERE子句中的应用,包括使用IN、ANY、ALL、比较运算符和EXISTS等操作符,帮助读者理解并掌握子查询的使用方法。
完成下面两步后,将自动完成登录并继续当前操作。