


从自编码器到Beta-VAE
内容提要
本文综述自编码器及其变体。基础自编码器通过编码器压缩输入、解码器重建数据以实现降维;为防过拟合,提出去噪、稀疏、收缩等改进。变分自编码器(VAE)将输入映射为分布,用重参数化技巧训练并优化ELBO下界;β-VAE增强解耦表示;VQ-VAE引入离散码本,VQ-VAE-2采用分层结构生成图像;TD-VAE面向序列数据。
延伸解读
自编码器家族:从重建到鲁棒表示
基础自编码器通过编码器压缩输入、解码器重建数据,实现降维。为提升鲁棒性,去噪自编码器在输入中加入噪声并学习恢复原始数据;稀疏自编码器限制隐藏层激活稀疏性;收缩自编码器惩罚编码对输入的敏感度。这些变体均以重建损失为核心,但通过不同正则化手段学习更有效的潜在表示。
VAE与β-VAE:从连续分布到解耦表示
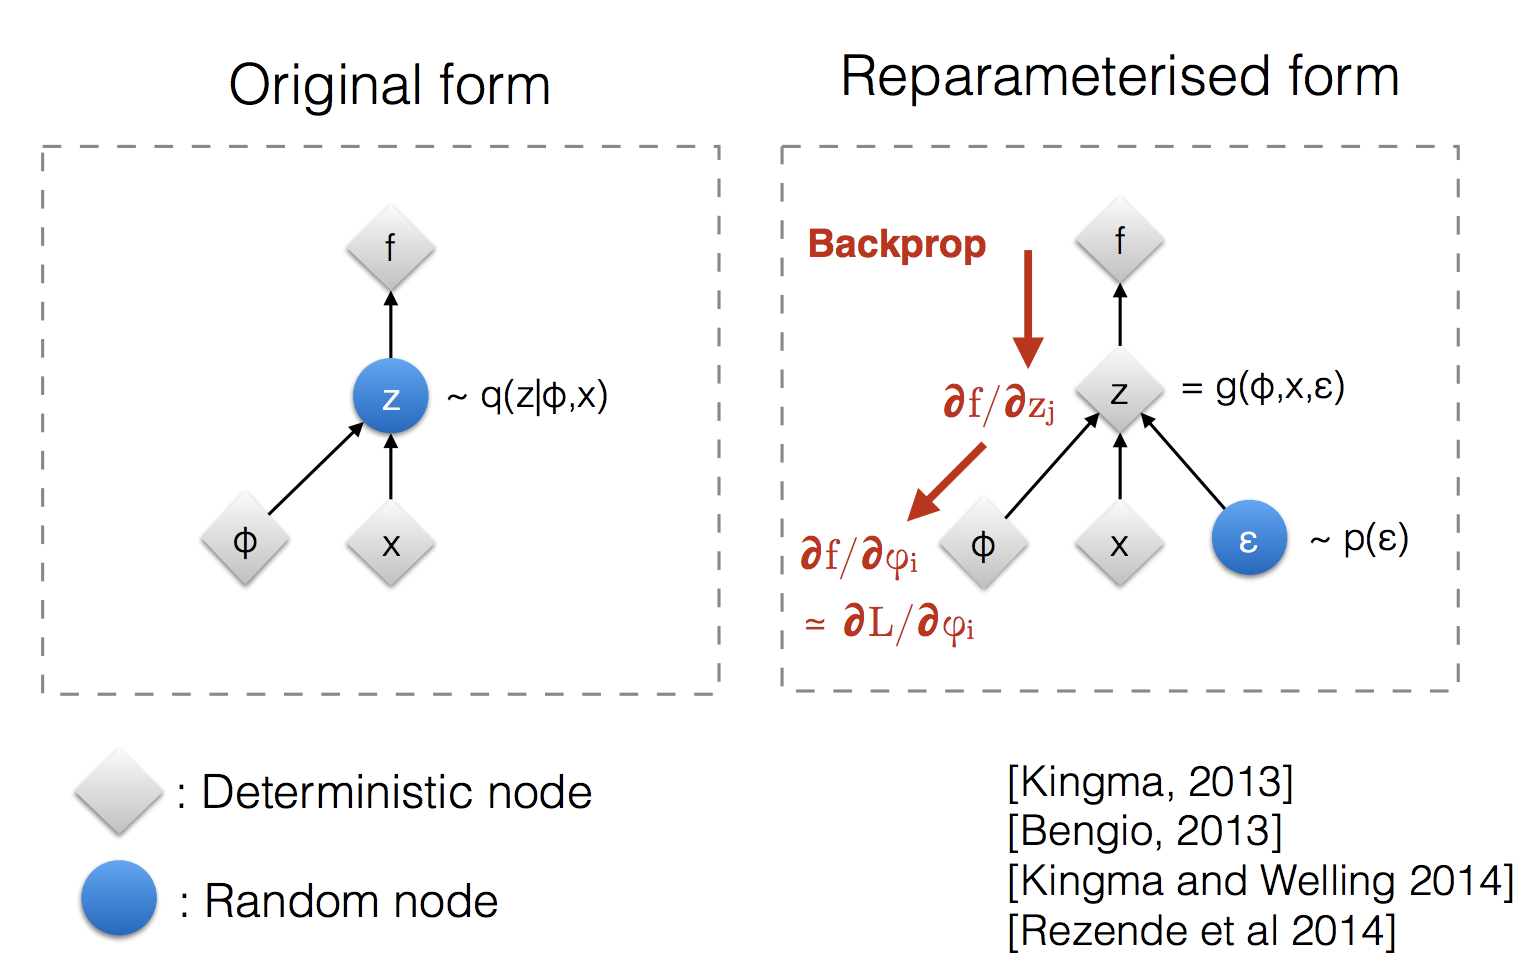
变分自编码器(VAE)将输入映射为潜在分布,通过优化ELBO下界进行训练,并利用重参数化技巧实现反向传播。β-VAE在VAE基础上引入超参数β,通过加强KL散度约束来促进潜在变量的解耦,但β增大会在重建质量与解耦程度之间产生权衡。
VQ-VAE与VQ-VAE-2:离散潜在变量的生成模型
VQ-VAE通过向量量化将编码器输出映射到离散码本,并引入VQ损失和承诺损失来训练。VQ-VAE-2采用分层结构,分别捕捉局部纹理和全局形状,并结合自注意力自回归模型学习先验,从而生成高质量图像。离散潜在变量更适合语言、语音等任务。
TD-VAE:面向序列数据的时序建模
TD-VAE将状态空间模型、信念状态和跳跃预测相结合,用于序列数据。它利用RNN编码历史信息形成信念状态,并基于变分下界进行训练,使智能体能够基于过去信息预测未来状态,甚至进行多步跳跃预测。
Q&A
自编码器的主要用途是什么?
自编码器主要用于以无监督方式学习恒等函数来重建原始输入,同时压缩数据以发现更高效、更压缩的表示。其副产品是降维:瓶颈层捕获压缩的潜在编码,这种低维表示可用作嵌入向量,帮助数据压缩或揭示数据生成因子。
去噪自编码器是如何工作的?
去噪自编码器通过随机方式向输入添加噪声或掩码部分值来部分损坏输入,然后训练模型恢复原始输入(而非损坏的输入)。这种设计迫使模型发现并捕获输入维度之间的关系,以推断缺失部分,从而学习鲁棒的潜在表示,避免过拟合。
VAE中的重参数化技巧有什么作用?
重参数化技巧使VAE的训练可反向传播。由于从q_φ(z|x)采样是随机过程,无法直接反向传播梯度,该技巧将随机变量z表示为确定性变量z = μ + σ ⊙ ε,其中ε ~ N(0, I),从而将随机性转移到ε,使模型可以通过学习μ和σ来训练。
β-VAE与标准VAE有什么区别?
β-VAE是VAE的修改版,特别强调发现解耦的潜在因子。它在损失函数中引入超参数β来约束KL散度项:当β=1时与VAE相同;当β>1时,对潜在瓶颈施加更强约束,限制表示容量,从而鼓励更高效、更解耦的潜在编码,但可能牺牲重建质量。
VQ-VAE中的码本是什么?
在VQ-VAE中,码本(codebook)是潜在嵌入空间e ∈ R^{K×D},其中K是潜在变量类别的数量,D是嵌入大小。编码器输出通过最近邻查找匹配到K个嵌入向量之一,匹配的码向量成为解码器的输入。码本通过指数移动平均(EMA)更新。
VQ-VAE-2如何生成图像?
VQ-VAE-2采用两阶段方法:第一阶段训练分层VQ-VAE,将局部模式(如纹理)与全局信息(如物体形状)分离,底层码本训练以顶层码为条件;第二阶段学习潜在离散码本上的先验,使用多头自注意力自回归模型(如PixelSNAIL)采样生成图像。
TD-VAE处理序列数据时依赖哪些主要思想?
TD-VAE处理序列数据时依赖三个主要思想:1. 状态空间模型作为马尔可夫链模型,隐藏状态决定观测状态;2. 信念状态,智能体编码所有过去状态以推理未来,b_t = RNN(b_{t-1}, x_t);3. 跳跃预测,基于已收集信息想象遥远未来,预测未来多步状态。
