


如无影响,请忽略
内容提要
一位读者的RDS MySQL实例五天内两次主备切换。官方承认后台监控查询information_schema.innodb_trx需持全局排他闩锁遍历所有连接与事务,高并发时变慢,阻塞全实例DML,导致实例Hang、探活失败触发切换。官方承诺7月24日关闭该监控,但7月28日故障复发,疑未真正执行。作者指出监控设计须设硬超时且总和不超采集周期,并批评修复无闭环、探活机制把“慢”升级为“断”。
延伸解读
监控查询为何能拖垮实例
文章指出,查询 information_schema.innodb_trx 时,InnoDB 需持有全局排他闩锁,遍历所有连接和活跃事务,并深拷贝事务信息。该实例有 1950 个连接,高并发时遍历和拷贝成本剧增,导致闩锁持有时间从几十毫秒涨到几秒,期间全实例无法获取或释放行锁,DML 停摆,形成雪崩。这解释了监控查询如何从“看一眼”变成实例 Hang 的导火索。
修复未闭环的典型表现
官方承诺 7 月 24 日关闭监控,但 7 月 28 日故障复发。文章列举四种可能:未执行、执行未成功、关错对象、或全新根因。无论哪种,都指向修复流程缺乏确认、回执和验收。客户以为“应该已关闭”,官方用“预计”表述,双方均不确定。这种不闭环的修复,使同一问题在五天内两次击中同一实例,属于 repeat incident。
探活机制把“慢”升级为“断”
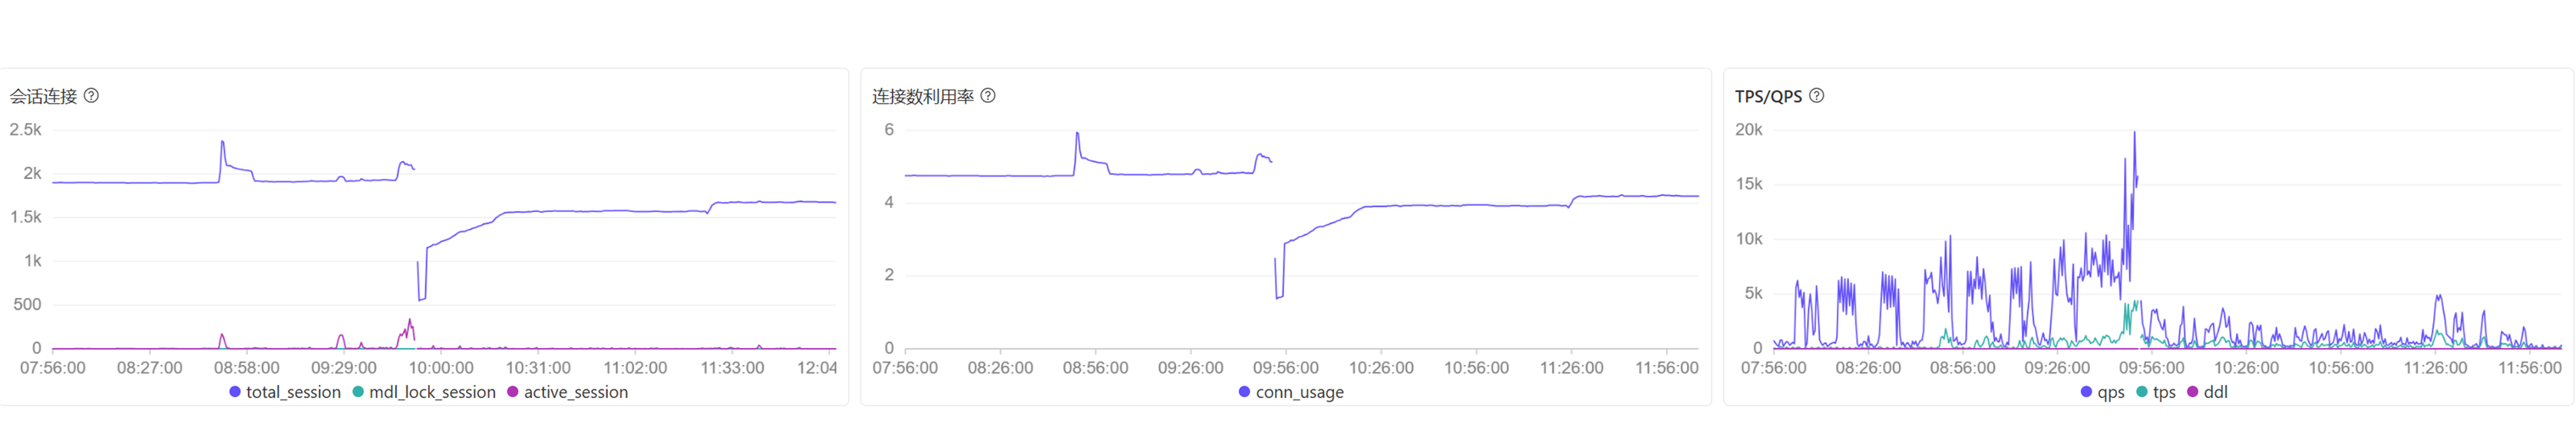
业务原本只是变慢,但探活连续三次失败触发主备切换,导致所有连接被切断,业务完全中断。文章指出,探活无法区分实例“慢”与“死”,且切换后新主 buffer pool 是凉的,后台采集程序依旧,可能再次犯病。7 月 28 日曲线显示切换后脏页从零爬升近二十分钟,高可用机制反而成为当天最大的可用性支出。
用户无法验证的修复与风险
客户设置了内核手动升级,但一个未知的后台采集功能从另一条通道进入,且没有开关或通知。官方处置仅为“对客户实例关闭”,未提及全网整改。用户交出了复杂性,却留下了风险:业务中断、订单丢失、爬坡等待都由自己承担,而看见、理解、干预的能力却在平台侧。文章认为,开源自建最被低估的价值是知情权,出事时至少能自己查看内部。
Q&A
为什么查询 information_schema.innodb_trx 会导致 RDS MySQL 实例 Hang 住?
因为查询该视图时,InnoDB 需要获取一把全局排他闩锁(Global_exclusive_latch_guard),然后遍历所有连接和活跃事务来生成快照。这把锁会冻结全实例的行锁操作,导致所有 DML 阻塞。高并发时,遍历和拷贝耗时急剧增加,锁被长时间持有,进而引发实例 Hang。
RDS 后台监控查询 innodb_trx 是如何触发主备切换的?
监控查询变慢后,会阻塞实例的 DML 操作,导致实例 Hang。此时 HA 探活连续三次失败,系统判定实例异常,自动触发主备切换。切换瞬间所有连接被切断,业务完全中断。
官方承诺关闭监控后,为什么四天后故障又复发了?
官方在 7 月 24 日承诺关闭该监控功能,但 7 月 28 日同一实例再次发生主备切换。可能原因包括:关闭操作未执行、执行未成功或只关闭了部分节点、关闭的不是真凶,或者出现了新的独立根因。文章指出修复流程缺乏闭环和验证。
设计数据库监控时,如何避免监控查询拖垮生产库?
应遵循三条原则:1) 采集周期设为 10 秒左右,避免过于频繁;2) 每条监控查询设置硬超时(如 100 毫秒);3) 所有查询的超时之和必须小于一个采集周期,确保最坏情况下采集器空转一轮,不会堆积。此外,优先使用 Performance Schema 而非 information_schema.innodb_trx。
为什么说高可用探活机制把“慢”升级成了“断”?
实例因全局锁被卡住时,业务只是变慢但仍在运行。但探活机制连续三次探活失败后,直接触发主备切换,导致所有连接被切断,业务完全中断。探活无法区分“慢”和“死”,且切换后新主 buffer pool 是冷的,需要长时间预热,反而造成更大的可用性损失。
MySQL 社区版是否修复了 innodb_trx 查询的全局锁问题?
没有。MySQL 8.0.40 重新设计了 performance_schema.data_locks 和 data_lock_waits,使其不再需要全局排他 mutex,但 information_schema.INNODB_TRX 走的仍是老路。对比 8.0.32、8.0.40、8.4.3 的源码,trx0i_s.cc 中 Global_exclusive_latch_guard 依然存在,代码未变。
