本文介绍在AWS VPC中基于Transit Gateway Connect、FRR与Linux TC构建主备式QoS VNF,对VPC出口流量集中分级限速。VNF部署于独立net-vpc,通过GRE隧道和BGP引流,并用两张TGW路由表避免环路。TC采用HTB加fq_codel,按端口分类:高优先级保证80Mbit/s,尽力而为保证20Mbit/s,空闲带宽可互借。实验显示竞争时约为79.5/19.9Mbit/s,主备切换约25秒,并给出排空维护方法。
文章梳理了MySQL高可用五层体系:单机层依靠WAL、redo/binlog两阶段提交与双1参数,保证崩溃时不丢数据;复制层通过异步或半同步方式将数据传到备库;GTID为事务提供全局唯一标识,使切换后能自动对齐且不重复;主备切换需先追平数据,并用fencing防止脑裂;Orchestrator以反证法检测故障并自动选主,probe-agent补充主机内部视角与执行能力。最后强调应用侧也需配合异步化、降级与熔断。
本文介绍Ubuntu多宽带配置:使用nmcli重命名网卡连接,通过设置路由跃点(Metric)控制优先级(如电信100、联通200)实现主备切换;同时禁用DHCP冗余默认路由,并配置公网连通性探针检测假死,确保链路故障时自动切换。
本文分析 KubeRay Operator 的主备切换与 Ray 服务恢复。选主通过 Lease 竞争,默认仅一个副本,需配置多副本才有备用。新 leader 依赖已有资源重新协调,但无 fencing 机制,在途请求可能重复执行;控制面失联时无法补 Pod 或回写状态。worker 丢失可补建,但 actor 内存难恢复;head 丢失后 GCS 元数据需 Redis 容错才能恢复。RayService 蓝绿切换非原子操作,不保证请求零失败。
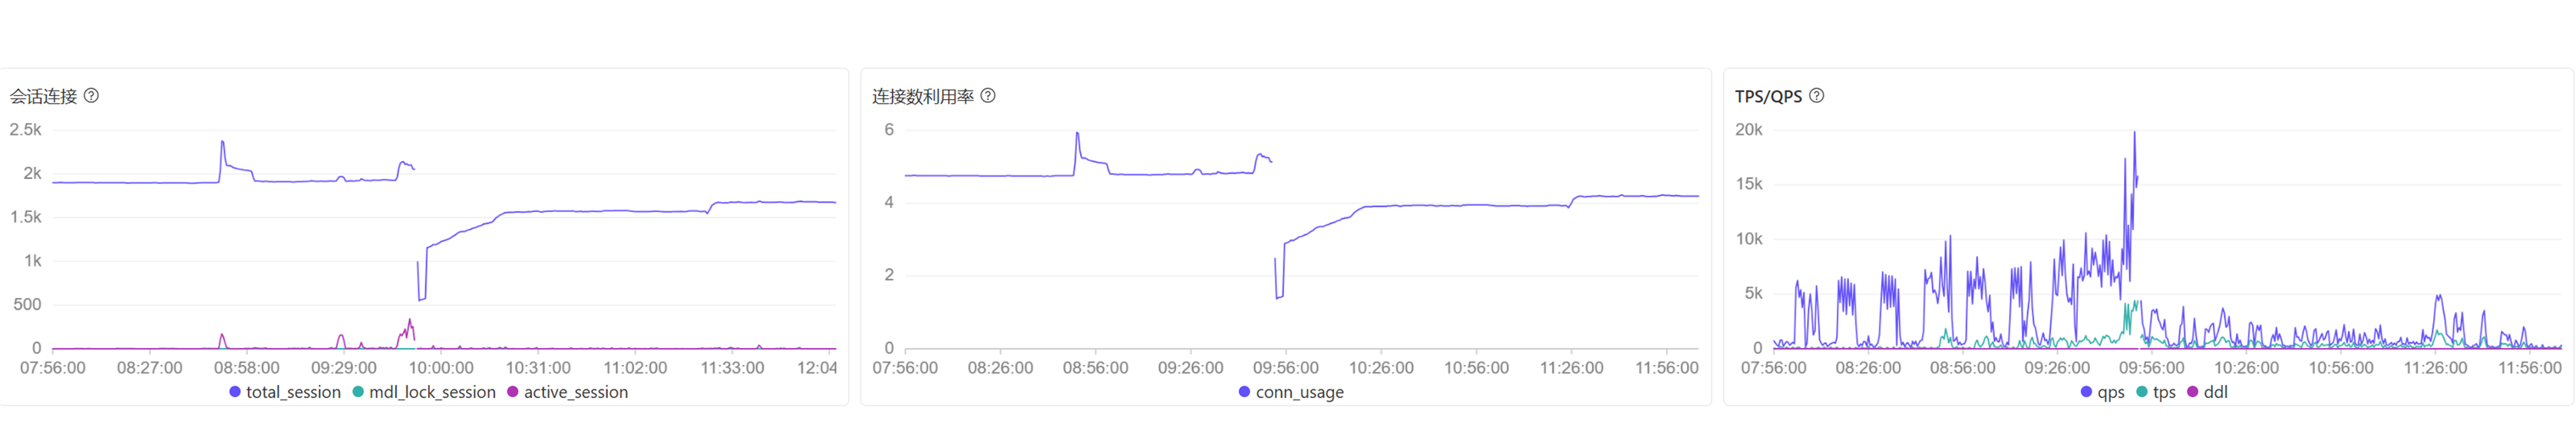
一位读者的RDS MySQL实例五天内两次主备切换。官方承认后台监控查询information_schema.innodb_trx需持全局排他闩锁遍历所有连接与事务,高并发时变慢,阻塞全实例DML,导致实例Hang、探活失败触发切换。官方承诺7月24日关闭该监控,但7月28日故障复发,疑未真正执行。作者指出监控设计须设硬超时且总和不超采集周期,并批评修复无闭环、探活机制把“慢”升级为“断”。
完成下面两步后,将自动完成登录并继续当前操作。