


指令执行的目标表示
内容提要
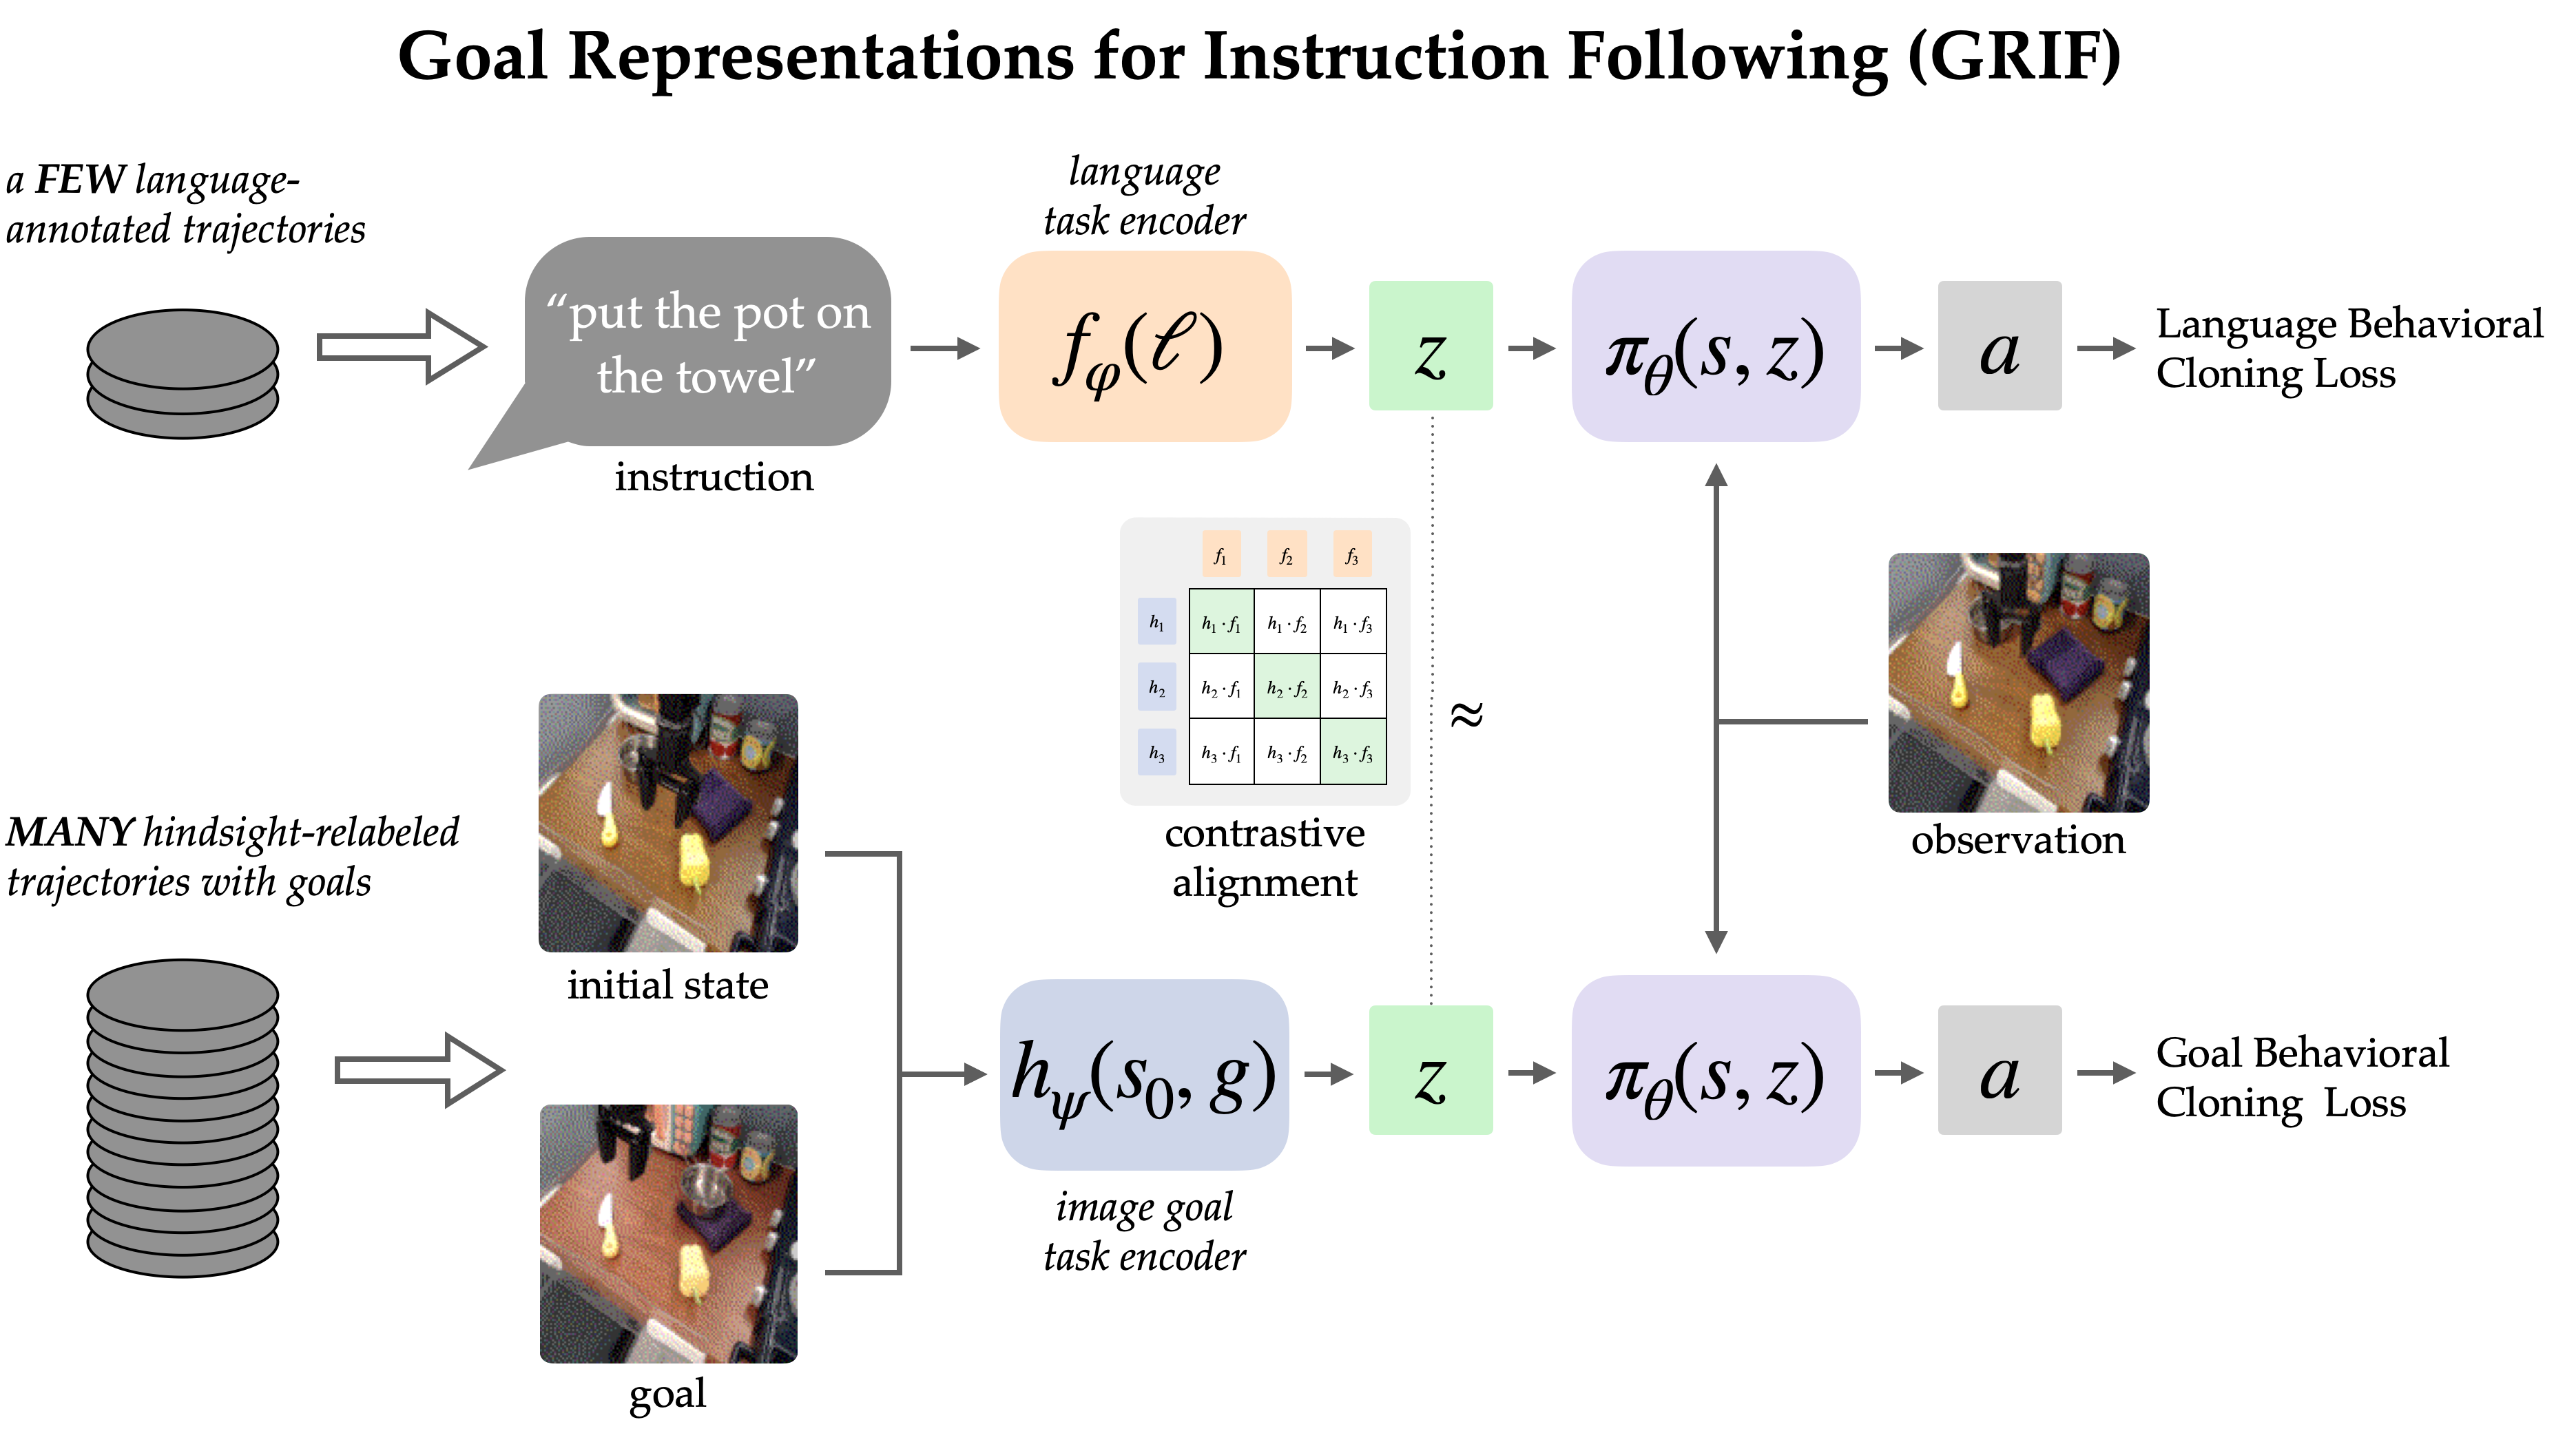
GRIF模型通过语言与目标图像的对齐,提升了机器人执行指令的能力。它结合语言条件和目标条件的学习,利用大量未标注的轨迹数据,提高了任务执行效率。实验表明,GRIF在多场景下表现优异,能够有效理解和执行复杂指令,克服了传统方法的局限性。未来可探索更丰富的语义对齐方法。
延伸解读
GRIF如何利用未标注数据提升语言指令执行
GRIF通过目标条件行为克隆(GCBC)利用大量未标注的机器人轨迹数据,这些数据无需人工语言标注。在训练中,未标注数据仅用于GCBC,而标注数据同时用于语言条件行为克隆(LCBC)和GCBC。通过共享策略网络,未标注数据提升了策略的物理操作能力,进而使语言条件策略受益。实验表明,GRIF在操作能力上显著优于仅使用标注数据的LCBC,证明了利用未标注轨迹的有效性。
对比学习中的硬负采样策略
GRIF使用对比学习对齐语言和目标表示,但朴素负采样会导致模型忽略任务本身,仅对齐相同场景的指令和目标。为解决此问题,GRIF采用硬负采样,从同一场景的不同轨迹中采样负例。这样,模型必须区分同一场景下的不同任务,从而学习到更鲁棒的任务表示。这一策略对于机器人在复杂场景中准确理解指令至关重要。
GRIF的局限性与未来方向
GRIF不擅长处理描述“如何做”的定性指令(如“慢慢倒水”),这类指令可能需要考虑中间步骤的其他对齐损失。此外,GRIF假设所有语言 grounding 来自标注数据或预训练视觉语言模型。未来工作可探索利用人类视频数据学习丰富语义,以提升对机器人数据集之外语言的理解,从而实现更泛化的指令跟随。
Q&A
GRIF模型的主要功能是什么?
GRIF模型通过语言与目标图像的对齐,提升了机器人执行指令的能力。
GRIF模型如何提高任务执行效率?
GRIF结合语言条件和目标条件的学习,利用大量未标注的轨迹数据来提高任务执行效率。
GRIF模型的结构包括哪些部分?
GRIF模型由语言编码器、目标编码器和策略网络组成。
GRIF模型在实验中表现如何?
实验表明,GRIF在多场景下表现优异,能够有效理解和执行复杂指令。
GRIF模型的对比学习是如何进行的?
GRIF通过对比学习显式对齐语言和目标任务的表示,以提高模型的学习效果。
GRIF模型的未来发展方向是什么?
未来可探索更丰富的语义对齐方法,以进一步提升机器人对语言指令的理解能力。
