提示工程学习笔记(二)
内容提要
本文介绍了增强语言模型的三种常见思路:检索增强、编程增强和工具增强。具体方法和应用包括RAG、PAL、PoT、TALM、Toolformer、ART、MRKL、ReAct、Self-ask、Plan-and-Solve Prompting和HuggingGPT。这些方法提高了大模型的推理和问题解决能力。
延伸解读
检索增强的实用价值与局限
检索增强生成(RAG)通过引入外部知识源,有效缓解大模型的幻觉问题,并提高答案的可解释性。其核心在于索引构建与检索生成两阶段,使模型无需重新训练即可获取最新信息。然而,RAG的效果高度依赖检索质量,若检索结果不相关,反而可能误导模型。此外,直接使用搜索引擎(如WebGPT)虽省去构建检索系统,但需依赖人工反馈或微调,灵活性各异。
编程增强:解耦推理与计算
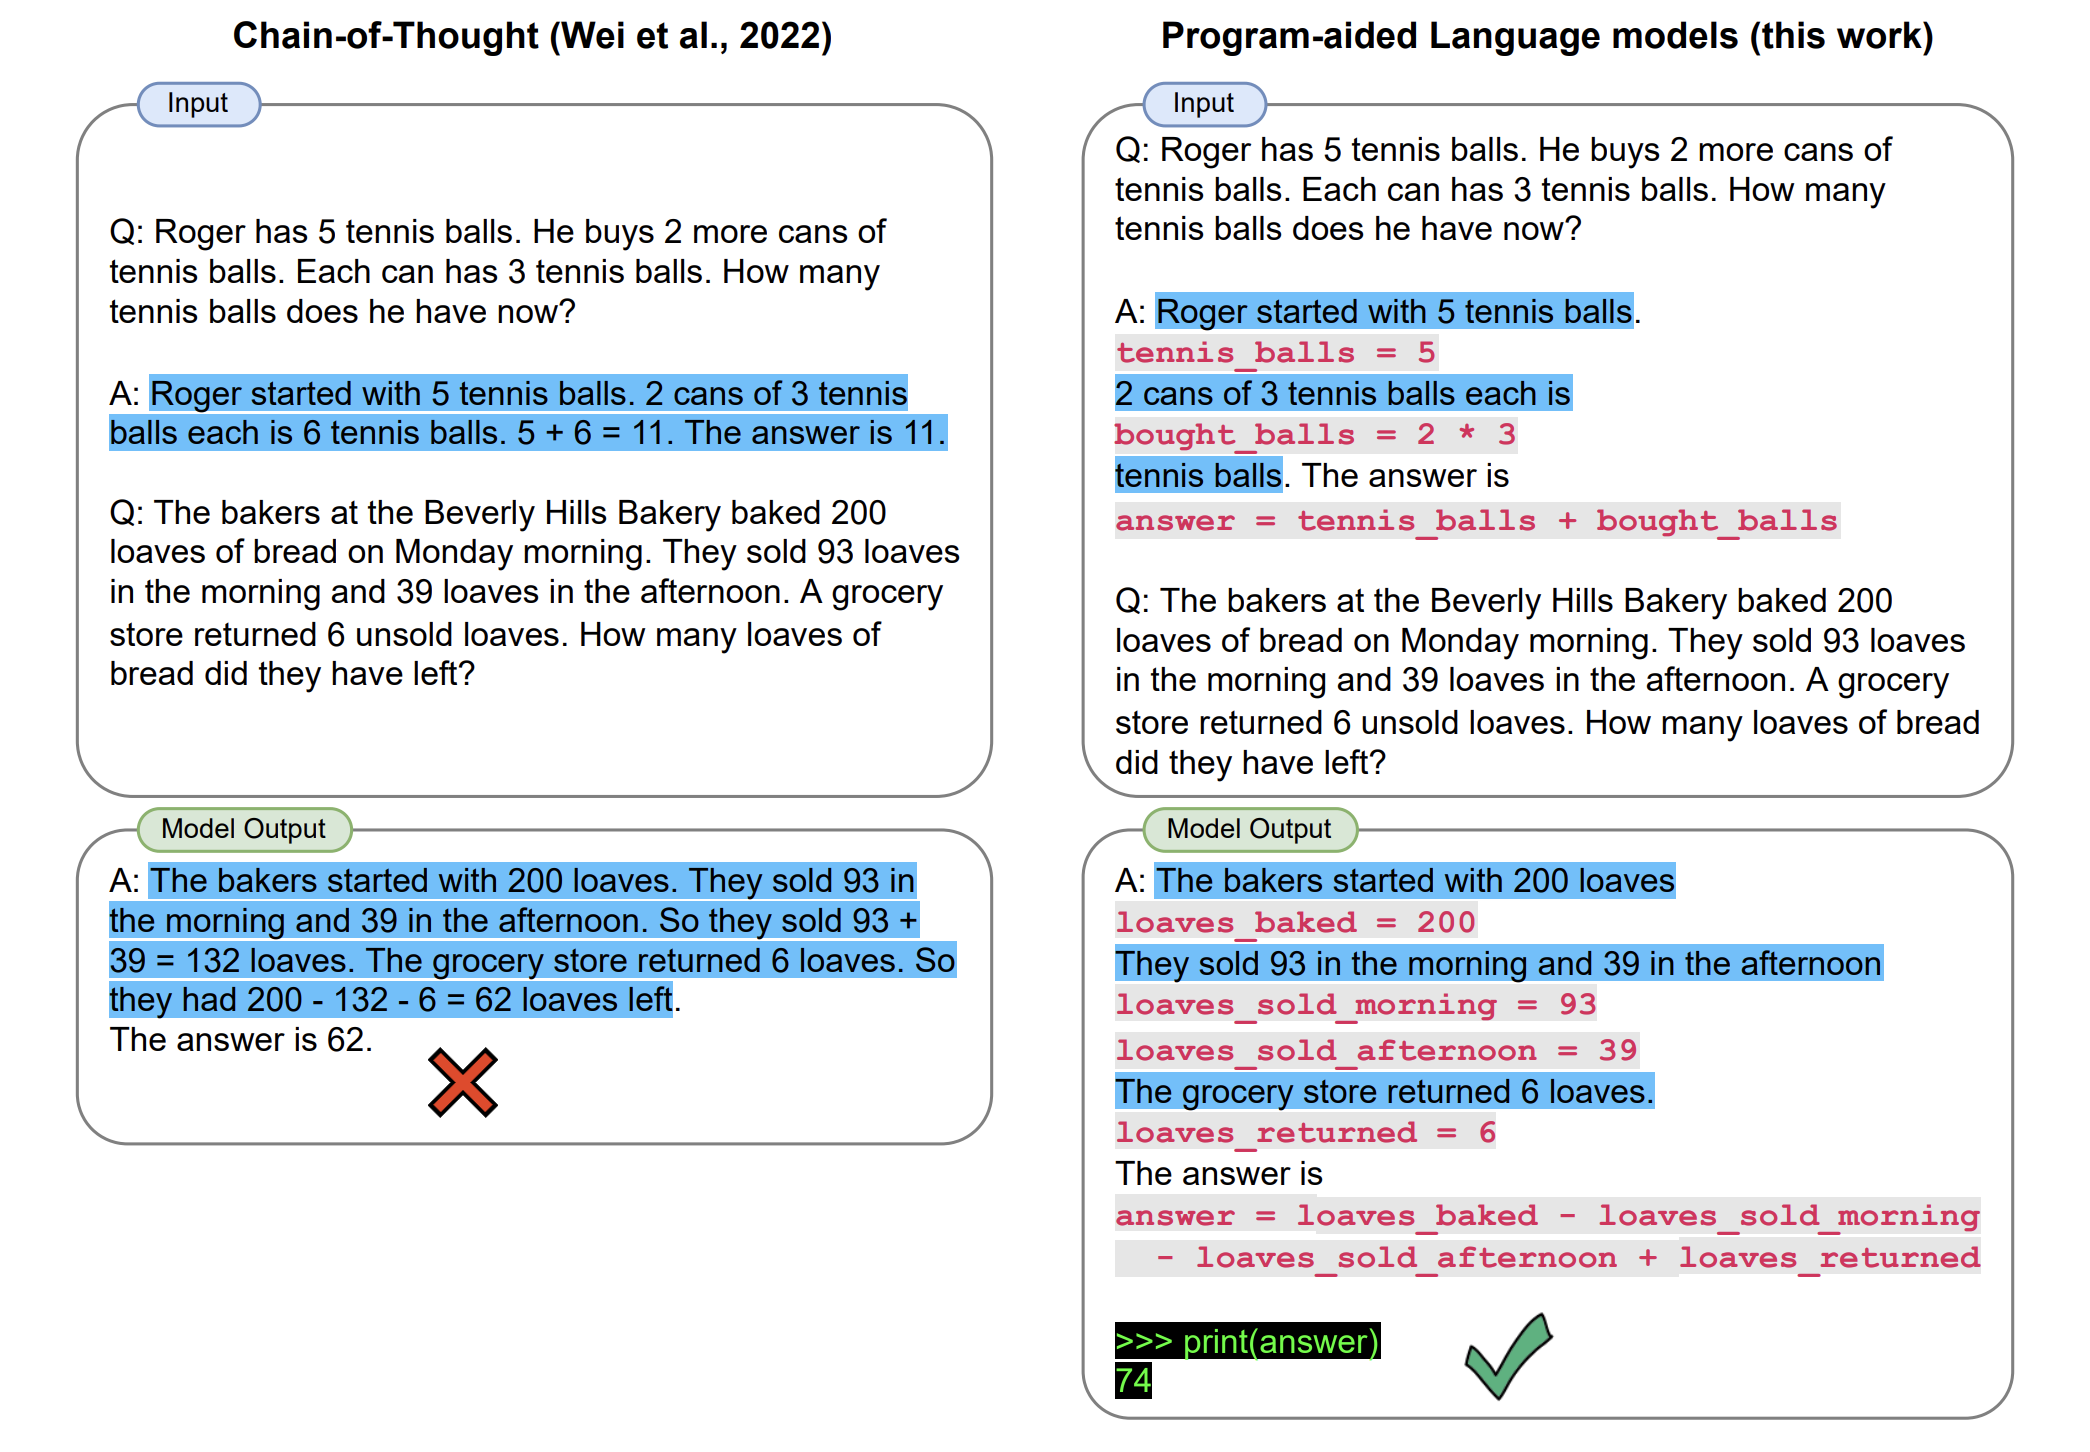
编程增强技术如PAL和PoT,将计算任务交给外部代码解释器,从而弥补语言模型在算术计算上的组合性差距。模型仅需生成自然语言与代码混合的推理步骤,由解释器执行得出结果。这种方法显著提升了数值任务的准确性,且少样本甚至零样本提示即可见效。但需注意,生成的代码必须正确无误,否则执行结果仍会出错。
工具增强的两种路径:微调与提示
工具增强让模型调用外部API扩展能力。TALM和Toolformer通过自我监督微调模型,使其学会何时及如何调用工具,但Toolformer不支持链式调用。ART则采用提示框架,无需微调,支持链式调用和人工反馈,更灵活。选择时需权衡:微调方案在复杂规划上更强,但灵活性差;提示方案开箱即用,但可能受限于示例质量。
任务规划与智能体框架
任务规划将复杂任务分解为子任务,并结合工具使用,形成智能体。ReAct通过交替生成推理轨迹和行动,提升可解释性和任务表现,但在HotpotQA上落后于CoT,且依赖检索信息质量。Plan-and-Solve Prompting提前制定计划再执行,适合长期目标,但本身不调用工具。HuggingGPT则利用ChatGPT调度Hugging Face模型,展示多模型协作潜力。这些方法各有侧重,实际应用常需组合使用。
Q&A
什么是增强语言模型?它主要解决大模型的哪些问题?
增强语言模型是通过检索增强、编程增强和工具增强等思路来提升大模型能力的模型。它主要解决大模型在简单计算错误、无法理解私有知识、产生幻觉以及组合性差距等问题上的不足。
RAG(检索增强生成)是如何工作的?它有什么好处?
RAG包含索引构建和检索生成两部分:先将数据分块并向量化存储,然后根据用户问题检索最相关的数据块,将其作为上下文与问题组合成prompt让大模型生成回答。好处是让模型不用重新训练就能获取最新信息,提高答案可靠性,并能给出引用来源,增强可解释性。
PAL和PoT这两种编程增强方法有什么共同点和区别?
共同点:两者都让语言模型生成自然语言和Python代码混合的推理步骤,然后通过Python解释器执行代码来得到最终答案,从而将计算与推理解耦,减小组合性差距。区别:PAL由Luyu Gao等人提出,PoT由Wenhu Chen等人提出,两者几乎同时发表,非常相似;PoT还分为少样本和零样本两种,且零样本PoT也能达到很好效果。
Toolformer和TALM在工具增强方面有什么不同?
TALM是工具增强语言模型的鼻祖,使用文本到文本的API调用方式,并通过自我对弈扩充工具使用示例数据集。Toolformer同样引导模型输出工具调用,但通过自我监督生成API调用数据集,支持计算器、QA系统、搜索引擎、翻译系统和日历五种工具。Toolformer的创新在于仅用少量人工标注样本制造大量自监督样本,但不支持链式工具使用和交互式使用。
ReAct框架是如何工作的?它有什么优势和局限性?
ReAct通过语言模型以交错方式生成推理轨迹和任务特定行动,推理轨迹帮助跟踪和更新计划,行动则与外部环境交互收集信息。优势:在知识密集型任务中克服幻觉和错误传播,生成可解释的解决轨迹;在交互式决策任务中成功率比模仿学习和强化学习分别高34%和10%。局限性:结构性约束降低推理灵活性,依赖检索信息质量,非信息性搜索结果会阻碍推理。
Plan-and-Solve Prompting与传统的零样本思维链提示有何不同?
Plan-and-Solve Prompting将零样本思维链中的“Let's think step by step”替换为“Let's first understand the problem and devise a plan to solve the problem. Then, let's carry out the plan to solve the problem step by step.”,即先制定完整执行计划,然后在不更新计划的情况下逐步执行。它本质上是一种提示技术,没有调用外部工具的能力,通常用于将复杂问题拆解成子任务,再结合Action Agent处理。
HuggingGPT是如何利用ChatGPT和Hugging Face模型来完成任务的?
HuggingGPT将ChatGPT作为控制器,首先对用户请求进行规划,拆分成不同子任务,然后在Hugging Face开源模型库中选择合适的AI模型完成子任务,最后汇总结果返回给用户。模型选择时根据下载量和任务相关性排序,选出top-K模型列表,由大模型选择合适的模型并执行。
