


Druid 获取连接异常导致应用挂起原因分析
内容提要
2021年12月数据库主备切换后,某Pod持续报GetConnectionTimeoutException并挂起。作者分析Druid 1.2.5源码发现,keepAlive机制可能将同一连接重复放回连接池,导致多个线程获取同一holder;释放时因active已为false,activeCount少减,逐渐虚高超过maxActive,使新连接无法创建而超时。该BUG在1.2.8修复,建议升级Druid并检查相关配置。
延伸解读
问题根源:keepAlive 重复放回连接导致计数失真
文章通过源码分析指出,Druid 1.2.5 的 keepAlive 机制在特定条件下会将同一个连接 holder 多次放回连接池,使池中出现重复 holder。当多个线程获取到同一 holder 并先后关闭时,只有第一次关闭会执行 activeCount--,后续关闭因 holder.active 已为 false 而跳过减一,导致 activeCount 逐渐虚高。最终 activeCount 超过 maxActive,新连接无法创建,获取连接超时。
触发条件:数据库异常与配置共同作用的小概率事件
该 BUG 并非必然出现,而是多个条件叠加的结果。数据库主备切换等异常会触发 keepAlive 保活逻辑,若此时连接空闲时间判断出现偏差,keepAlive 可能将连接重复放入池中。随后应用线程恰好获取到重复 holder,关闭时便造成 activeCount 少减。文章强调这是小概率事件,但数据库异常和不当配置会提升发生概率,且重启可暂时恢复,因此难以定位。
修复与预防:升级至 1.2.8 并检查关键配置
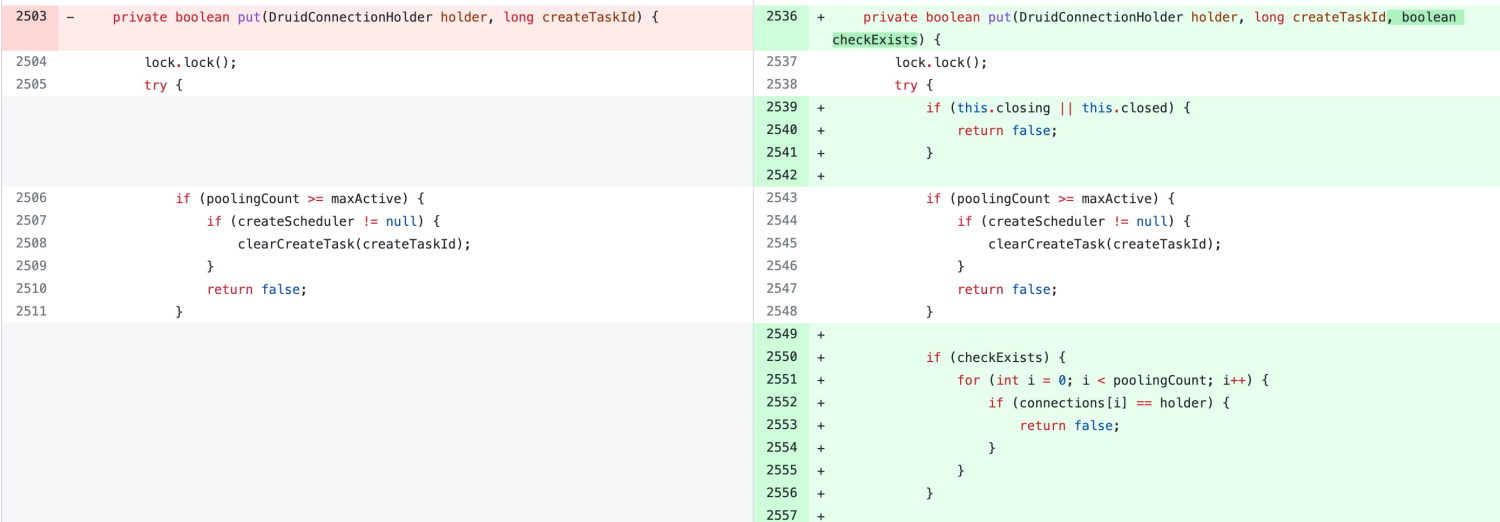
官方在 Druid 1.2.8 中修复了该问题,修复思路是在 keepAlive 放回连接时增加判断,避免同一 holder 重复进入连接池。文章建议将 Druid 升级到 1.2.8 以彻底解决。此外,应关注 keepAlive、minEvictableIdleTimeMillis、keepAliveBetweenTimeMillis、timeBetweenEvictionRunsMillis 等配置的合理性,减少因空闲时间判断错误而触发 BUG 的条件。
Q&A
Druid 1.2.5 中 GetConnectionTimeoutException 报错时 active 比 maxActive 还大,是什么原因?
这是 Druid 1.2.8 之前版本的一个 BUG。keepAlive 机制可能将同一个连接重复放回连接池,导致连接池中存在多个相同的 holder。当多个线程获取到同一个 holder 并释放时,由于 holder 的 active 属性已被第一个释放线程设为 false,后续释放不会再次减少 activeCount,导致 activeCount 少减,逐渐虚高超过 maxActive。
Druid 连接池中 activeCount 和 poolingCount 分别代表什么?
activeCount 是当前活跃连接数,每成功获取一个连接加一,释放时减一;poolingCount 是连接池中的连接数,放入连接时加一,取出时减一。
为什么数据库主备切换后,只有一个 Pod 持续报错并挂起,其他 Pod 很快恢复?
因为该 BUG 是小概率事件,需要多个巧合同时发生:数据库异常或配置不当导致 keepAlive 将连接重复放入连接池,且再次获取时连接空闲时间判断错误,使连接未被释放而是返回给应用。其他 Pod 未触发这些条件,所以能自行恢复。
Druid 的 keepAlive 机制是如何导致连接重复放入连接池的?
在 shrink 过程中,对于需要保活的连接,Druid 会调用 put 方法将其放回连接池,但 put 方法没有检查该连接是否已存在于连接池中。如果连接池中已存在相同 holder,就会造成重复。
如何彻底解决这个 Druid 连接获取超时导致应用挂起的问题?
将 Druid 升级到 1.2.8 或更高版本,该版本修复了 keepAlive 重复放入连接的 BUG。同时检查相关配置,如 keepAlive、minEvictableIdleTimeMillis、keepAliveBetweenTimeMillis 等,避免配置不当增加触发概率。
Druid 1.2.8 是如何修复这个 BUG 的?
官方在 1.2.8 版本中修复了该问题,主要是在 keepAlive 将连接放回连接池时增加判断,确保连接池中不会存在两个完全相同的 holder。
