

基于英国航空公司客户反馈数据的PySpark数据处理与分析
内容提要
本实验旨在对英国航空的客户反馈数据进行深入研究。通过应用Spark和Hadoop等大数据处理框架,以及数据可视化技术和机器学习算法,对数据进行存储、处理、分析和评分预测。实验环境搭建包括Linux、Hadoop、Spark、Python和JDK。数据集是英国航空的客户反馈数据,包含多个字段。数据预处理包括手工处理、导入和基本信息查询、数据清洗和文本规范化。数据分析包括乘客特征分析、乘客情感分析和航线表现分析。
延伸解读
数据清洗中的关键取舍
文章显示,原始数据集有3701条记录,但删除缺失值后仅剩2528条,损失约三分之一数据。其中'InflightEntertainment'和'Wifi&Connectivity'两列缺失率过高被直接删除,这虽然简化了分析,但也意味着后续关于机上娱乐和网络体验的结论将无法覆盖。读者需注意,这种处理方式可能引入偏差,因为缺失值并非随机分布,可能反映特定乘客群体或航班类型的反馈缺失。
情感分析阈值设定的影响
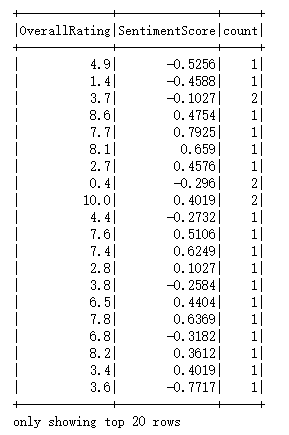
文章以总体评分6分为界,将评论分为积极和消极两组,并分别统计高频词。这一阈值是人为设定的,并非数据驱动。若调整阈值,高频词列表可能变化,进而影响对乘客关注点的判断。此外,情感分析仅基于评论标题,而非完整评论内容,可能遗漏详细反馈中的关键信息。读者在解读情感分析结果时,应意识到这些方法上的局限。
航线分析的范围限制
航线表现分析仅统计了出发地和目的地同时位于前十名的航线,这虽然能聚焦热门航线,但会忽略其他组合。例如,一个热门出发地搭配一个非热门目的地,或反之,都不会被纳入分析。因此,结论仅适用于最核心的航线网络,不能代表英国航空全部航线的表现。若需全面评估,应扩大分析范围或采用其他方法。
技术栈的版本与兼容性
实验环境使用了Ubuntu 22.04、Hadoop 3.3.5、Spark 3.2.0、Python 3.8.19和JDK 1.8。这些版本组合经过验证可协同工作,但读者在复现时需注意版本兼容性,尤其是Spark与Hadoop、Python与Spark之间的匹配。此外,实验依赖Jupyter Notebook和Matplotlib、Seaborn等库,requirements.txt文件提供了详细依赖,便于环境搭建。
Q&A
实验中使用了哪些大数据处理框架?
实验中使用了Spark和Hadoop等大数据处理框架。
数据预处理的主要步骤有哪些?
数据预处理包括手工处理、数据清洗和文本规范化。
实验的评分预测是如何实现的?
实验通过构建并训练机器学习模型来预测乘客对英国航空的评分。
乘客特征分析主要关注哪些方面?
乘客特征分析主要关注不同类型乘客的占比和舱位评分分布。
情感分析中探讨了哪些内容?
情感分析探讨了常见表扬词和批评词,以及情感分析与总体评分的相关性。
航线表现分析是如何进行的?
航线表现分析统计了Top10热门出发地和目的地的航线。
