
Jev判定模型的价值、用法与风险
内容提要
TypeSafe AI推出判定模型Jev,仅做是非、选择、评分三类判断,准确率约68%,但速度极快、成本极低,百万token仅4美分。适合替代昂贵的校验工序,用于语义防火墙、评论筛选等场景,不宜用于炒股、自动驾驶。风险在于刻板印象被自动化,且易被针对性优化。
延伸解读
Jev的定位:廉价判定器,而非全能AI
Jev是TypeSafe AI推出的判定模型,仅支持是非、选择、评分三类任务,准确率约68%,但速度极快、成本极低。它不生成内容,只做判断,适合替代昂贵模型执行校验、筛选等工序。读者需明确:它并非更聪明的大脑,而是将“下判断”这一环节从大模型中拆解出来,以极低成本单独提供。因此,在需要复杂推理、生成或高准确率的场景中,Jev并不适用。
适用场景:语义防火墙与评论筛选
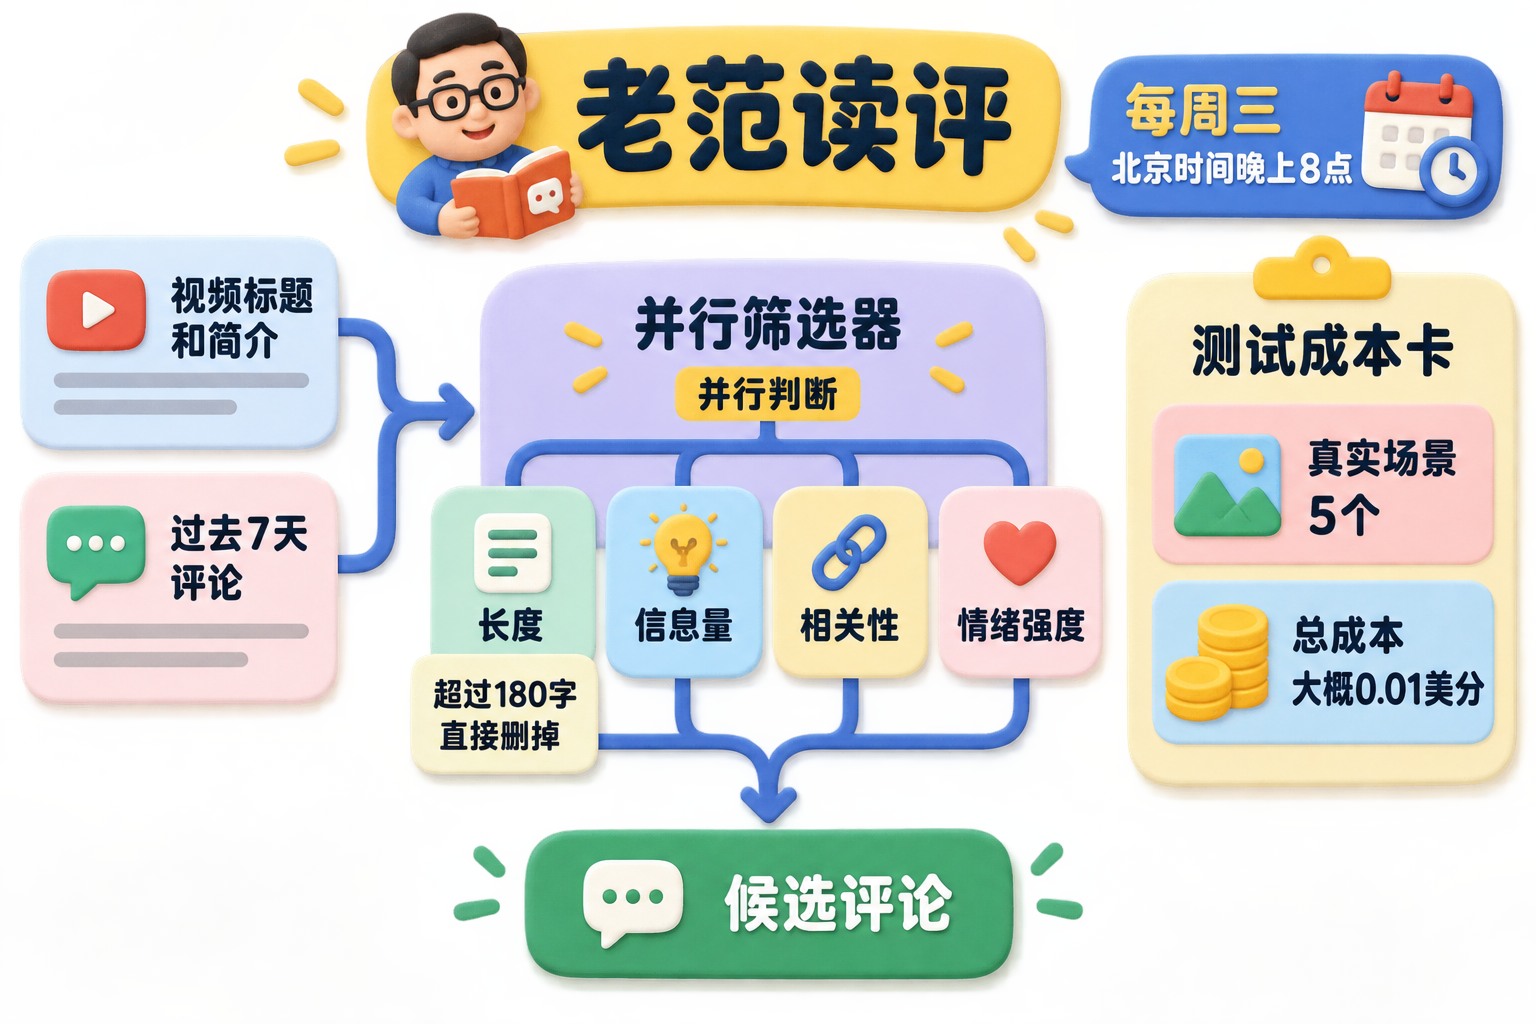
文章指出,Jev最适合用于语义防火墙、评论筛选、工具调用拦截等场景。例如,在Agent调用工具前,先用Jev判断是否必要,可拦截94%的错误调用,节省大量token。作者也将其用于每周评论筛选,成本几乎可忽略。这些场景的共同点是:判断逻辑简单、对准确率要求不高、但调用频繁,Jev的廉价和高速优势得以充分发挥。
风险警示:刻板印象自动化与针对性优化
Jev的准确率仅68%,且训练目标是符合人类第一印象,而非任务正确性。若在贷款审批、简历筛选等场景中盲目依赖其判断,可能自动化刻板印象,导致不公。此外,由于判定标准公开,内容生产者可能针对Jev进行生成式优化,让虚假信息“看起来更真”,从而获得更高评分。读者应警惕这些风险,避免将Jev用于高风险决策。
行业影响:短期承压,长期或迎杰文斯悖论
Jev的低成本可能减少验证环节的token消耗,对英伟达等算力供应商形成短期压力。但作者引用杰文斯悖论指出,当判断成本降至可忽略,应用场景将爆发式增长,长期反而推高总算力需求。同时,Jev技术门槛不高,可能很快被大厂复制,TypeSafe AI作为单一功能公司,商业变现前景有限,或被收购。
Q&A
Jev判定模型是什么?它和传统大语言模型有什么本质区别?
Jev是TypeSafe AI推出的判定模型,只做是非、选择、评分三类判断,不生成内容。与传统大语言模型(LLM)最本质的区别是:LLM生成内容,而Jev只负责下判断,相当于一个判官。它一次前向计算就输出结果,属于“快思考”系统一模型。
Jev模型适合用在哪些场景?哪些事情不能交给它做?
适合替代昂贵的校验工序,用于语义防火墙、评论筛选、工具调用判断等场景。不能用于炒币、炒股、量化交易,也不能用于自动驾驶和人形机器人的动作判断,因为它响应速度约300毫秒,远慢于自动驾驶所需的20毫秒,且只能处理文本,不能处理图片、视频和声音。
Jev模型的准确率如何?和其他模型相比有优势吗?
Jev的准确率约为67.8%,不到68%。同一套题中,GPT-5.6 Luna为66.8%,Terra为67.9%,Sonnet 5为67.8%,Opus 5为73.1%,GPT-5.6 Sol为74.1%。Jev的准确率属于中规中矩,它真正的优势是速度快和成本极低,而非准确率更高。
Jev模型的收费方式是怎样的?为什么说它成本极低?
Jev只收取输入费用,没有输出费用和缓存费用。输入上下文为32K,100万token仅4.2美分。因为输出只有几十到100字节的JSON结构化结果,所以输出免费。相比GPT-5.6,成本约为其二百分之一,效率快约400倍。
如何接入和使用Jev模型?需要编程基础吗?
可以通过官方waitlist排队,或通过Vercel等云服务平台绑定信用卡获取API key直接调用。不需要编程基础,可以找Codex、Claude Code等工具,告诉它要在Vercel上使用Jev模型并封装好,AI会自动完成。使用时要注意质量评估,并调整输入信息,最好通过程序或RAG整理数据后再喂给Jev。
Jev模型可能带来哪些风险?
主要风险有三:一是刻板印象被自动化,模型被训练成符合人类第一印象而非正确结果,且很多人只看判断结果不看置信度,可能导致冤假错案;二是容易被针对性优化,比如GEO可以针对Jev做专项优化,让内容“看起来更像真的”从而得分更高;三是可能加剧官僚主义,AI直接刷掉简历而不解释原因。
Jev模型对AI行业和算力股票会有什么影响?
Jev会大幅降低验证部分的token消耗,短期内可能对英伟达、美光、SK海力士等算力股票造成压力,因为算力需求可能下降。但根据杰文斯悖论,成本降低后应用场景会大量爆发,长期来看token使用量会翻番上涨,行业会先承压再腾飞。TypeSafe AI这类公司可能最终被大厂收购。
