2396名患者/4类数据/2条AI路线,I³LUNG联盟用多模态AI探索肺癌免疫治疗决策,表现超越PD-L1等传统指标
内容提要
I³LUNG国际联盟基于2396例晚期非小细胞肺癌患者数据,开发AI临床决策支持系统预测免疫治疗疗效。仅用临床-血液数据的模型内部测试AUC最高0.77,优于PD-L1等传统标志物。可解释AI工具显著提升医生预测准确率,非专家获益更大。研究发表于Nature Medicine。
延伸解读
临床落地优势:常规血液数据即可预测
研究显示,仅基于临床-血液数据(CB)的AI模型在内部测试中AUC最高达0.77,优于PD-L1等传统标志物。这意味着在无需额外影像或基因组检测的情况下,利用常规可得的血液指标和临床特征即可辅助决策,更易于在基层医院推广。但需注意,外部验证中性能有所下降,提示模型泛化能力仍需进一步验证。
多模态融合的潜力与局限
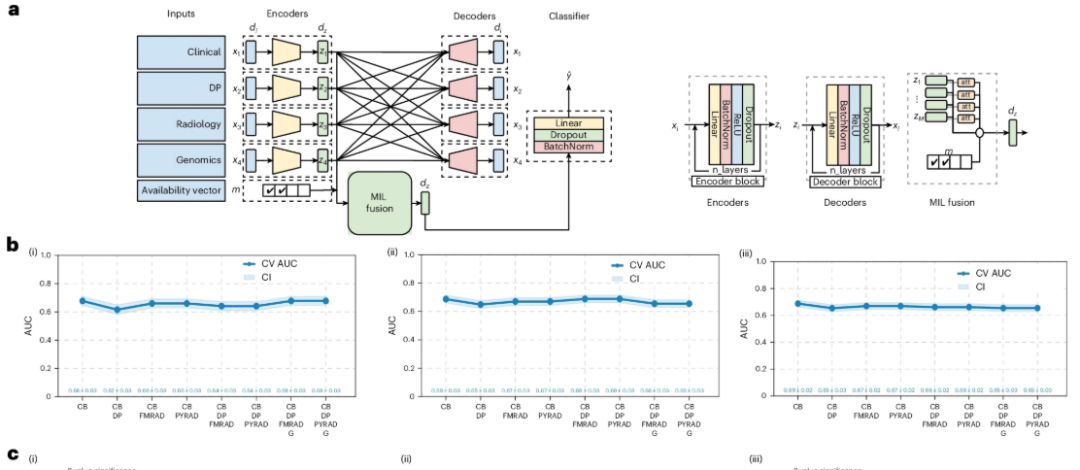
多模态模型(结合CT、数字病理等)在交叉验证中相比单模态CB模型有显著提升,例如预测OS24时AUC从0.60提升至0.72。然而,这些增益在独立测试集和外部验证集中未能一致复现,且深度学习中间融合(DLIF)并未比机器学习早期融合(MLEF)带来额外收益。此外,完整多模态数据患者数量有限,限制了多模态分析的可靠性。
可解释AI显著提升医生决策准确性
在临床可用性研究中,20名医生(含专家与非专家)使用可解释AI工具后,预测疾病控制率(DCR)的敏感性从0.72提升至0.87,准确率从0.57提升至0.65。非专家医生的准确率提升幅度(53%)高于专家(23%),表明该工具有助于缩小不同经验水平医生之间的差距,尤其在资源有限场景下具有潜在价值。
公平性评估揭示中心间差异
模型公平性分析发现,以临床中心为保护属性时,不同中心的预测灵敏度存在差异,例如MH中心在OS6预测上的灵敏度(0.96)显著高于其他中心。而在性别和种族维度上未观察到显著差异。这提示在多中心应用中,需关注机构间数据分布差异对模型性能的影响,并考虑本地化校准。
Q&A
I³LUNG联盟的研究主要想解决肺癌免疫治疗中的什么问题?
该研究旨在解决晚期非小细胞肺癌(NSCLC)免疫治疗中,仅20%-30%患者能长期获益、多数患者面临耐药,而传统生物标志物PD-L1预测效能不理想的问题,通过AI临床决策支持系统实现个体化疗效精准预测。
I³LUNG研究使用了多少患者数据?来自哪些中心?
研究纳入2012年9月至2023年10月间接受免疫治疗的2396名IIIC至IVB期NSCLC患者,来自欧盟内外六个临床中心:意大利INT、希腊MH、德国GHD、西班牙VHIO、美国芝加哥大学UOC和以色列SZMC。
研究中AI模型用了哪些类型的数据?
数据集包含四类模态:临床-血液(CB)数据、CT影像、数字病理切片(DP)和基因组学信息。CB数据最终选定9项特征用于模型开发,包括性别、ECOG PS评分、吸烟状况、PD-L1表达、骨/肝/脑转移状况、NLR和LDH。
I³LUNG研究提出的两种AI技术路线是什么?它们有什么区别?
两种路线是MLEF(机器学习早期融合)和DLIF(深度学习中间融合)。MLEF将不同模态特征直接拼接后送入传统机器学习,无法处理模态缺失;DLIF基于注意力机制的多实例学习,支持模态缺失,能整合四类数据,但性能与机器学习相当。
仅用临床-血液数据的AI模型预测效果如何?与传统指标相比怎样?
仅用CB数据的模型在内部测试集中AUC最高达0.77,在OS24预测上AUC为0.74,外部验证为0.60。在C23测试中,AI模型预测OS24的AUC(MLEF 0.74,DLIF 0.73)均优于单一传统生物标志物PD-L1(0.53)、ECOG PS(0.62)、LDH(0.58)和NLR(0.66)。
可解释AI工具在临床可用性研究中对医生预测能力有何帮助?
在DCR预测中,医生与XAI协作使敏感性从0.72提升到0.87,准确率从0.57提高到0.65;非专家敏感性从0.77提升到0.90,专家从0.68提升到0.83。使用XAI使医生正确预测DCR的准确率提高37%,非专家和专家分别提升53%和23%。在OS预测中,所有医生正确预测概率提高36%,非专家提高61%。
这项研究存在哪些局限性?
研究存在回顾性设计、真实世界数据异质性可能影响模型性能、完整多模态病例数量相对较少从而限制多模态分析可靠性等局限性。
