


隆重推出 MongoDB Google ADK 集成:为智能体状态提供持久化记忆
内容提要
MongoDB与Google ADK集成,为AI智能体提供持久化会话与记忆存储:MongoDbSessionService保存会话、事件和状态,MongoDbMemoryService支持跨会话记忆检索。结合MongoDB向量搜索与混合检索,智能体可直接查询业务数据,无需额外向量数据库或同步管道。支持Atlas及自管理MongoDB 8.0+,简化从原型到生产的部署。
延伸解读
会话与记忆服务的分工
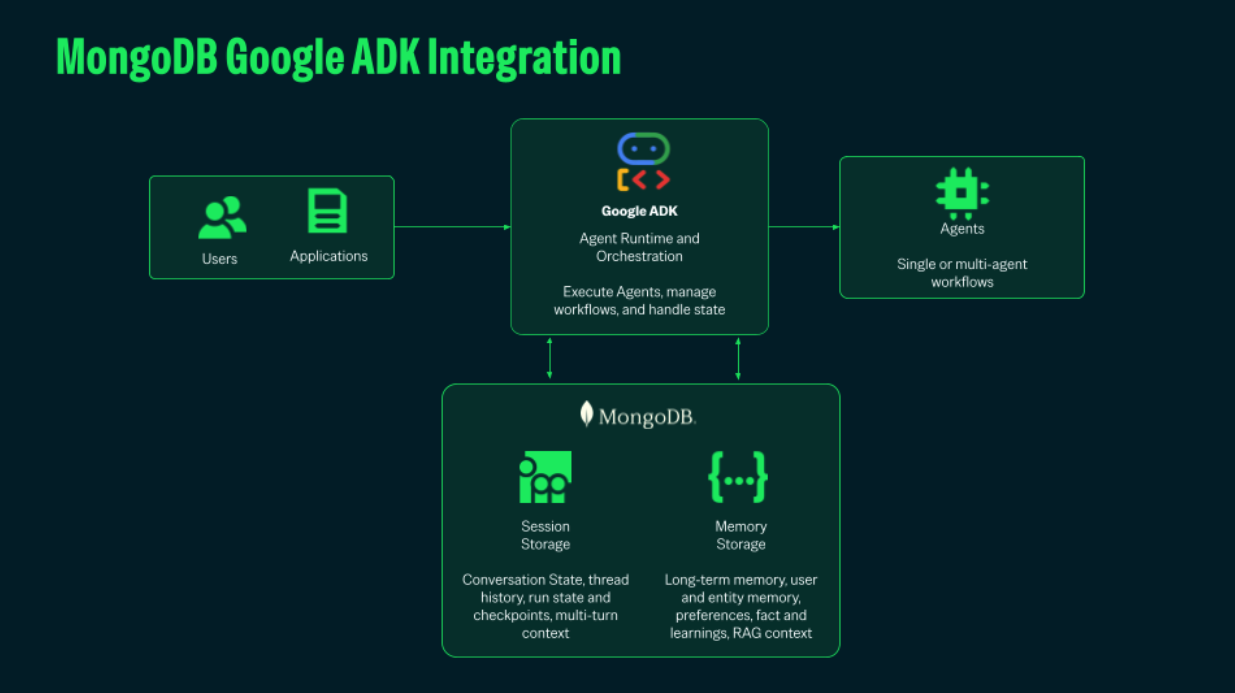
MongoDbSessionService 负责持久化会话、事件及多级状态,并内置乐观并发控制,适合多轮交互和并发更新场景。MongoDbMemoryService 则将会话事件摄入集合,通过关键词匹配实现跨会话记忆检索,且摄入操作幂等,避免重复。两者结合,让智能体在重启或横向扩展后仍能保持上下文,无需自建状态管理工具。
统一数据层减少系统拼接
该集成将智能体搜索的业务数据、会话状态和长期记忆统一存放在 MongoDB 中,省去了为检索单独部署向量数据库、或通过管道同步数据到记忆索引的步骤。这降低了系统间跳转带来的延迟,也简化了从原型到生产的架构。开发者无需在多个存储系统间维护一致性,应用数据与智能体状态天然共处一地。
检索能力与部署灵活性
MongoDB Vector Search 基于 Voyage AI 嵌入模型,并支持通过 $rankFusion 聚合阶段融合向量与全文搜索,实现混合检索。智能体可通过 MongoDbToolset 调用搜索工具,而连接串、库名等细节由应用掌控,不暴露给智能体上下文。集成支持 Atlas 及自管理 MongoDB 8.0+,并允许通过 MongoDbToolSettings 配置索引名、嵌入字段等参数,便于适配现有数据模型。
Q&A
MongoDB Google ADK 集成是什么?它主要解决什么问题?
MongoDB Google ADK 集成是 MongoDB 与 Google ADK 的官方集成,为 AI 智能体提供持久化的会话与记忆存储。它解决了开发者在构建智能体时需自行搭建数据存储工具的问题,让开发者能使用 MongoDB 作为智能体状态的数据平台,实现从原型到生产的平滑过渡。
MongoDbSessionService 和 MongoDbMemoryService 分别有什么作用?
MongoDbSessionService 用于将会话、事件以及应用级、用户级和会话级状态持久化到 MongoDB,支持多轮交互和乐观并发控制。MongoDbMemoryService 则负责将会话事件摄入 MongoDB 集合,并通过关键词匹配召回相关记忆,实现跨会话的记忆检索,且摄入操作是幂等的,避免重复。
这个集成如何帮助智能体进行数据检索?需要额外部署向量数据库吗?
集成利用 MongoDB 内置的向量搜索和混合搜索(通过 $rankFusion 聚合阶段结合向量与全文搜索)来帮助智能体快速检索业务数据。开发者无需额外部署向量数据库或构建同步管道,因为 MongoDB 同时作为操作数据存储、记忆层和搜索引擎,减少了系统间延迟。
使用 MongoDB Google ADK 集成需要什么版本的 MongoDB?支持哪些部署方式?
该集成支持 MongoDB Atlas 以及自管理的 MongoDB 8.0+ 部署,用于向量搜索和混合搜索。开发者可以提供连接字符串或使用现有的 PyMongo 客户端,并通过 MongoDbToolSettings 配置搜索行为,包括索引名称、嵌入字段、限制和候选数量等。
如何安装 MongoDB Google ADK 集成?
可以通过 pip 安装,命令为:pip install google-adk[mongodb]。安装后即可在 Google ADK 项目中使用 MongoDB 的会话和记忆服务。
这个集成如何简化智能体从原型到生产的部署?
集成提供了 ADK 原生的体验,开发者可以用 MongoDB 统一存储智能体搜索的数据、需要持久化的会话状态以及长期记忆,无需为检索单独搭建数据库或同步数据到其他记忆索引。同时,ADK 2.0 提供部署框架和标准化工具调用接口,结合 MongoDB 的持久化层,使智能体能够跨会话保持用户历史,并独立于单台机器运行,从而简化生产部署。
