文章从Personal Agent记忆切入,质疑通用Memory API的商业价值:记忆与产品设计、架构及模型深度耦合,检索结果是否进入上下文取决于Agent的工作方式,难以标准化。作者认为Search更接近通用基础设施,并以Turbopuffer为例,分析其基于对象存储的索引设计、冷查询代价与多租户挑战,指出其正从向量搜索走向通用查询系统。
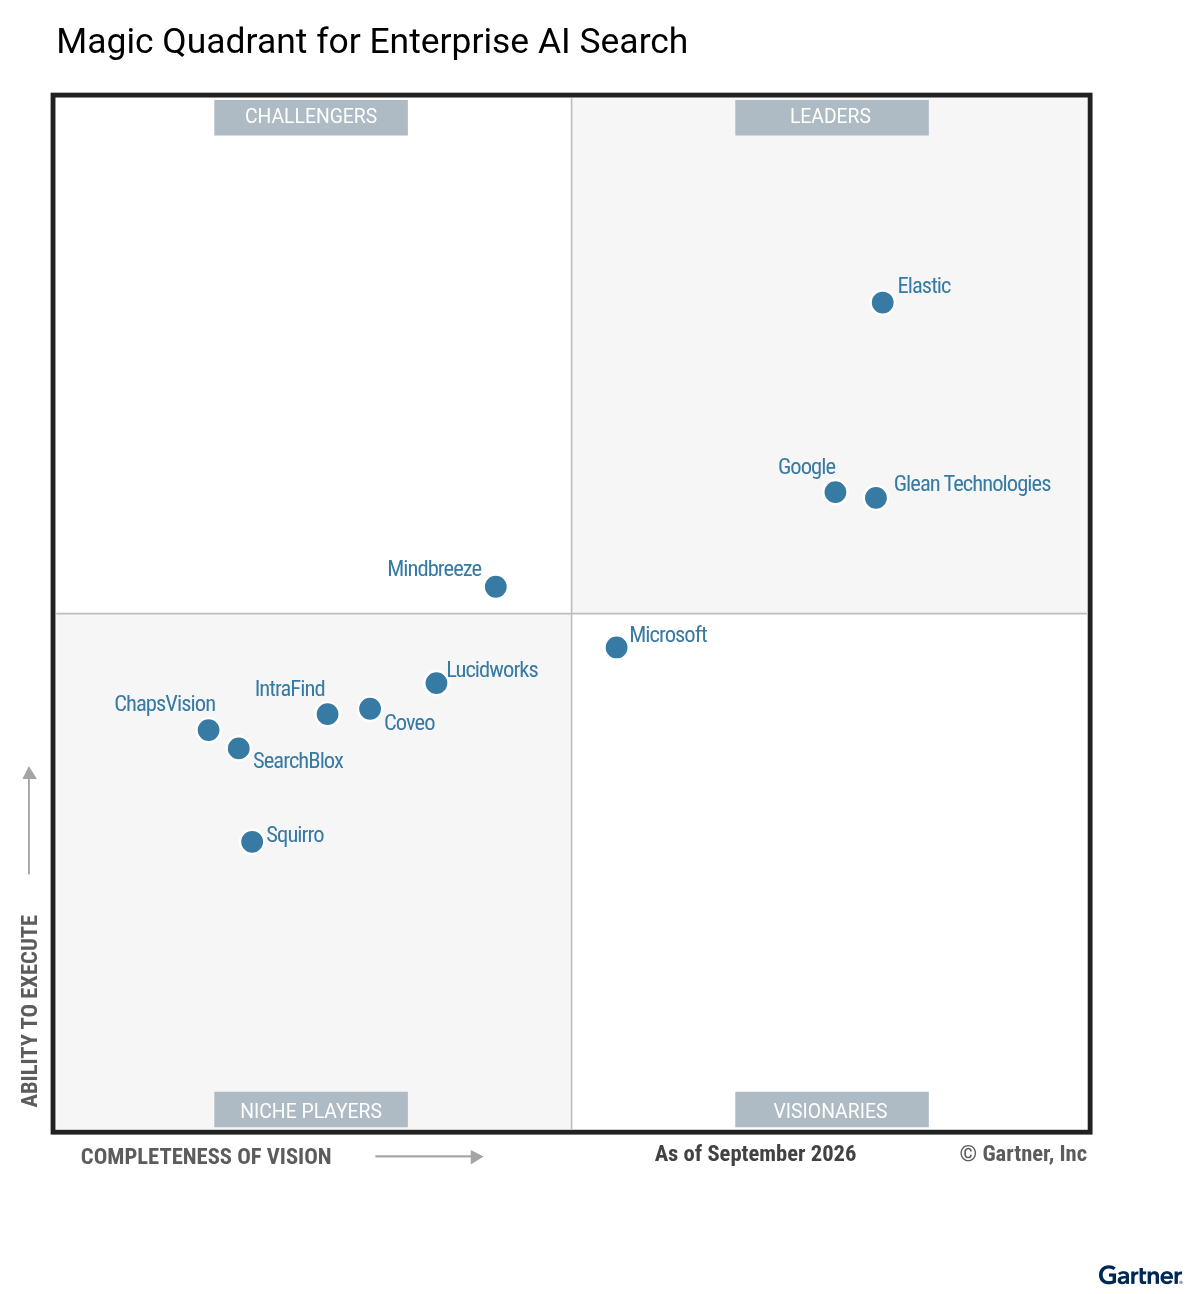
Elastic在2026年Gartner企业AI搜索魔力象限中被评为领导者,仅三家厂商入选,且在执行能力和愿景完整性上均居首位。在关键能力报告中,Elastic的AI自动化用例排名第一。其Elasticsearch平台融合全文、语义与混合搜索,为AI代理提供精准上下文,已服务超1.8万家企业,并持续投资向量搜索与AI检索。
Databricks将向量搜索实现为原生SQL的top-k排序连接(NEAREST BY),而非依赖外部实时端点。它将批量向量搜索视为大规模连接,借助Photon的融合GEMM内核、SIMD距离函数和分组top-k聚合,并支持以Delta表存储的IVF索引加速近似查询,在十亿级向量上兼顾性能、容错与成本。
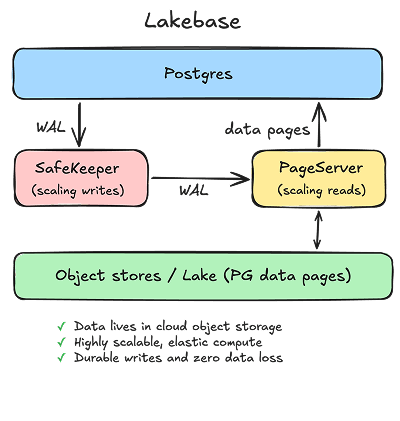
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
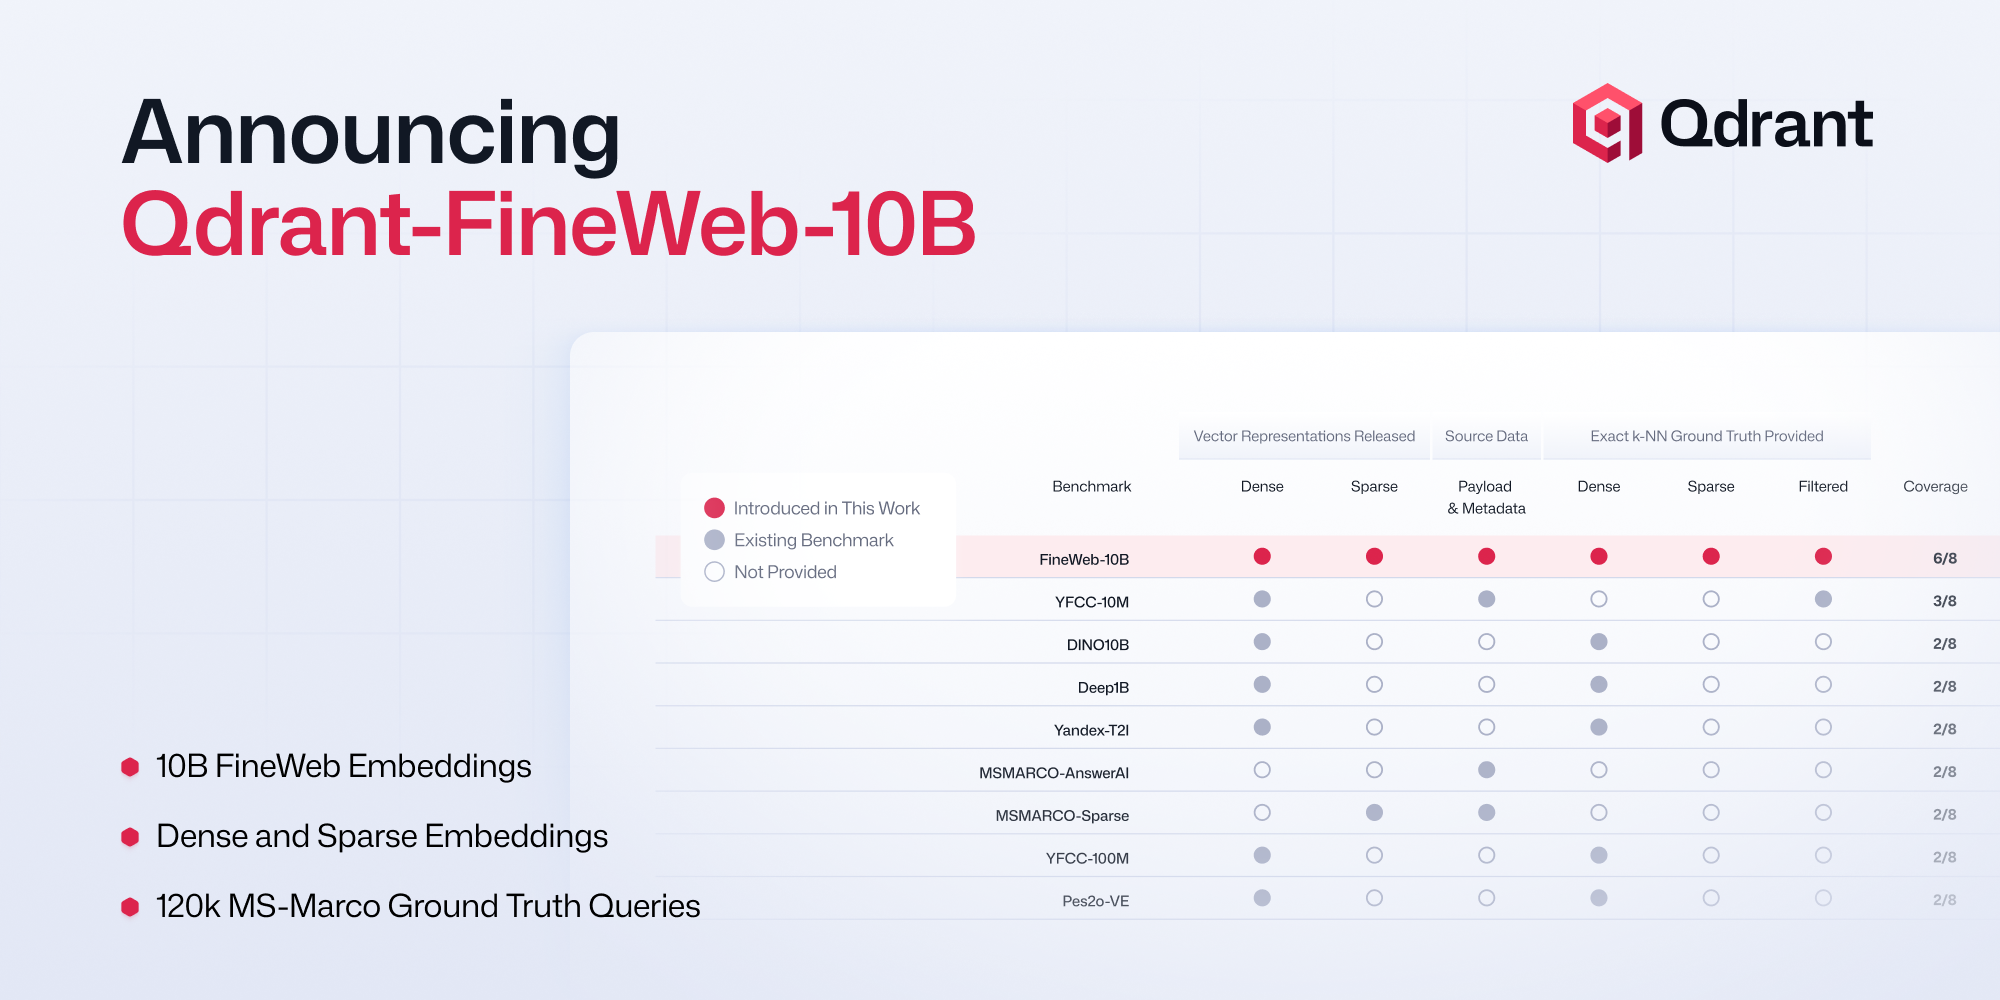
Qdrant发布全球最大开源向量搜索基准数据集Qdrant-FineWeb-10B,含约25TB向量数据及精确ground truth,并开源Supernova框架,支持分布式嵌入生成、暴力KNN计算和性能评测,旨在替代合成基准,推动生产级向量搜索的可靠性与可复现性。
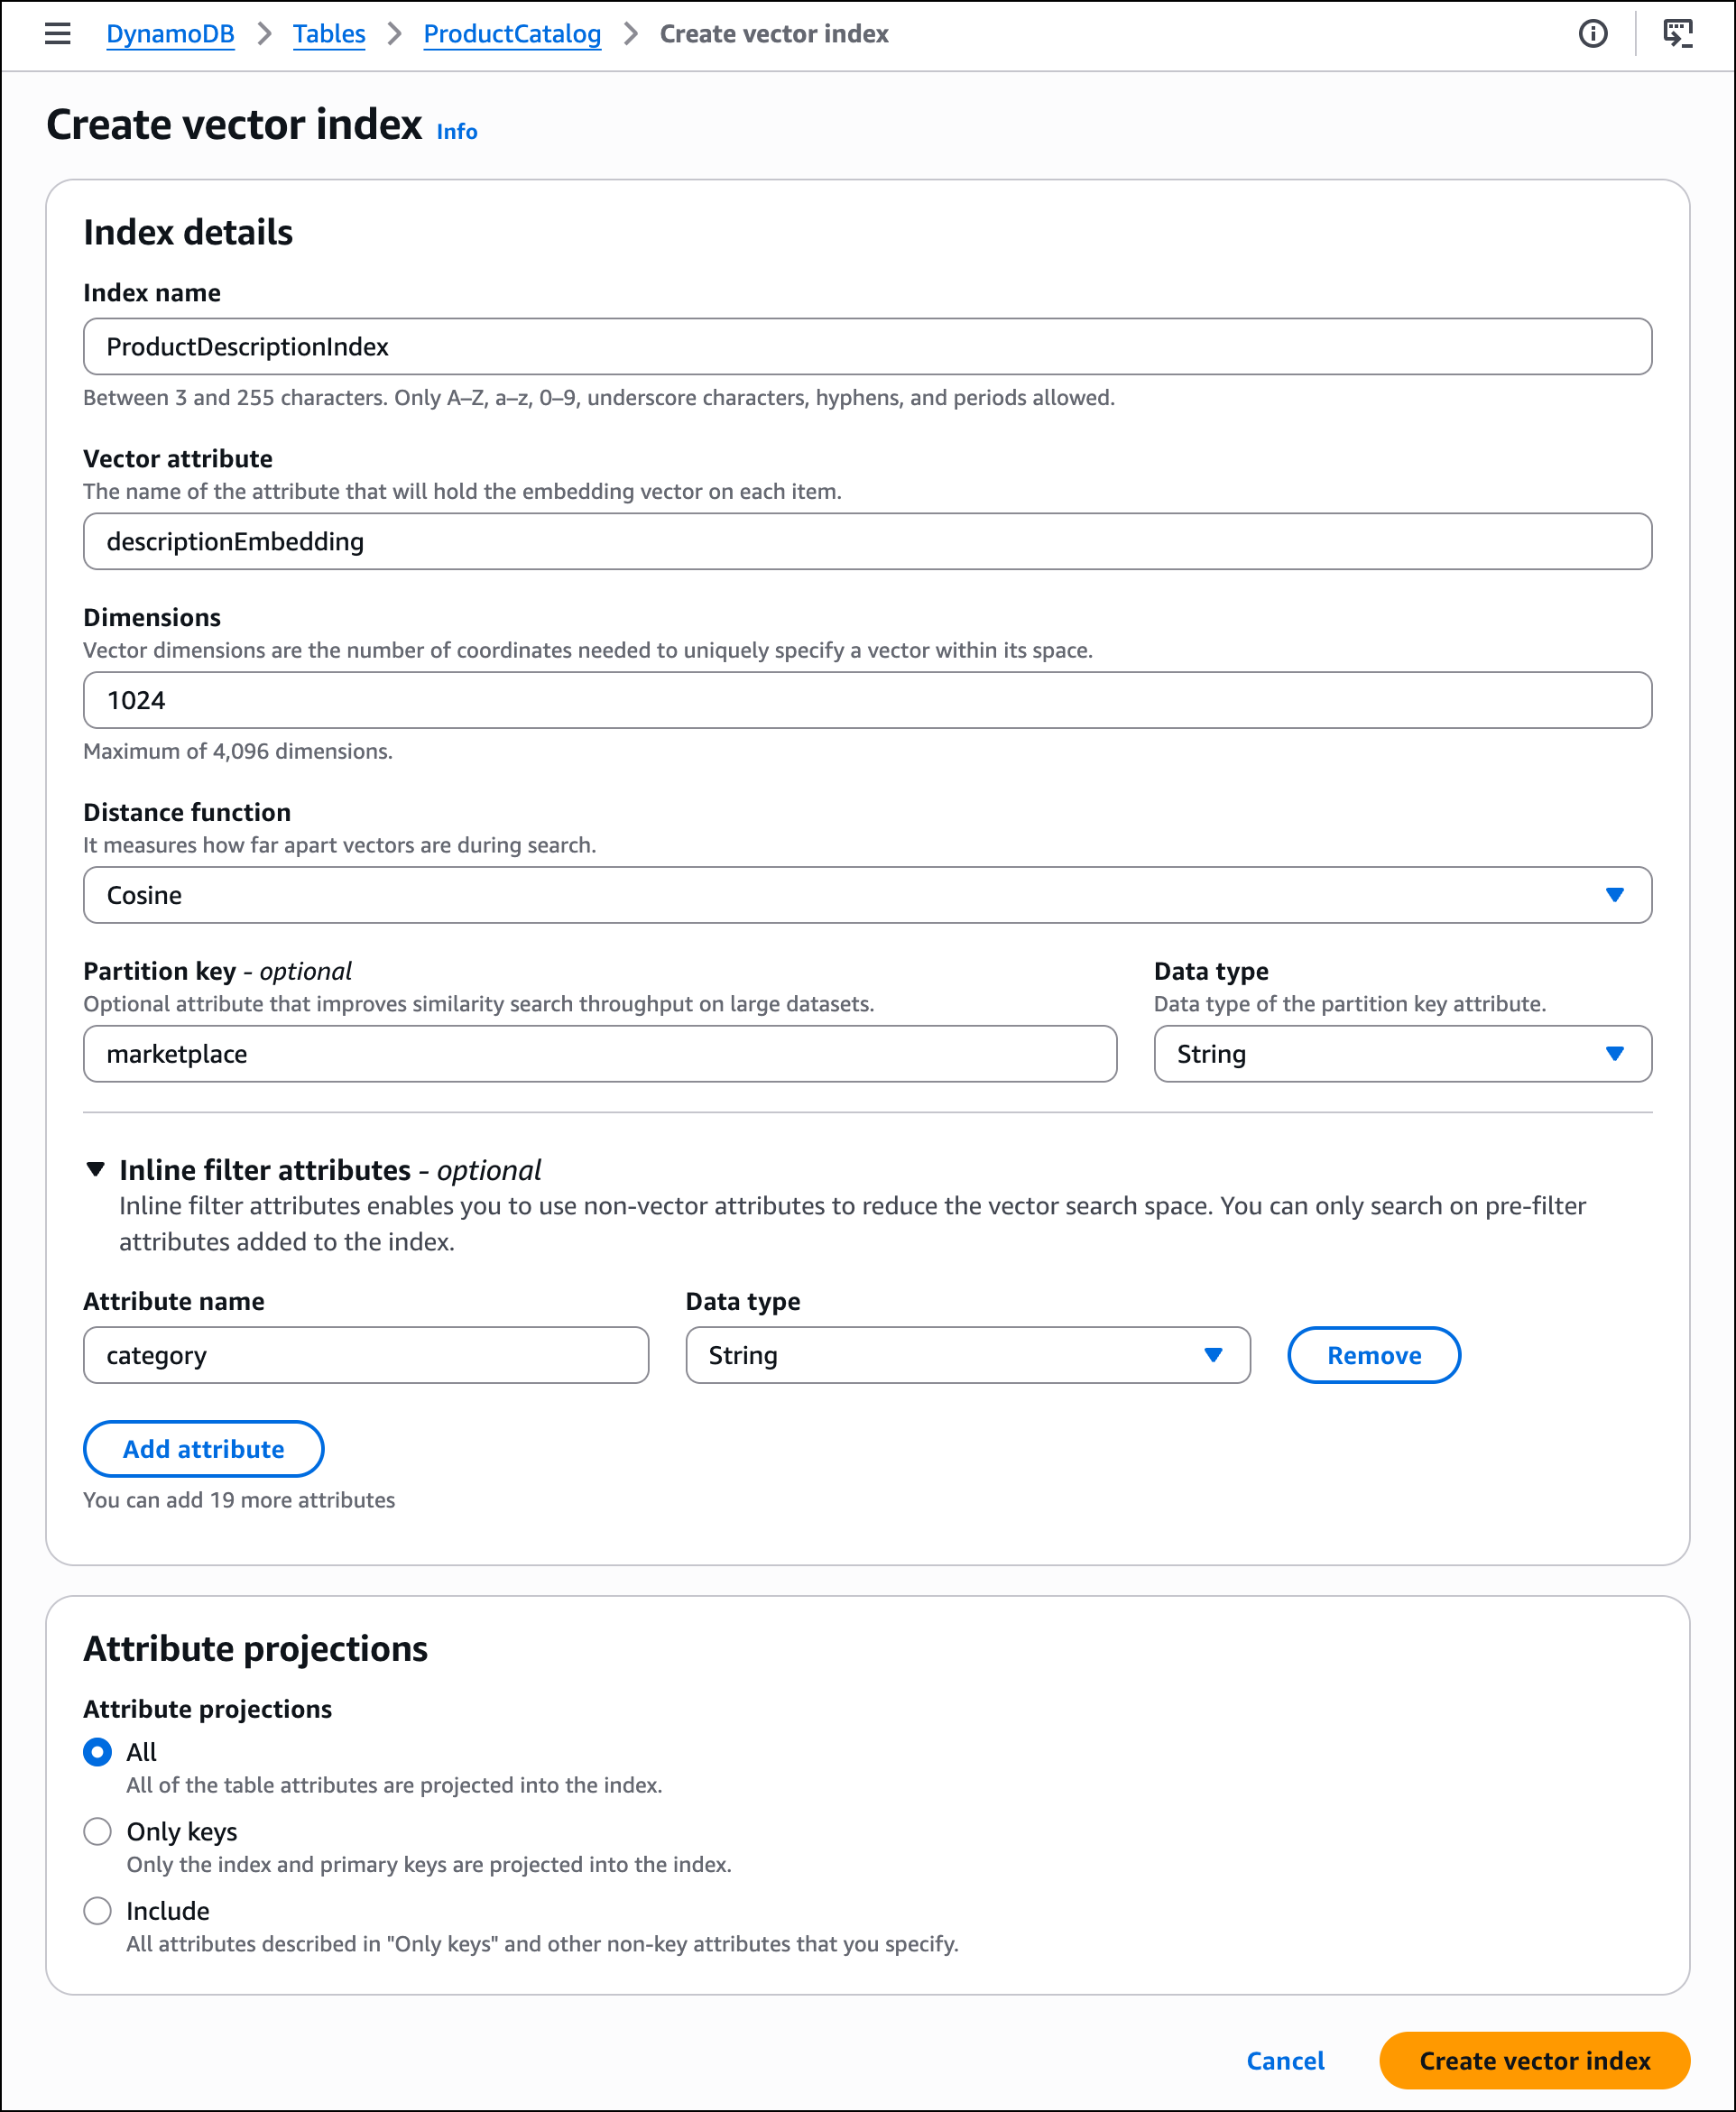
本文介绍如何用Amazon DynamoDB原生向量搜索构建Agent长期记忆,无需双写。通过将业务属性和embedding存入同一item,用一次PutItem写入,SearchVectors语义召回,Query按时间读取。文章涵盖数据模型、建表、写入、检索细节,并指出分区键非安全边界、等值过滤限制、成本按字节计费等注意事项,适合操作型数据已在DynamoDB的场景。
本文基于五个数据集,系统分析了向量搜索中七个关键设置、检索深度、融合参数、重排序器及量化重打分的影响,指出默认参数常导致性能下降,如RRF的k值调整可显著影响结果。建议先检查基础设置,再针对检索不足、排名错误或延迟增加等问题,采取数据驱动的调优策略,以科学提升搜索质量。
本文介绍如何利用DynamoDB原生向量搜索与Bedrock构建统一AI代理架构。该方案将操作数据与向量嵌入存储在同一DynamoDB表中,通过Lambda调用SearchVectors实现语义搜索,并利用DynamoDB Streams自动生成嵌入,避免单独向量数据库,降低基础设施成本与同步复杂性,适用于频繁更新且需实时搜索的文档管理场景。
Qdrant 1.19 推出 turbo4 数据类型,将稠密向量以每维 4 位存于磁盘,存储降至 float32 的八分之一,召回率仅小幅下降。教程以宠物用品搜索为例,用 ColBERT 多向量存为 turbo4,配合 BM25 稀疏向量:先用 BM25 预取候选,再用 ColBERT 后期交互重排,兼顾速度与精度。
元数据过滤通过叠加结构化约束(如价格、状态、租户ID)于向量相似性搜索,确保结果既相关又合规,显著提升准确性(如从0.12升至0.61)。预过滤与后过滤影响召回和延迟,混合查询结合关键词与向量搜索增强效果。统一引擎(如Redis)避免数据同步问题,保持一致性,适用于RAG和多租户场景。
本文探讨向量搜索在生产环境中的应用,涵盖嵌入模型将数据转换为数值向量、通过距离度量相似性,并比较FLAT与HNSW索引在精度和速度上的权衡。文章指出内存占用、过滤召回率及嵌入漂移等常见挑战,强调需持续监控性能。最后推荐Redis Iris作为实时上下文引擎,整合向量搜索、缓存和会话数据,以简化AI应用架构。
本文介绍向量搜索数据库的现状与选型要点。它通过向量嵌入将语义转为数值,用HNSW等算法快速检索近似邻居,支撑RAG、语义缓存和智能体记忆等AI工作负载。2025-2026年,向量搜索融入现有数据平台,混合检索成主流,智能体驱动需求增长。选型需关注过滤性能、尾延迟和系统集成。Redis提供内存向量搜索、语义缓存和智能体记忆,实现低延迟上下文管理。
亚马逊云科技宣布DynamoDB向量搜索功能正式可用,用户可直接在DynamoDB上构建AI应用,无需独立向量数据库。该功能支持原生索引、弹性扩展、4096维向量及多种距离度量,实现毫秒级延迟和高召回率,采用按量付费模式,并与Bedrock等深度集成,简化了AI Agent开发,降低了系统复杂度。
本文探讨AI代理的记忆机制,强调其从无状态检索系统向学习系统转变的价值。记忆分为短期与长期,涵盖语义、情景和程序类型。通过持久化写入、管理和召回循环,代理能提升任务完成率,但需注意范围、保留策略和访问控制以避免数据泄露。Redis提供实时基础设施,支持向量搜索和语义缓存,加速记忆召回,帮助团队构建难以复制的竞争优势。
Percona MongoDB Operator 1.23.0发布,新增ClusterSync迁移、向量搜索及PVC快照备份功能。另有文章介绍如何从MySQL Galera集群迁移至Percona XtraDB集群。
Qdrant在向量搜索中采用过滤内置于搜索的方式,而非预过滤或后过滤。预过滤成本高,后过滤可能返回不足。Qdrant通过HNSW图遍历时检查过滤条件,并用Filterable HNSW和ACORN修复严格过滤导致的路径断裂。查询规划器按过滤匹配度选择路径,如过滤索引或全扫描,确保高效准确。
Cerebras知识库通过混合检索系统解决企业知识管理难题,结合向量搜索、全文匹配、时间衰减和RRF融合,直接索引Slack、代码仓库等原始数据,无需员工改变习惯。按项目范围过滤噪音,支持增量更新和MCP轻量工具,日均处理15000次提问,强调精准而非全面,实用至上。
Amazon DynamoDB正式推出向量搜索功能,支持将向量嵌入与操作数据共同存储,无需复制到独立向量数据库。该功能提供毫秒级延迟、高召回率,可扩展至数万亿向量,支持最多4096维度及多种距离函数。用户可通过控制台或API创建向量索引并运行相似性搜索,适用于语义检索、推荐系统等场景,已在所有商业AWS区域可用。
本文比较了Redis与专用向量数据库(如Pinecone、Milvus、Qdrant)及pgvector的优劣。Redis作为统一实时平台,整合向量搜索、语义缓存、会话管理等功能,可降低基础设施复杂性和LLM成本,适合混合工作负载。专用数据库在超大规模或特殊调优时更优,pgvector适合小规模场景。选择取决于架构需求、运维能力和成本考量。
文章探讨了AI应用中延迟对回答质量的影响,指出延迟不仅是速度指标,更是质量指标,因为系统超时会降级检索或推理,导致答案质量下降。延迟分布在检索、模型执行和服务间跳转等阶段,需按阶段监控百分位数。Redis Iris通过语义缓存和低延迟向量搜索减少检索延迟,从而帮助维持回答质量。
完成下面两步后,将自动完成登录并继续当前操作。