


推出LlamaCloud和LlamaParse
内容提要
LlamaIndex推出了LlamaParse,一种新一代的解析、摄取和检索服务,旨在提升LLM和RAG应用的上下文增强能力。该服务专注于复杂文档的解析,支持PDF等格式,帮助企业快速处理数据,提高响应质量。LlamaParse现已公开预览,用户可通过API轻松加载和处理数据,解决数据同步和准确性问题。
延伸解读
LlamaParse 的定位与核心能力
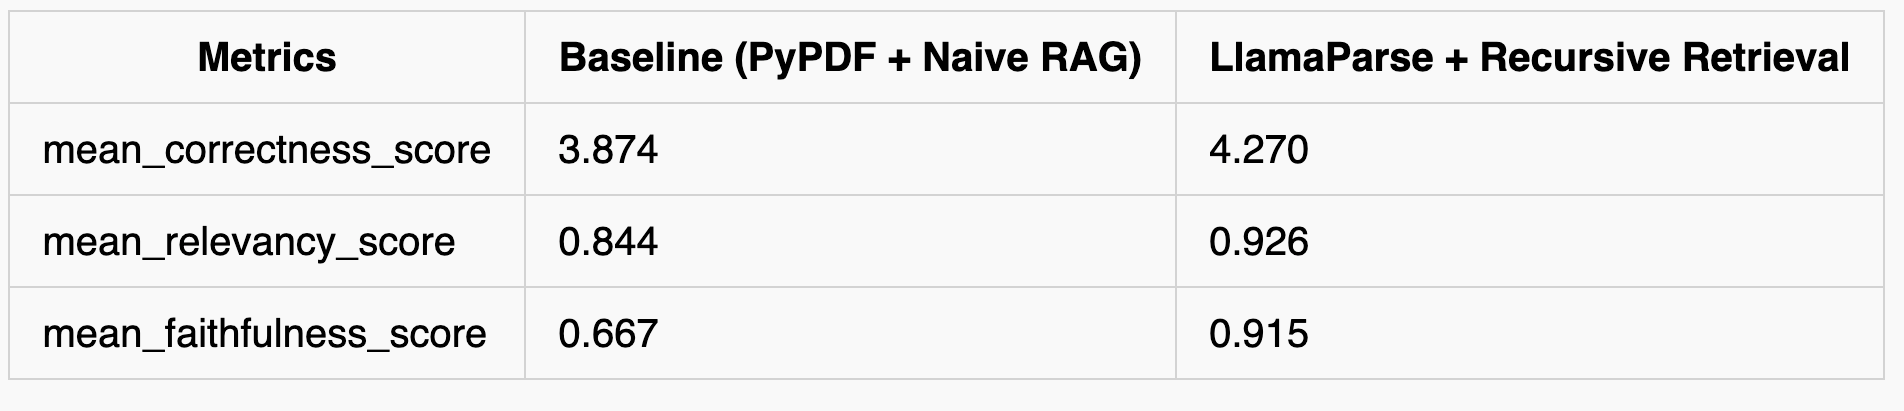
LlamaParse 是 LlamaIndex 推出的专有解析服务,专注于处理包含表格和图表的复杂 PDF 文档,将其解析为结构化的 Markdown 格式。这解决了传统方法难以准确提取半结构化数据的问题,使 RAG 应用能够回答涉及表格和文本的复杂问题。该服务直接集成到 LlamaIndex 的摄取和检索流程中,为生产级上下文增强提供了基础。
当前可用性与限制
LlamaParse 现已公开预览,但每日使用量限制为 1000 页,且目前仅支持 PDF 格式。商业用途需联系获取条款。配套的托管摄取和检索 API 处于私有预览阶段,仅向有限的企业设计合作伙伴开放。早期用户反馈表明,未来将扩展对 .docx、.pptx、.html 等文档类型的支持,并改进对图表的处理。
解决 RAG 生产化的关键痛点
文章指出,构建生产级 RAG 面临四大痛点:结果不够准确、参数调优复杂、PDF 解析困难、数据同步挑战。LlamaParse 通过专有解析和托管 API 针对性地解决这些问题。托管 API 允许用户声明式地构建数据管道,自动处理同步和负载均衡,从而减少工程时间,让开发者更专注于核心应用逻辑。
与向量数据库的关系及生态合作
LlamaParse 并非向量数据库的替代品,而是互补层,专注于数据解析和摄取,检索层则构建在现有存储系统之上。LlamaIndex 开源库已集成 40 多种向量数据库。此外,LlamaParse 获得了 DataStax、MongoDB、Qdrant、NVIDIA 等合作伙伴的支持,共同推动企业级 RAG 解决方案的落地。
Q&A
LlamaParse的主要功能是什么?
LlamaParse是一种新一代的解析、摄取和检索服务,专注于复杂文档的解析,支持PDF等格式,旨在提升LLM和RAG应用的上下文增强能力。
LlamaParse如何帮助企业处理数据?
LlamaParse帮助企业快速处理复杂文档,提升数据响应质量,解决数据同步和准确性问题。
LlamaParse支持哪些文档格式?
目前LlamaParse主要支持PDF格式,未来将扩展对其他文档类型的支持,如.docx和.pptx。
LlamaParse的API有什么优势?
LlamaParse的API允许用户轻松加载、处理和存储数据,减少数据处理时间,专注于核心应用逻辑。
LlamaParse的用户反馈如何?
早期用户反馈表明,LlamaParse在处理复杂PDF文档方面表现良好,能够有效解析嵌入的表格和图表。
LlamaParse与传统数据处理方法有什么不同?
LlamaParse采用了新颖的递归检索技术,能够更好地处理复杂文档,而传统方法在处理复杂格式时效果较差。
