


降低语言模型中的毒性
内容提要
大型预训练语言模型会从网络数据中习得毒性内容与偏见,需加强安全控制。文章讨论毒性的定义与分类(如OLID三级体系),介绍人工标注、众包和半监督的数据构建方法,并总结毒性检测技术(对抗攻击、Perspective API、自诊断)与去毒技术(黑名单、自去偏、文本风格迁移、可控生成)及系统级安全方案。
延伸解读
毒性定义的模糊性与标注挑战
文章指出,毒性内容缺乏统一且广泛认可的定义,不同社会背景的人对同一内容的感知差异很大。例如,Perspective API 将毒性定义为“粗鲁、不尊重或无理的评论”,而其他研究则将其视为包含仇恨言论、种族主义等的总称。这种主观性使得数据标注变得复杂,需要清晰的指南和多样化的标注者来减少偏差。
半监督数据构建:以弱信号扩展标注
为缓解标注数据稀缺,文章介绍了半监督方法。例如,Khatri 等人利用黑名单词从 Reddit 子版块中采样敏感与非敏感样本,训练弱分类器进一步筛选,最终得到大规模数据集。SOLID 则通过民主协同训练,用多个模型对未标注数据预测,将高置信度样本加入训练集。这些方法能以较低成本扩展数据,但依赖初始标注质量和模型多样性。
检测技术的鲁棒性:对抗攻击与自诊断
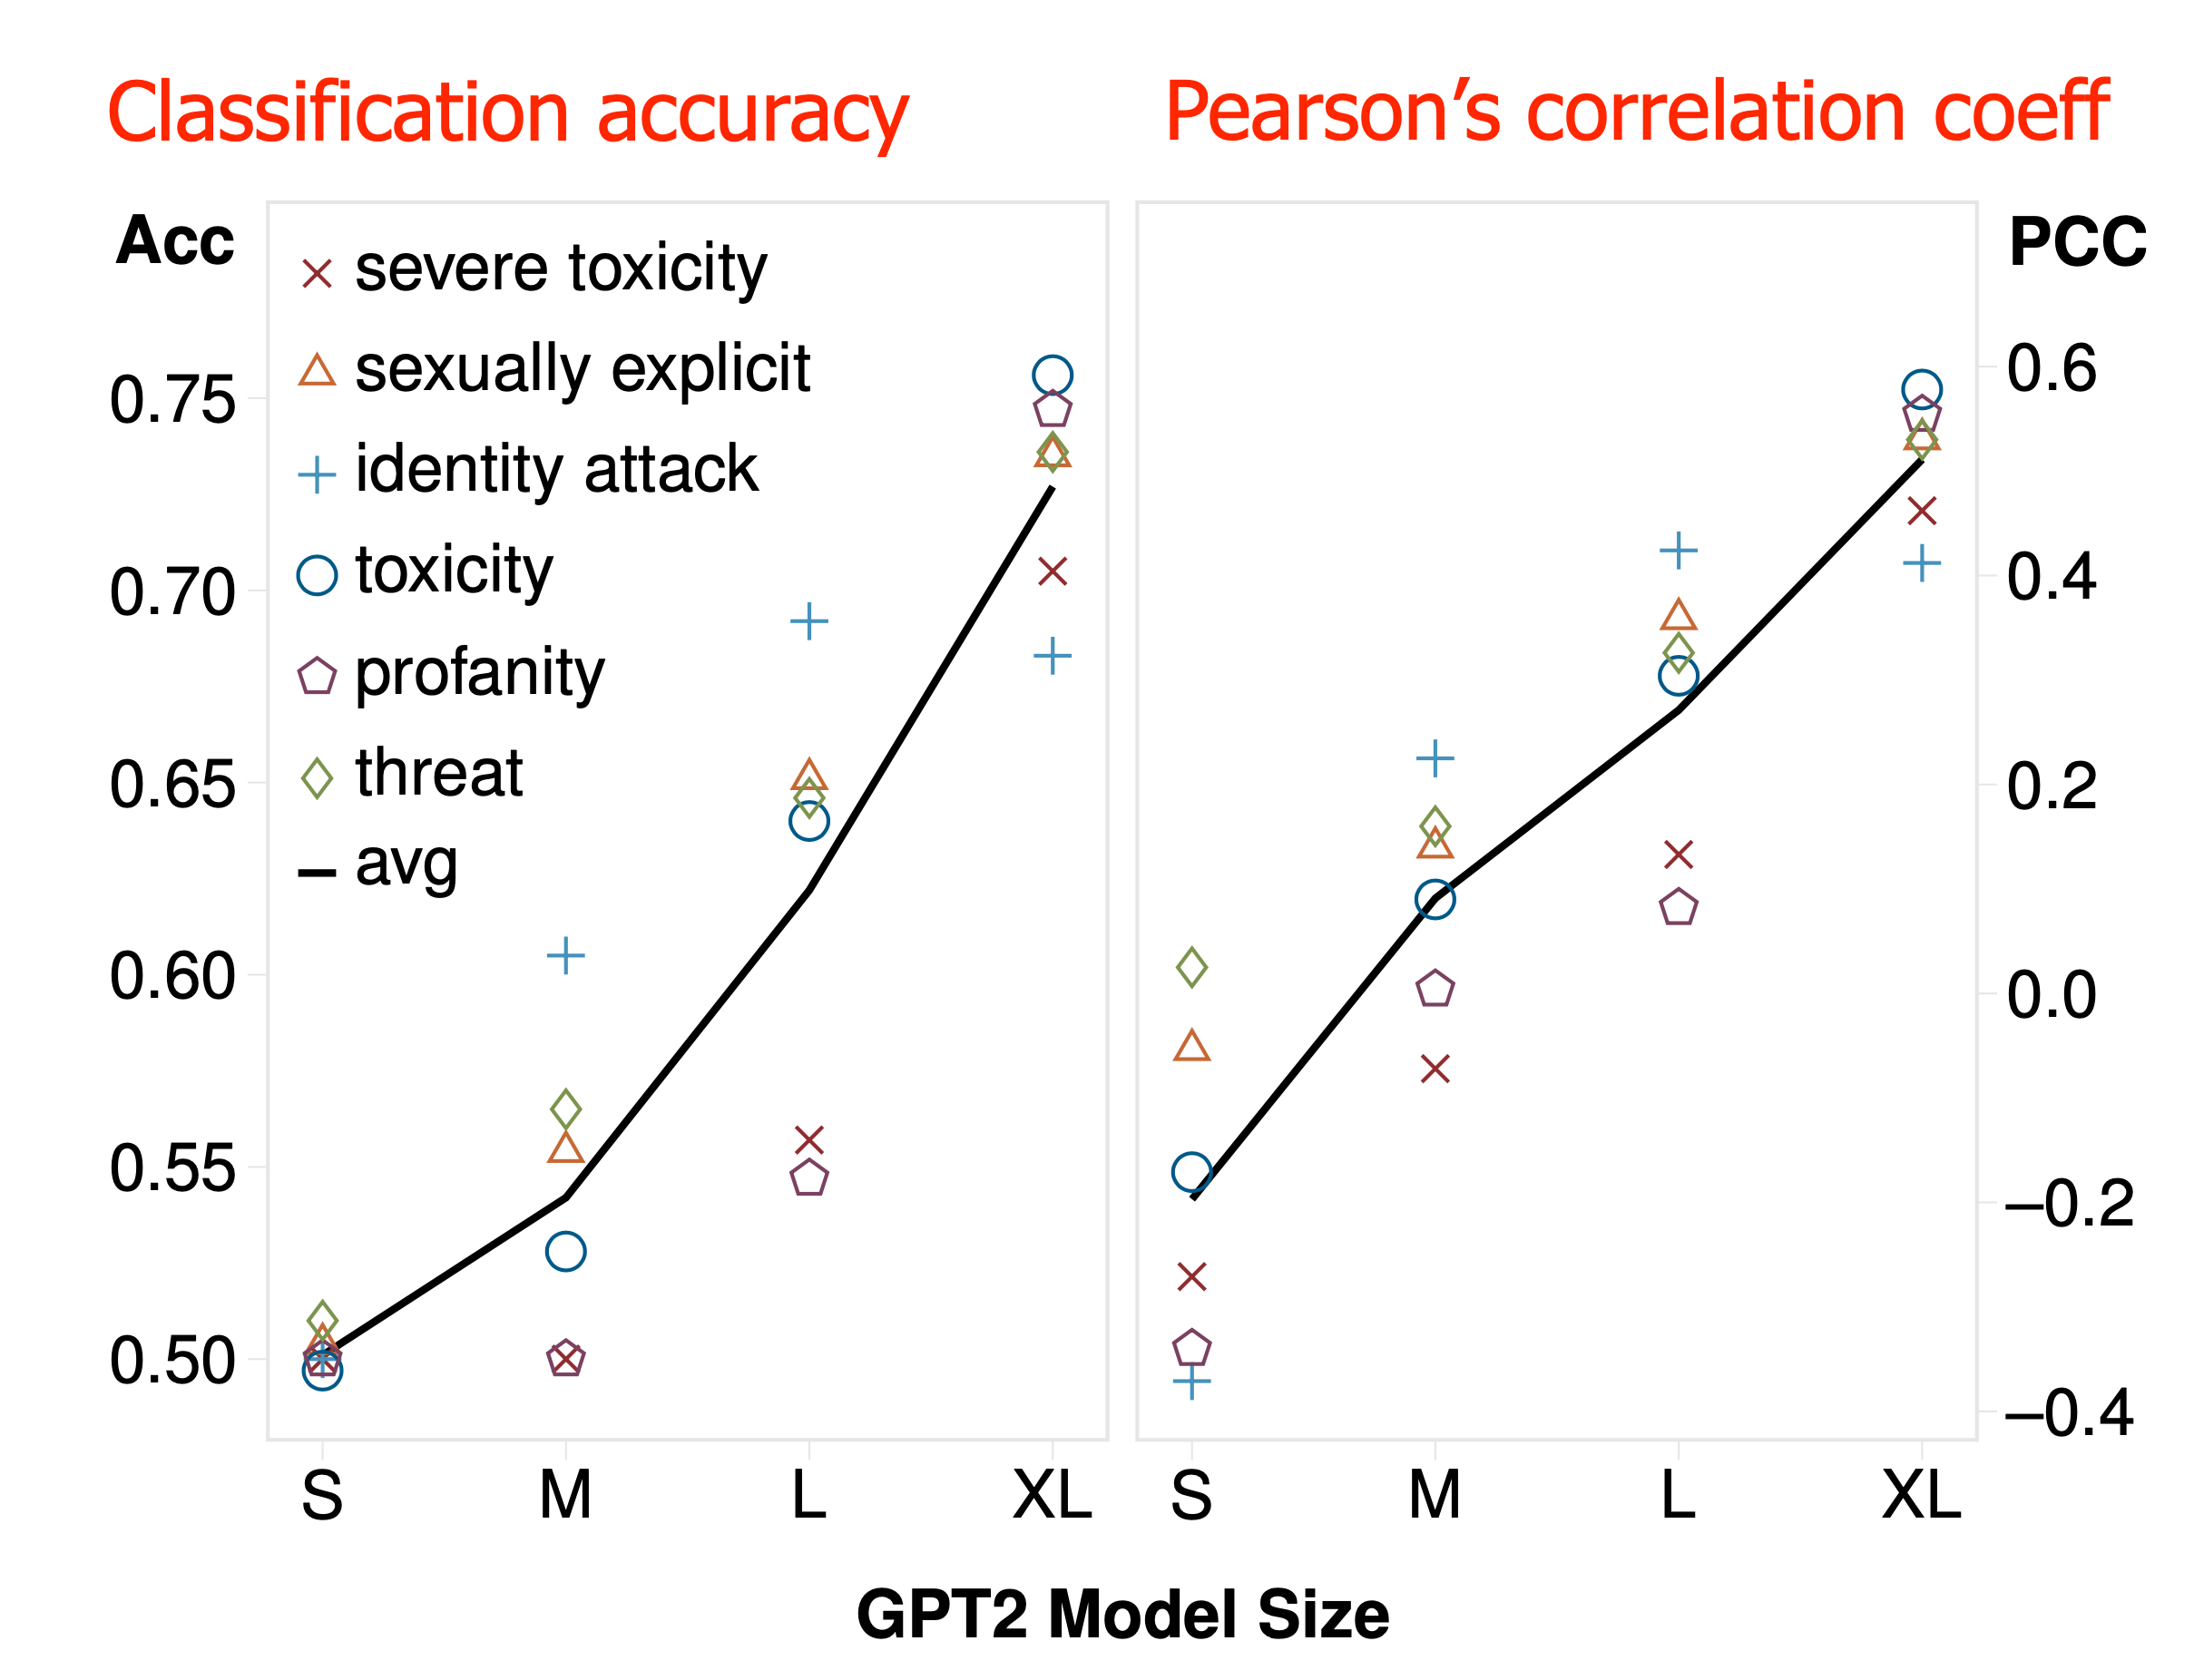
毒性检测模型易受对抗攻击,如字符替换或干扰词注入,导致误判。Dinan 等人提出“构建-破坏-修复”迭代策略,通过人类对抗样本增强模型鲁棒性。Schick 等人的自诊断方法则利用预训练模型自身能力,通过提示模板判断输出是否含有不良属性,无需标注数据,且性能随模型规模提升。这些技术各有优劣,需结合实际场景选择。
去毒技术的权衡:从黑名单到可控生成
去毒方法多样,但各有局限。黑名单过滤简单但可能遗漏由安全词组成的有害内容;自去偏利用模型内部知识降低不良属性概率,但可能过度过滤且受模型能力限制;文本风格迁移可将攻击性句子转为中性,但需平衡内容保留与流畅度;可控生成通过引导解码或微调避免毒性,但计算成本较高。系统级方案则结合检测、对抗训练和主题规避,提供多层防护。
Q&A
语言模型中的毒性具体指什么?有哪些常见的定义?
毒性是一个宽泛的术语,用于描述多种不安全内容。文章列举了几种定义:Perspective API 将其定义为“粗鲁、不尊重或无理的评论,可能使人们离开讨论”;Kurita 等人(2019)定义为“可能冒犯或伤害接收者的内容,包括仇恨言论、种族主义和冒犯性语言”;Pavlopoulos 等人(2020)将“毒性”作为总称,涵盖“冒犯性”、“辱骂性”、“仇恨性”等。总体而言,毒性涵盖多种类型的不安全内容。
如何对毒性内容进行三级分类?OLID 数据集是什么?
Zampieri 等人(2019)提出了一个三级层次分类法,同时考虑冒犯的类型和目标。Level A:是否冒犯?[OFF] 冒犯性(不当语言、侮辱或威胁);[NOT] 非冒犯性。Level B:冒犯性文本是否有针对性?[TIN] 针对性侮辱(针对个人、群体或其他);[UNT] 无针对性(非针对性的亵渎和咒骂)。Level C:目标是什么?[IND] 针对个人(常定义为“网络欺凌”);[GRP] 针对群体(基于种族、性别、性取向、宗教等,常定义为“仇恨言论”);[OTH] 其他目标(组织、事件、问题等)。OLID(Offensive Language Identification Dataset)就是基于此分类法收集的数据集。
构建毒性检测数据集时,人工标注有哪些方法?如何保证标注质量?
人工标注方法包括:专家编码(质量高但昂贵)、众包(最常见,易扩展但需质量控制)、专业版主(经验丰富但目标可能偏向平台)、合成数据(由内容创作者手动创建)。保证众包质量的最佳实践有:使用测试数据筛选标注者、提供清晰指南、采用多数投票、了解标注者身份背景以确保多样性。
有哪些半监督方法可以构建大规模的毒性检测数据集?
文章介绍了两种半监督方法:1)两阶段引导(TS bootstrap):Khatri 等人(2018)利用一个包含 800+ 脏话的黑名单,对 Reddit 子版块排序,采样敏感和非敏感样本,训练弱二分类器进一步筛选样本,再训练新分类器。2)SOLID:Rosenthal 等人(2020)使用民主协同训练,在 OLID 上训练多个多样化的监督模型(如 PMI、FastText、LSTM、BERT),对未标注样本预测置信度,聚合后加入高置信度样本,构建了 900 万+ 推文的数据集。
如何通过对抗攻击提升毒性检测模型的鲁棒性?
Dinan 等人(2019)提出了迭代的“构建、破坏、修复”策略:构建一个 BERT 模型在 Jigsaw 数据集上分类有毒评论;让众包工作者编写被模型误判为“安全”的有毒信息;将原始数据与新收集的对抗样本结合重新训练模型;重复此过程。对抗收集的样本包含更少的显式脏话和更多的否定,使任务更具挑战性。对抗模型对对抗攻击更鲁棒,但可能在标准任务上表现下降。
Perspective API 是什么?它有哪些已知的偏见?
Perspective API 是最广泛使用的商业毒性检测 API,为多个属性提供 0 到 1 的分数,包括毒性、严重毒性、侮辱、亵渎、身份攻击、威胁和色情内容。已知偏见包括:对少数群体存在偏见,标注一致性低,部分由于标注者身份影响对仇恨言论的感知;系统会高估包含少数身份提及(如“我是同性恋”)或种族少数群体文本(如非裔美国人英语)的毒性,部分原因是检测器过度依赖词汇线索(如脏话、侮辱语)。
自诊断和自去偏技术是如何工作的?
自诊断(Schick 等,2021)利用预训练语言模型检测自身输出中的不良属性。它使用预定义的提示模板,测量模型输出“是”与“否”的归一化概率,无需标注数据。自去偏类似,通过比较无模板和有模板时下一个词的概率差,调整采样分布,降低不良词的概率。但自去偏有局限:仅依赖 Perspective API 评估,可能过滤无害词,且受模型内部能力限制。
文本风格迁移如何用于去毒?有哪些主要方法?
文本风格迁移可将冒犯性句子转换为无害句子。Santos 等人(2018)使用非平行数据的无监督风格迁移,采用循环一致性损失。Style Transformer(Dai 等,2019)学习基于 Transformer 的风格迁移函数,使用判别器提供监督。CAE-T5(Laugier 等,2021)微调预训练文本到文本 Transformer,使用去噪自编码器和循环损失。评估指标包括准确率、流畅度和内容保留。
系统级安全方案如何构建安全的聊天机器人?
Xu 等人(2020)提出了系统级设计,包括四种策略:1)检测不安全内容:在输入和输出端使用分类器,检测到不安全内容时返回预设响应或改变话题。2)机器人对抗对话安全:收集人类对抗性探测数据,训练多轮安全分类器。3)安全生成:过滤预训练数据,在解码时屏蔽不安全词,使用“烘焙”安全数据微调模型。4)避免敏感话题:训练多类分类器检测政治、宗教等话题。5)性别偏见缓解:使用 CTRL 风格训练,避免输出性别特定词。
