


话音刚落,文字已出:从 Hybrid 到大模型的流式 ASR 演进
内容提要
流式ASR需在音频未完整时持续输出,核心矛盾是准确率与延迟的权衡。文章梳理其定义与三类实现,说明交互、长音频、端侧和流水线并行等需求;回顾Hybrid逐帧解码、CTC、RNN-T、单调注意力等路线,以及大模型时代的分块化、交错生成、读写策略和延迟建模。评价应同时看准确率、发射稳定、效率与回改,并按场景选择路线。
延伸解读
流式ASR的延迟不只是chunk大小
文章指出,chunk大小只是延迟来源之一,首次输出和稳定输出也不是同一时刻。实际体验还受块边界、右看、模型发射倾向、计算、网络和结果稳定策略影响。因此,不能简单认为“chunk为500ms”就等于“出字延迟500ms”。工程上需区分模型固有延迟与端到端延迟,后者还包括计算排队、网络传输和界面刷新。
大模型流式ASR并非全新范式
文章强调,大模型流式方法重新使用了许多经典思想:BLANK来自Transducer,单调边界来自在线Attention,READ/WRITE来自同声翻译,缓存和有限右看来自流式编码器。变化在于语言模型拥有更强的文本先验和上下文能力,流式训练需让它同时学会“说什么”与“何时说”。因此,大模型流式ASR是对旧技术的继承与扩展,而非彻底替代。
评价流式ASR需多维度指标
文章认为,仅报告WER/CER或chunk大小无法说明流式系统是否好用。应同时观察准确率(WER、CER)、发射与稳定(声学结束到首次输出/稳定输出的P50/P90)、系统效率(RTF、并发吞吐、显存)和交互完整性(句末确认延迟、回改率、最长回改距离)。公平比较需让所有模型接收相同速度的实时音频,统一测量规则,并绘制准确率与延迟的Pareto曲线。
技术路线选择取决于场景约束
文章指出,没有一种结构在所有场景都最优。输入法、车载和语音助手重视低延迟、稳定前缀和端侧成本,适合原生流式CTC/Transducer及小右看的流式编码器;直播字幕和会议转写允许适度回改,可采用较大chunk、记忆编码器或带稳定前缀的大模型方案;语音智能体需联合设计ASR发射、端点检测和下游推理;离线归档若无实时要求,完整上下文仍最划算。选择时应先确定可接受的稳定输出延迟和计算预算,再比较同一延迟下的准确率。
Q&A
流式ASR和离线ASR的主要区别是什么?
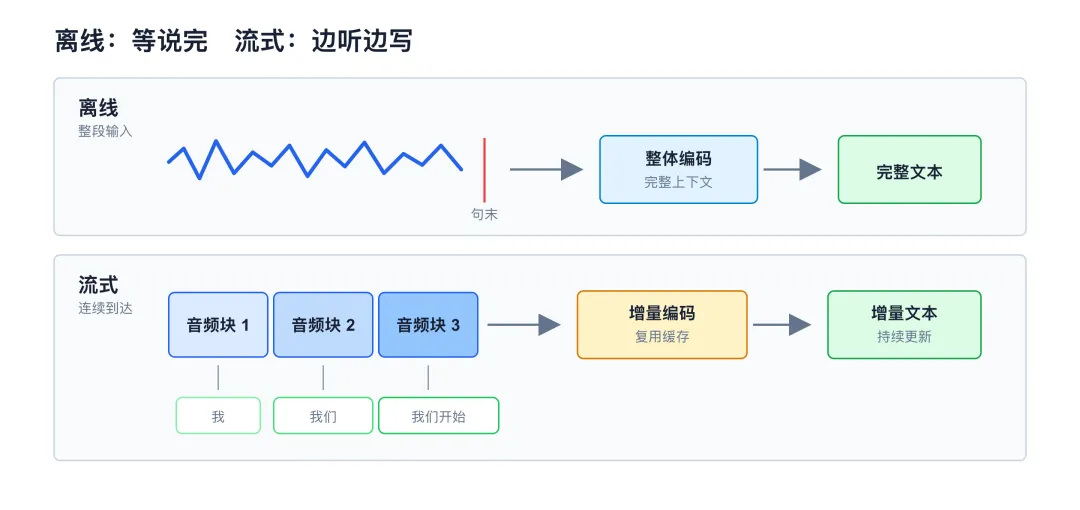
离线ASR先接收完整音频再统一编码解码;流式ASR将音频切成连续到达的帧或小块,每获得新声音就更新内部状态并产生增量文本,且只能使用已到达的语音和少量右侧上下文。
为什么流式ASR不能只看chunk大小来判断延迟?
因为chunk只是延迟来源之一,出字延迟还受块边界、右看、模型发射倾向、计算、网络和结果稳定策略影响。例如chunk为500ms不等于出字延迟为500ms,首次输出和稳定输出也不是同一时刻。
Hybrid ASR系统为什么天然适合流式识别?
Hybrid系统每来一帧,解码器就扩展候选路径并剪枝,WFST将HMM、词典和语言模型编译成统一搜索图,实现在线token passing,沿音频时间轴逐帧搜索,因此边界清楚、延迟可解释。
CTC和RNN-T在流式ASR中分别如何表示“等待”和“输出”?
CTC用blank表示暂时不产生新文字,连续输出blank即等待;RNN-T中blank相当于继续读音频,非blank相当于现在写一个标签,并利用文字历史消除歧义。
大模型时代的流式ASR有哪些主要实现路线?
主要有四条:离线模型分块化(如Qwen3-ASR)、音频文本交错生成(如Speech ReaLLM)、显式READ/WRITE策略(如BESTOW)、延迟流建模(如DSM)。这些路线重新使用了BLANK、单调边界等经典思想。
评价流式ASR系统时应该看哪些指标?
至少应同时观察四组指标:准确率(WER/CER)、发射与稳定(首次输出和稳定输出的延迟)、系统效率(RTF、吞吐、显存)、交互完整性(句末确认延迟、回改率)。只报告WER或chunk都不够。
在实际场景中如何选择流式ASR的技术路线?
输入法、车载等重视低延迟和端侧成本,适合原生流式CTC/Transducer;直播字幕和会议转写允许回改,可用大chunk或大模型方案;语音智能体需联合设计ASR发射、端点检测和下游推理;离线高精度转写则无需流式。
