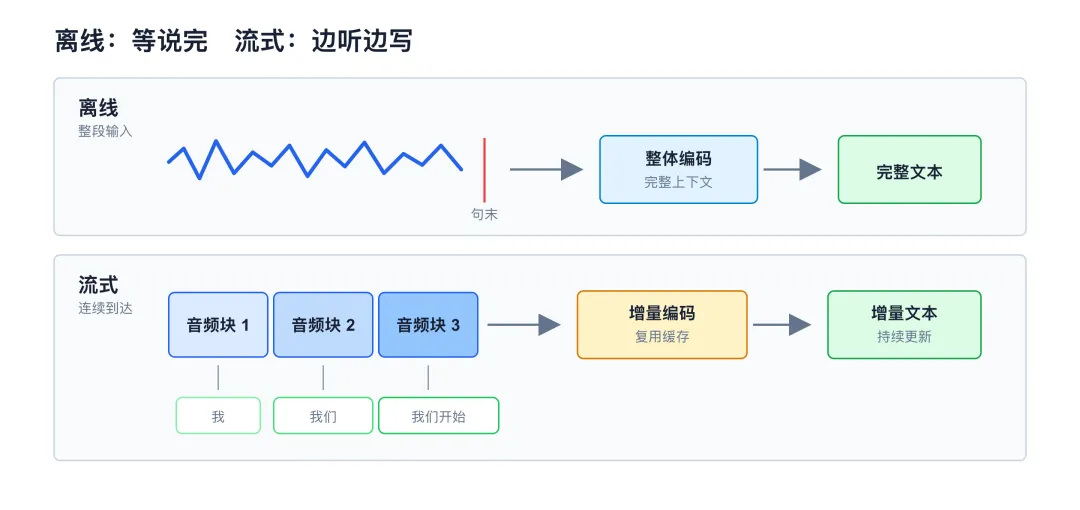
流式ASR需在音频未完整时持续输出,核心矛盾是准确率与延迟的权衡。文章梳理其定义与三类实现,说明交互、长音频、端侧和流水线并行等需求;回顾Hybrid逐帧解码、CTC、RNN-T、单调注意力等路线,以及大模型时代的分块化、交错生成、读写策略和延迟建模。评价应同时看准确率、发射稳定、效率与回改,并按场景选择路线。
本研究提出了一种新型损失函数,Target-Robust损失,旨在提升语音识别系统在嘈杂环境下的表现,显著提高RNN-T模型的鲁棒性,恢复超过70%的识别质量。
完成下面两步后,将自动完成登录并继续当前操作。