
Netflix 如何训练大语言模型推荐电影,让你欲罢不能
内容提要
Netflix 构建了基于大语言模型的 GenRec 推荐系统,分两阶段训练:先让开源模型学习 Netflix 内容与用户行为,再针对排序任务微调。系统将用户观看历史等转为文本,经上下文工程压缩后输入模型,由排序头对目录内容打分,并采用仅预填充推理降低成本。离线与 A/B 测试显示首页互动指标有提升。
延伸解读
从特征工程到上下文工程:推荐系统设计重心的转移
Netflix 原有推荐系统依赖数千个手工特征和专用模型组件,新增用例成本高。GenRec 将用户行为、内容元数据等转为文本,让 LLM 自行理解关系。这使设计重心从“计算哪些特征”转向“选择哪些事件写入提示词”。团队需权衡证据强度、重复行为压缩和冷启动项目的细节,最终将 token 压缩至约三分之一。
两阶段训练:领域适应与任务微调的分工
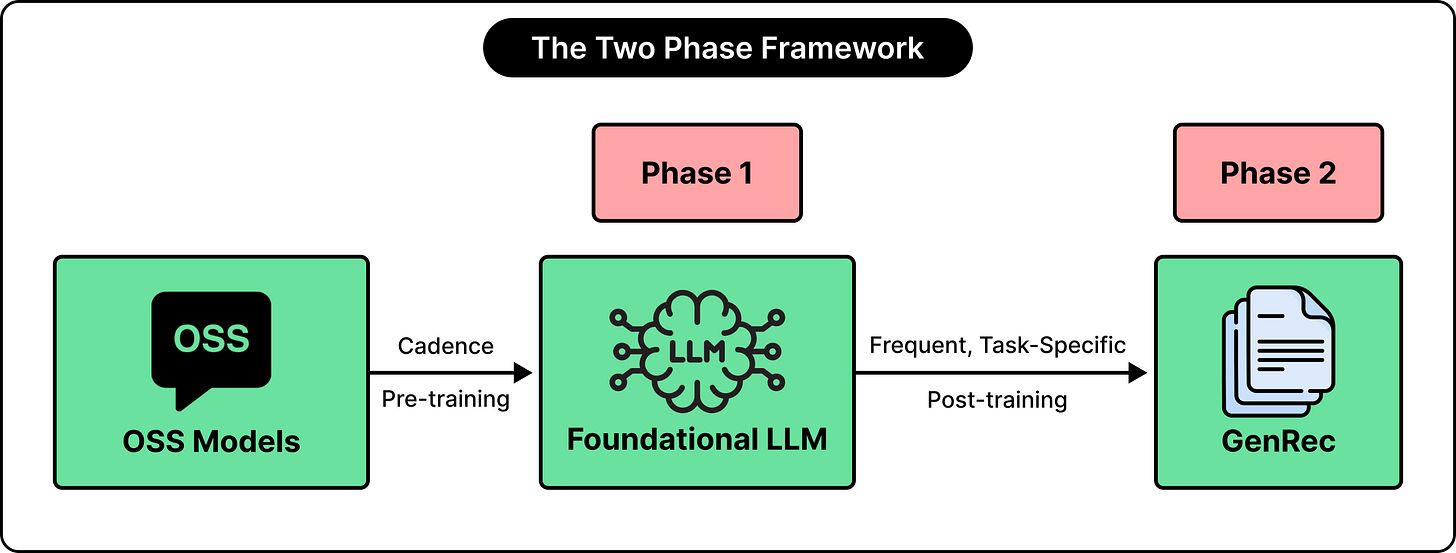
GenRec 先基于开源 LLM 用 Netflix 数据训练出领域基础模型,使其理解内容与用户行为,该阶段更新频率低。第二阶段针对排序任务微调,利用点击、观看时长、反馈等构造对话式训练样本,并引入奖励加权训练平衡不同内容类型。这种分工让基础模型可复用于多任务,而排序模型能快速跟进新内容与趋势。
仅预填充推理:成本控制的关键机制
GenRec 不逐词生成推荐列表,而是仅运行预填充阶段,通过排序头对目录内容打分。这避免了自回归解码的开销。Netflix 使用 vLLM 服务,并采用蒸馏小模型、共享前缀缓存来进一步降低成本。文章指出,上下文长度压缩至约三分之一时,服务成本也相应下降。这说明推理成本与输入长度直接相关,是工程优化的重要杠杆。
离线与在线评估:指标提升的解读
Netflix 用离线 MRR 检查排序质量,再通过覆盖约 10% 流量、持续 4 周的 A/B 测试验证在线效果。结果显示短期首页互动指标提升 0.115%,长期核心指标提升 0.006%,均具统计显著性。虽然数值看似微小,但在 Netflix 规模下可能影响大量用户。这提醒读者,推荐系统改进需兼顾离线排序与真实用户行为,且长期指标往往比短期互动更难提升。
Q&A
Netflix 为什么要自研 GenRec 而不是直接用现成的大语言模型做推荐?
通用大语言模型存在明显缺陷:可能偏向全球热门内容、推荐不在 Netflix 目录中的影片,并且不支持个性化。因此 Netflix 没有直接采用现成模型,而是构建了 GenRec,将语言理解能力与针对 Netflix 目录和用户行为的专门训练相结合。
GenRec 的两阶段训练分别是什么?
第一阶段:基于开源基础大语言模型,用 Netflix 专有数据训练,使其熟悉 Netflix 内容和用户行为,形成稳定的 Netflix 感知基础模型。第二阶段:针对排序任务进行后训练,用具体示例和奖励信号训练模型对目录内容正确打分,并满足成本目标。
Netflix 如何利用用户行为数据构造训练样本?
Netflix 记录点击、观看时长、点赞/点踩、加入片单、放弃观看等交互,并将这些记录转化为对话格式:用户消息包含用户历史、上下文、元数据和推荐任务,助手消息描述用户实际执行的动作(如接下来看了什么、看了多久、是否反馈)。这种格式便于模型学习前后关联,但实际使用时用户并不需要与 Netflix 聊天。
什么是上下文工程?Netflix 如何压缩用户历史以控制成本?
上下文工程指决定将哪些信息放入提示中。Netflix 考虑证据强度(如长观看或明确反馈值得详细描述,短暂悬停等弱信号则省略)、重复行为(用紧凑方式表示,如概括为“连续观看某剧”)、选择性细节(冷启动内容需要更丰富的元数据)以及上下文长度。通过清洗、压缩和措辞调整,令牌数量减少到约原来的三分之一。
GenRec 如何生成排序列表?它和普通文本生成模型有何不同?
GenRec 不逐词生成推荐。它先用 verbalizer 将用户观看历史、当前上下文和元数据转为文本,由大语言模型处理并提取池化隐藏状态,再通过排序头结合用户上下文表示与每个目录项的嵌入,计算得分,经 softmax 转为分布后排序。推理时采用仅预填充(prefill-only)方式,只处理一次提示,不逐词生成输出,从而降低推理成本。
Netflix 如何评估 GenRec 的效果?
Netflix 采用离线评估和在线 A/B 测试。离线评估使用记录数据衡量排序质量,例如平均倒数排名(MRR),奖励将首个相关项排在靠前位置。在线 A/B 测试覆盖约 10% 流量、持续 4 周,结果显示短期首页互动指标提升 0.115%,长期核心指标提升 0.006%,两者均具统计显著性。
