


我们如何让PlanetScale的后台作业具备自我修复能力
原文英文,约900词,阅读约需4分钟。
📝
内容提要
PlanetScale在构建后台作业系统时,要求具备自我修复能力,以便在数据丢失或作业失败时快速恢复。系统通过将作业状态存储在数据库中,定期调度作业,确保即使队列丢失也能重新入队。此外,支持功能标志控制作业运行,并采用批量调度和随机延迟来优化性能,避免过载。
🔎
延伸解读
自我修复的核心:调度作业与数据库状态
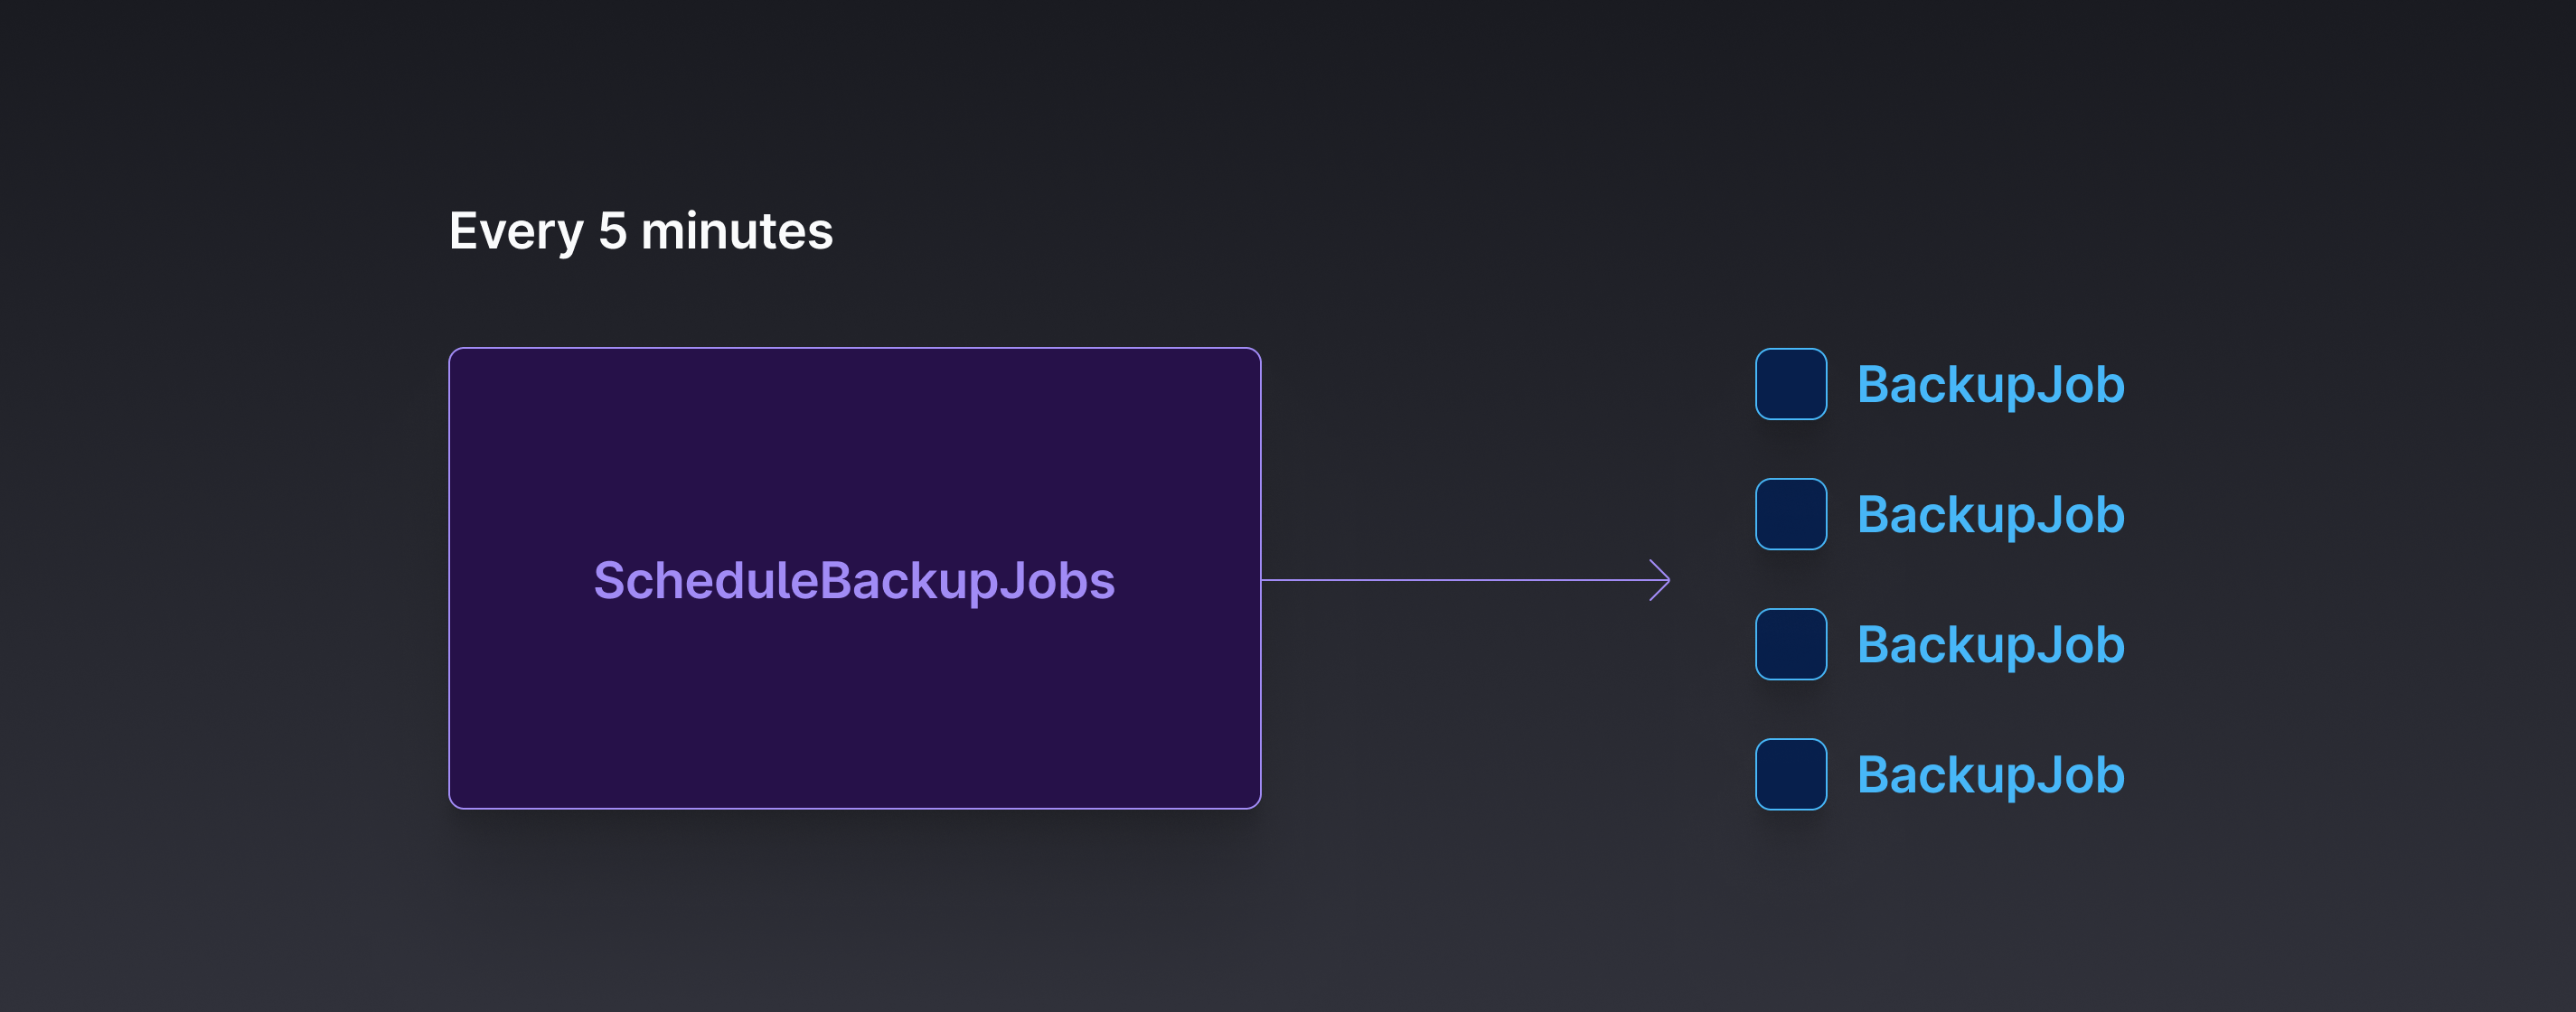
PlanetScale 的后台作业系统通过定期调度作业和将作业状态存储在数据库中来实现自我修复。即使队列数据全部丢失,调度作业也能重新入队未完成的任务,确保功能不受影响。这种设计基于过往经验,强调故障不可避免,必须快速恢复。
功能标志与批量调度:灵活控制与性能优化
系统支持通过功能标志动态停止特定类型的作业,便于在事故中控制影响范围。随着作业数量增长,批量调度减少了 Redis 请求次数,提升了性能。这些措施共同保障了系统在高负载下的稳定运行。
随机延迟与唯一性处理:避免过载与重复执行
通过添加随机延迟,作业被分散执行,防止外部 API 过载。针对可能出现的重复作业,系统采用快速退出、数据库锁和 Sidekiq 唯一作业等方式处理,确保数据一致性和作业执行的准确性。
❓
Q&A
PlanetScale的后台作业系统如何实现自我修复能力?
PlanetScale通过将作业状态存储在数据库中,并定期调度作业,确保即使队列丢失也能重新入队,从而实现自我修复能力。
在PlanetScale中,如何处理作业失败的情况?
如果作业失败,系统会自动重新运行该作业,以确保功能不受影响。
PlanetScale如何优化后台作业的调度性能?
PlanetScale采用批量调度和随机延迟来优化性能,减少单个请求的开销,避免过载。
功能标志在PlanetScale的后台作业中有什么作用?
功能标志用于控制作业的运行,可以在需要时停止特定作业类型的执行。
PlanetScale如何确保即使在数据丢失的情况下也能恢复作业?
通过将作业状态存储在数据库中,系统可以在作业丢失时重新入队,确保恢复。
PlanetScale是如何避免外部API过载的?
通过在作业调度中添加随机延迟,PlanetScale避免了某些作业同时运行,从而防止外部API过载。
🏷️
