

12 种调整策略指南:为生产环境打造高效的 RAG 应用 [译]
内容提要
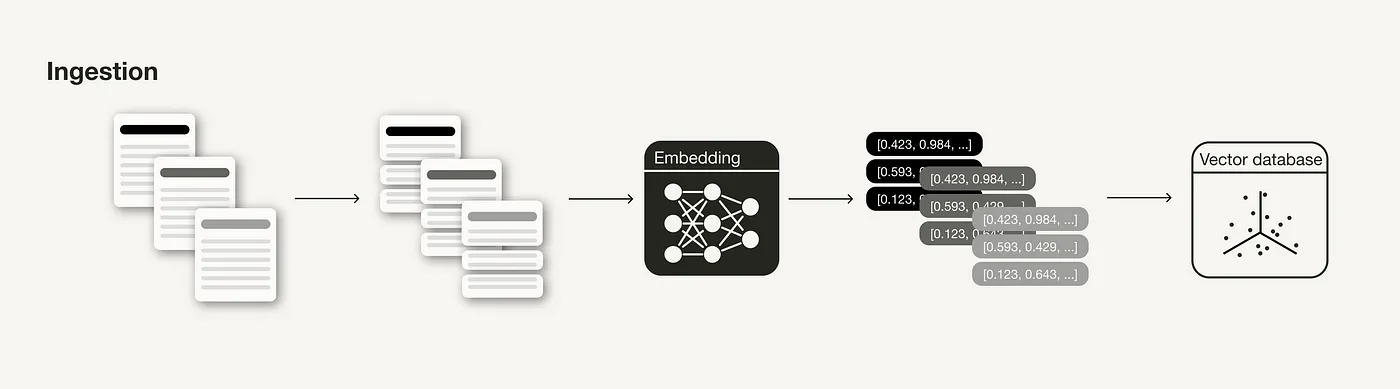
文章介绍生产环境中优化RAG应用的12种策略,分为数据录入与推理两个阶段。数据录入阶段包括数据清洗、文档分块(技术、块大小、重叠)、嵌入模型选择与微调、元数据、多重索引和索引算法;推理阶段包括查询转换(改写、HyDE、子查询)、检索参数(混合搜索alpha、结果数量)、高级检索策略(句子窗口、自动合并)、重排序模型、大语言模型选择与微调以及提示工程(少样本示例、上下文数量)。
延伸解读
数据录入阶段:质量与分块是基础
文章强调数据清洗和文档分块是RAG性能的基石。数据需清洁且事实准确,避免矛盾信息混淆模型。分块技术需匹配数据类型(如代码与Markdown不同),块大小要权衡上下文与无关信息,并设置重叠窗口。这些步骤虽在录入阶段,但直接影响后续检索相关性,是生产化前必须调优的环节。
嵌入与索引:微调与算法选择
嵌入模型的质量极大影响检索效果,通用模型可直接使用,但特定场景下微调可提升5-10%的检索效果,不过并非所有模型支持微调(如OpenAI的text-embedding-ada-002)。索引算法方面,ANN搜索牺牲精度换效率,HNSW等算法参数通常由研究团队调整,开发者更应关注元数据筛选和多重索引等策略。
推理阶段:检索优化比生成更关键
文章指出检索部分对整体影响更大。查询转换(改写、HyDE、子查询)可改善搜索结果;混合搜索需调整alpha平衡语义与关键词;高级策略如句子窗口和自动合并,核心是嵌入小块检索但提供更广上下文。重排序模型能区分“相似”与“相关”,但需调整输入数量并可能微调。
生成阶段:提示工程与上下文数量
LLM选择需权衡开源/专有、推理成本和上下文长度,特定场景可微调。提示工程要求回答严格基于搜索结果,并加入少样本示例提升质量。上下文数量并非越多越好,过多可能导致“迷失在中间”现象,即LLM忽略中间位置的相关信息,需实验找到平衡点。
Q&A
RAG应用在生产环境中有哪些可调整的优化策略?
文章将优化策略分为数据录入和推理两个阶段。数据录入阶段包括:数据清洗、文档分块(技术、块大小、重叠)、嵌入模型选择与微调、元数据、多重索引、索引算法。推理阶段包括:查询转换(改写、HyDE、子查询)、检索参数(混合搜索alpha、结果数量)、高级检索策略(句子窗口、自动合并)、重排序模型、大语言模型选择与微调、提示工程(少样本示例、上下文数量)。
如何选择文档分块的大小和重叠?
分块长度因应用场景而异:问答系统可能需要较短的精确信息块,内容摘要可能需要较长的信息块。块大小要恰到好处:太短可能缺乏足够上下文,太长则可能含有过多无关信息。此外,需要在不同块之间设置重叠(滚动窗口),以增加额外的上下文信息。
嵌入模型需要微调吗?微调能提升多少效果?
通用嵌入模型可以直接使用,但在特定场景下,对嵌入模型进行微调更有利于适应特定使用环境,避免领域外问题。LlamaIndex的实验显示,微调嵌入模型可以在检索效果上提升大约5–10%。需要注意的是,并非所有嵌入模型都支持微调,例如OpenAI的text-embedding-ada-002目前不支持微调。
混合搜索中的alpha参数是什么?如何调整?
alpha参数负责平衡基于语义的搜索和基于关键词的搜索的重要性。alpha=1表示完全基于语义的搜索,alpha=0表示完全基于关键词的搜索。在选择混合搜索时,需要研究如何在稀疏和密集检索方法之间进行有效的权重分配,即调整alpha参数。
重排序模型有什么作用?为什么需要它?
语义搜索根据查询与上下文的语义相似度进行,但“最相似”并不总等同于“最相关”。重排序模型(如Cohere的Rerank)能够为每个检索结果计算与查询相关性的得分,帮助排除不相关的搜索结果。使用重排序模型时,可能需要重新调整搜索结果的数量,以及输入到大语言模型的经过重排序的结果数量。
提示工程中有哪些技巧可以提升RAG效果?
提示工程技巧包括:确保回答仅基于搜索结果,不添加其他信息;在提示词中加入少样本示例,可以有效提升生成内容的质量;探索在提示词中加入的上下文数量,但需注意增加相关上下文可能产生“迷失在中间”现象,即LLM无法有效识别被放置在众多上下文中间的相关信息。
