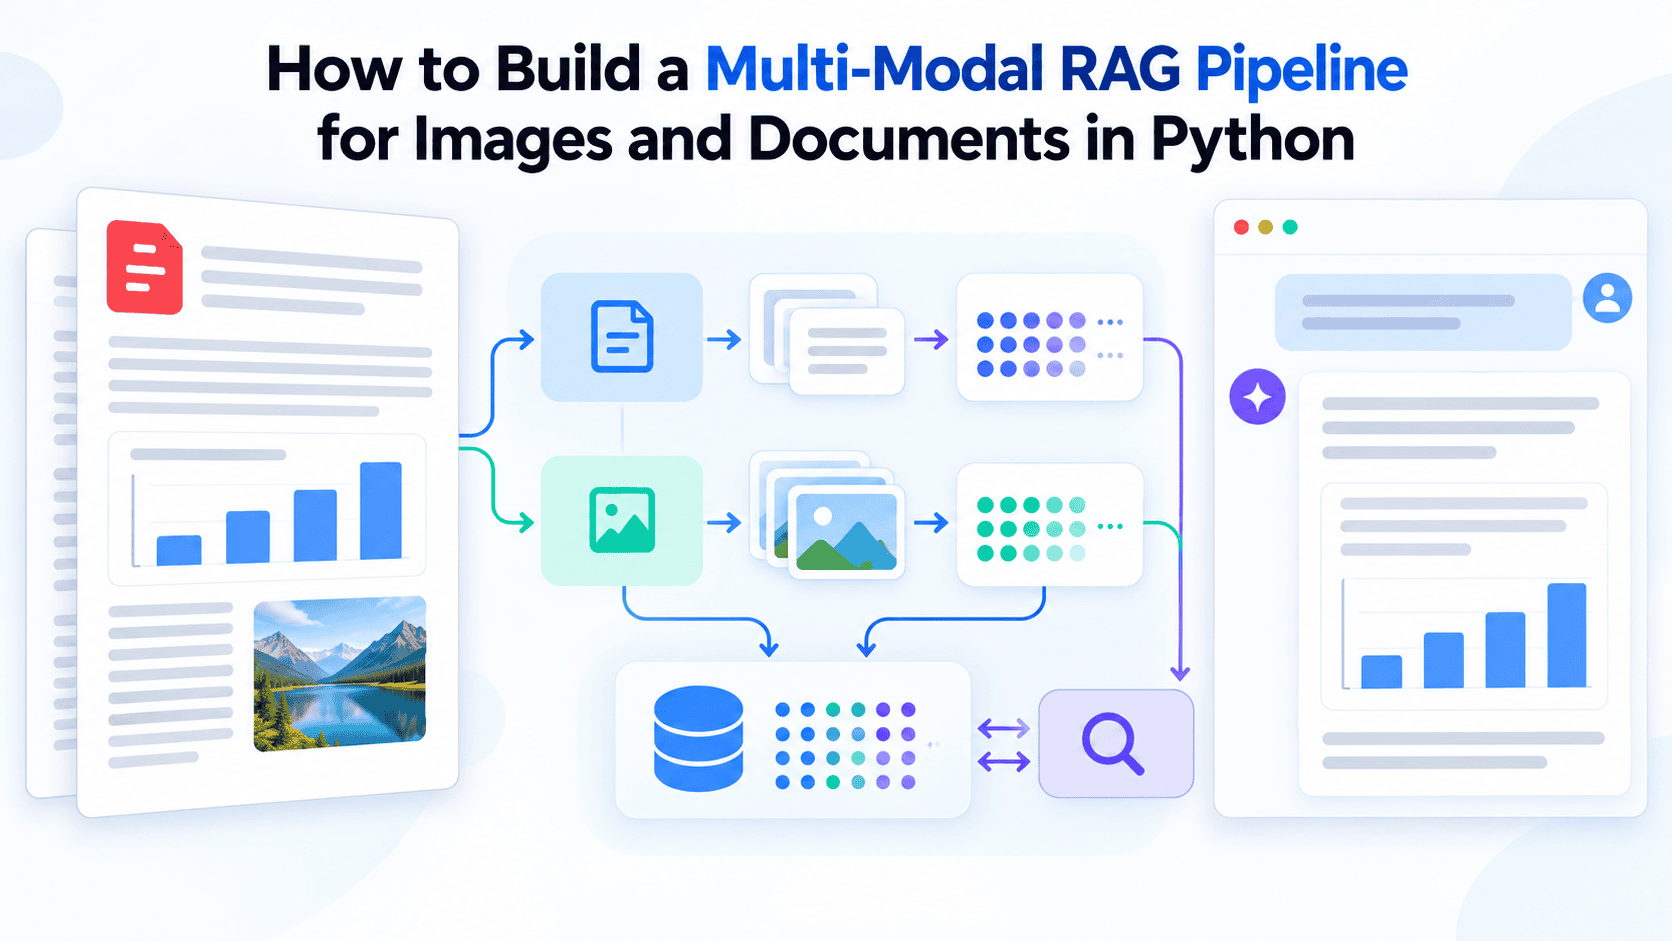
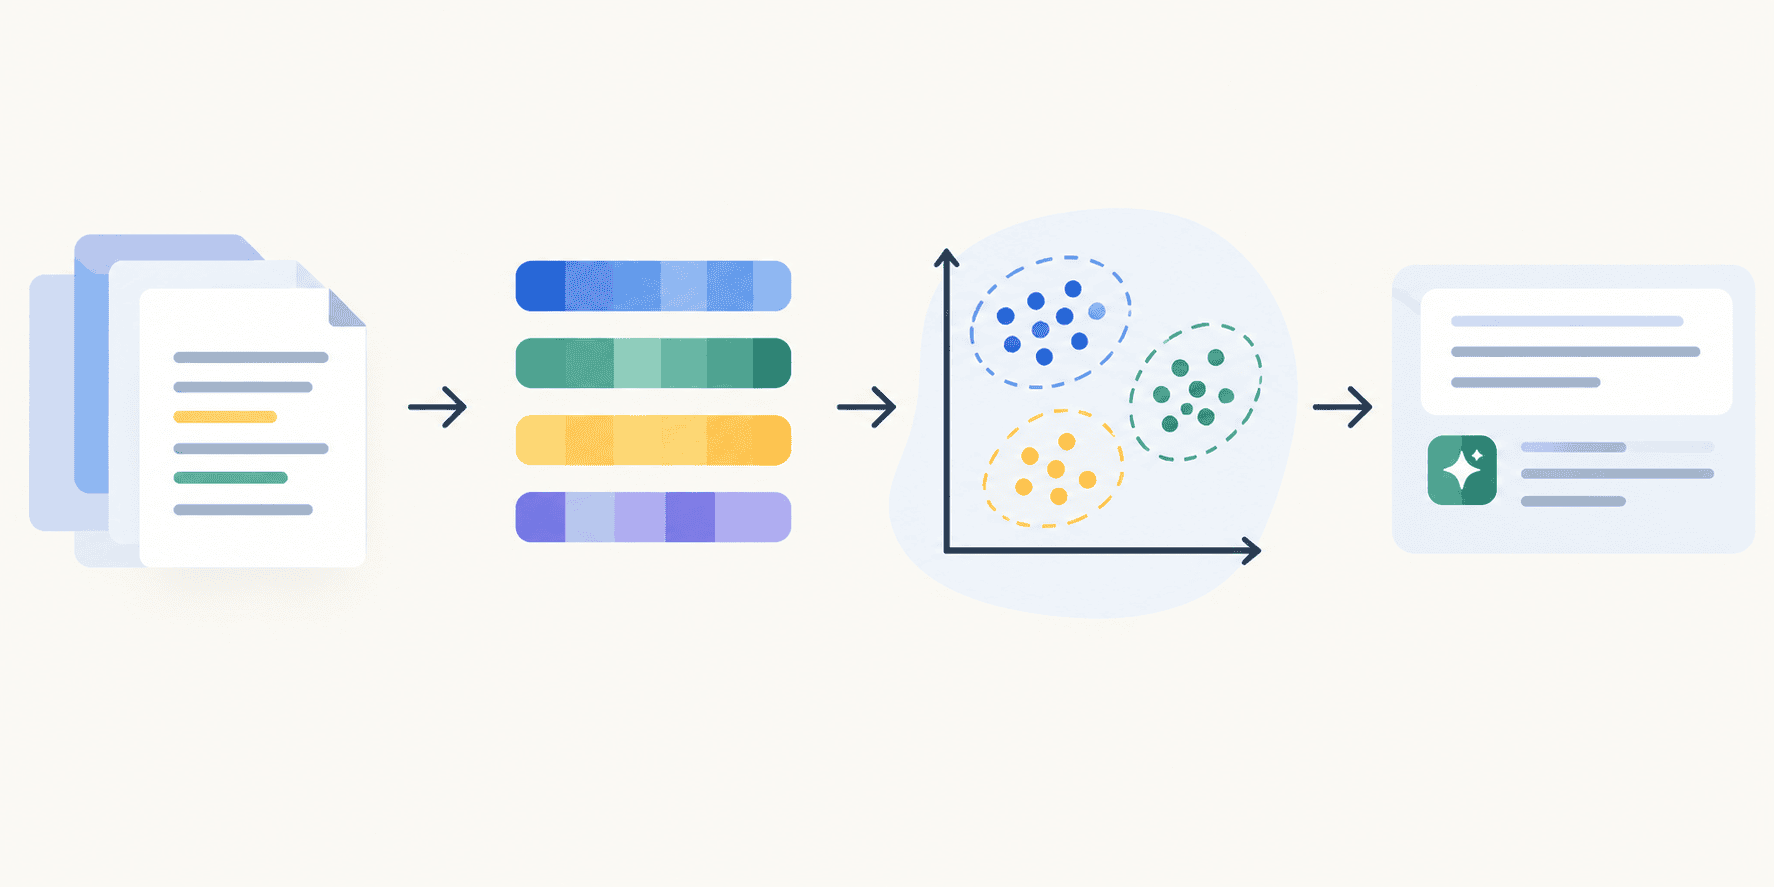
本文介绍用Python构建多模态RAG流水线以处理含图表和图片的复杂PDF,流程分四步:用unstructured库将PDF解析为文本块和图片;用GPT-4o为每张图片生成可检索的文字摘要;用MultiVectorRetriever建立向量库与文档库双存储,以ID关联摘要与原始内容;查询时检索文本和图片摘要,将原始图片与文本一并传给GPT-4o生成有据可依的答案。该方案适用于研究报告、财务文档等图文混排文件。
RAG_Techniques 是一个展示先进检索增强生成技术的资源库,提供全面的文档和实施指南。yaak 是支持多种请求方式和动态值的桌面 API 客户端。aloha 是低成本的开源硬件系统,支持双手远程操作。dreamtalk 生成高质量的虚拟人视频,支持多种输入方式。awesome-reversing 是逆向工程学习资源的集合。
本文介绍 Koog 1.3 的知识增强设施:Embeddings 模块通过 LLMEmbedder 生成向量,但 DeepSeek 客户端不支持嵌入,需搭配 Ollama 或云端服务;rag-base 定义存储抽象,rag-vector 提供文档向量化与检索原型,仅适合本地测试;检索可作为工具供 agent 按需调用,实现 agentic RAG;LongTermMemory 将检索与入库功能化,支持自动或手动模式,需注意分桶、去重与持久化限制;生产环境应基于 rag-base 自研向量库适配器。
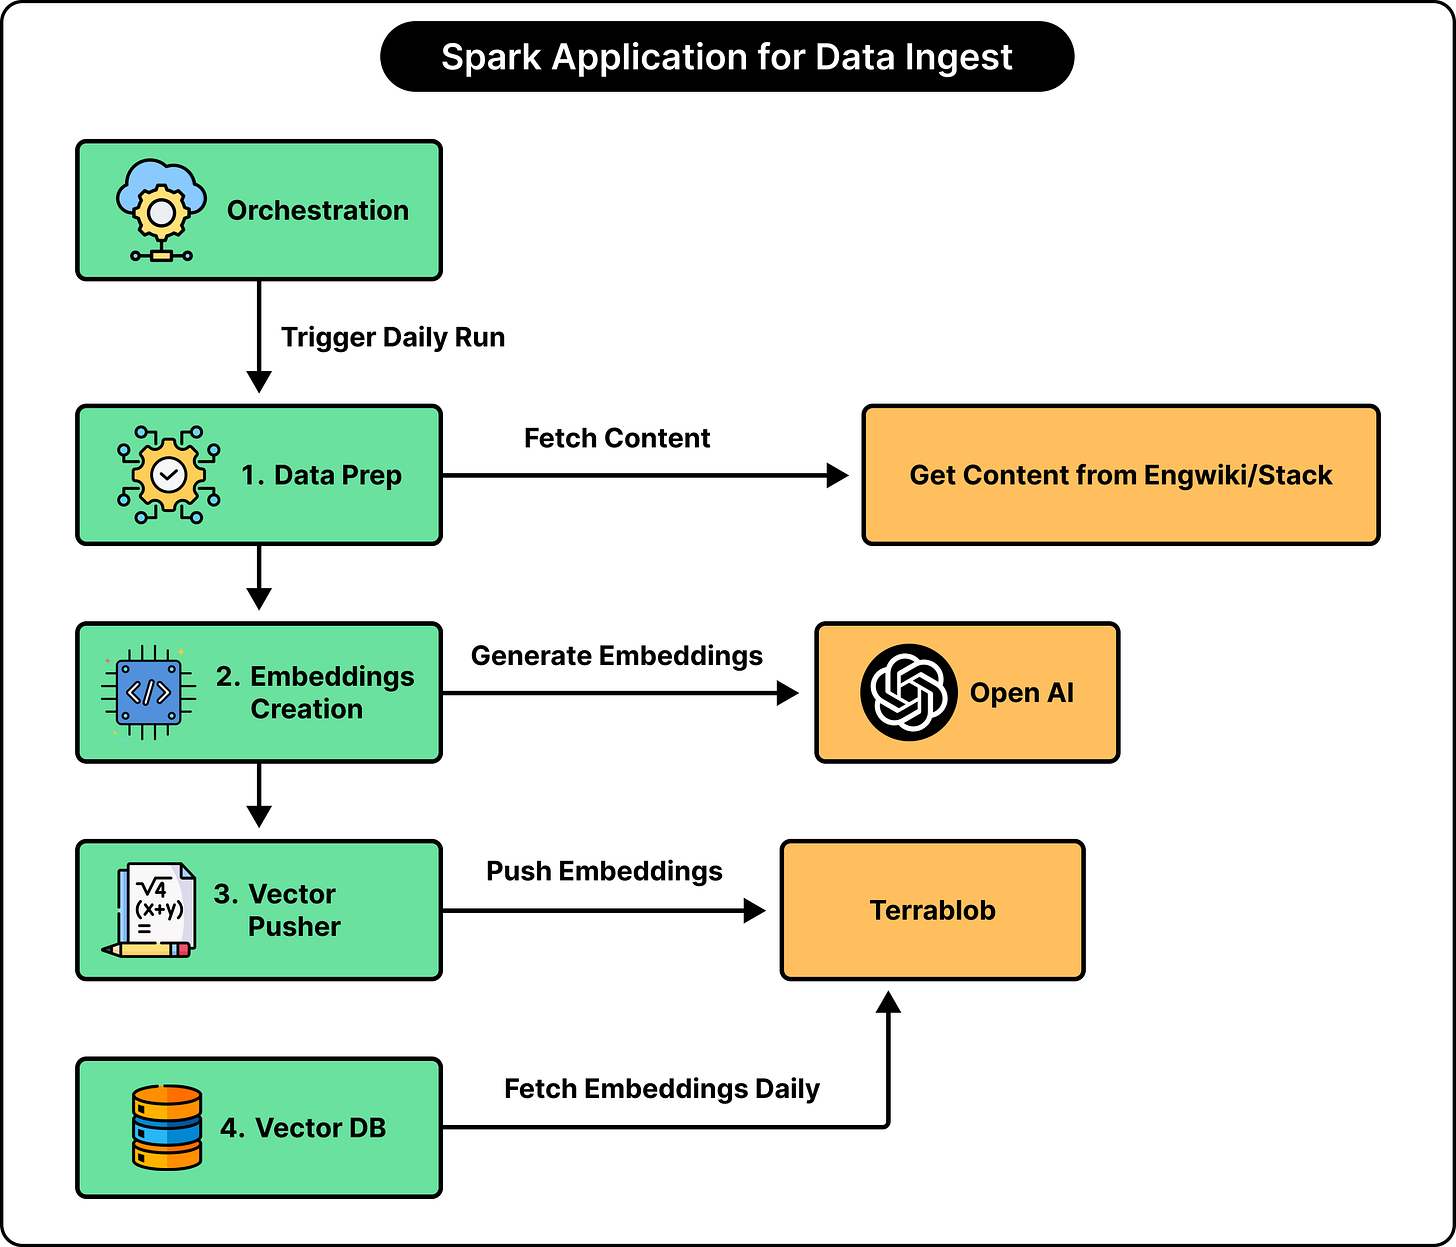
Uber内部AI助手Genie通过Slack解答工程支持问题,采用RAG而非微调:用Spark ETL管道从Engwiki等来源提取文档,经LangChain分块和OpenAI嵌入模型生成向量,存入内部向量数据库Sia供检索。提问时先检索相关片段,再连同来源URL交给LLM生成带引用的回答以减少幻觉。Genie支持追问、标记解决或转人工,并收集四类反馈存入Hive分析;Uber还用LLM评审评估回答与文档质量。上线一年覆盖154个频道,回答超7万问题,有用率48.9%,节省约1.3万小时。
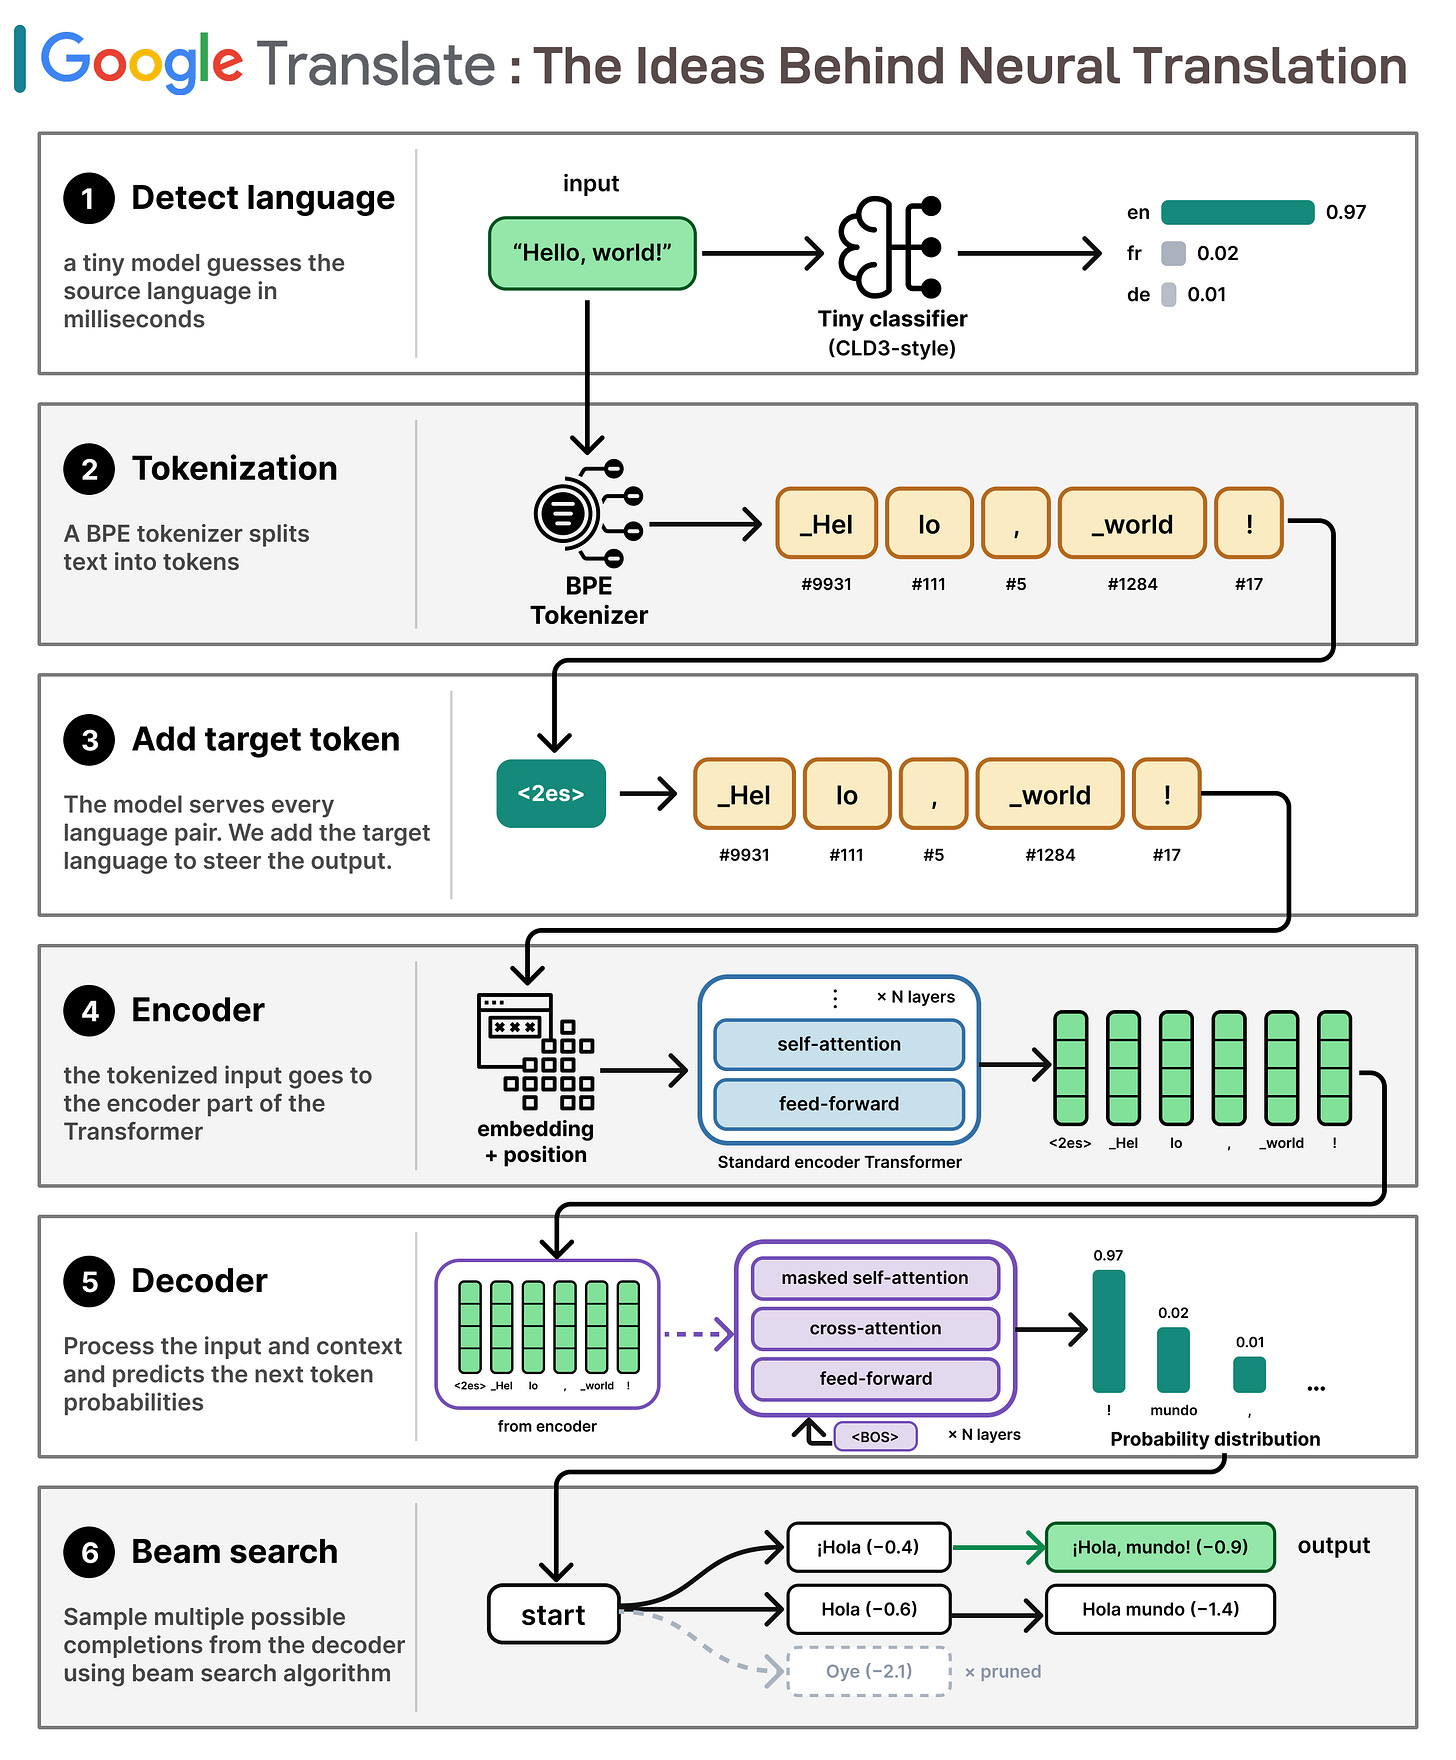
本文介绍RAG智能体的8种分块策略:固定大小、递归、基于文档结构、语义、基于LLM、智能体、延迟分块和分层分块;简述谷歌翻译神经机器翻译流程:语言检测、BPE分词、目标语言标记、编码器、解码器和束搜索;并介绍智能体技能按需加载机制及PostgreSQL进程架构与MySQL线程架构的差异。
大语言模型易产生幻觉,检索增强生成(RAG)通过外部知识降低错误。但标准RAG流程线性、仅单次检索,难以应对多步推理、跨文档综合等复杂查询。Agentic RAG将模型变为自主推理引擎,形成“规划—执行—评估—循环”,具备查询路由、查询分解、自我反思与工具调用四种机制。简单查询宜用标准RAG,复杂高精度场景宜用Agentic RAG,也可混合使用。
OGX 是 Meta Llama Stack 更名后的开源智能体 API 服务器,兼容 OpenAI 接口,支持任意模型与基础设施。文章介绍如何用 OGX 和 Ollama 构建 DocBrain 应用:上传文档实现自动 RAG 检索,并通过自定义工具将文档中的待办事项保存到本地文件。核心优势是本地开发与生产部署可无缝切换,无需重写应用。
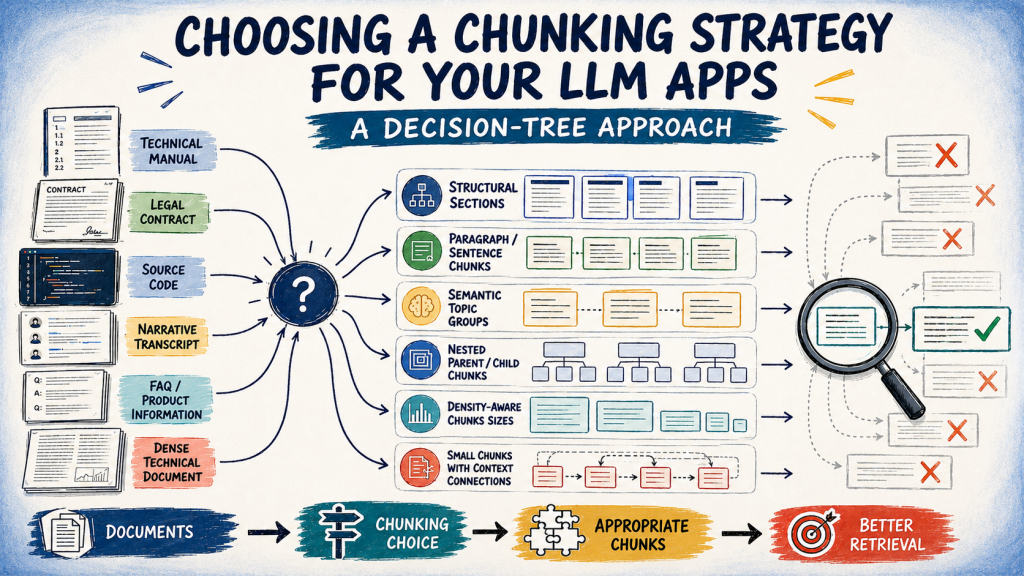
本文介绍RAG系统的分块策略选择,提出六问决策树:文档是否需分块、有无清晰结构、是否需跨段上下文、信息密度是否不均、质量是否优先于成本、语料是否异构。据此匹配固定大小、递归、基于文档、语义、晚期、自适应、层次、LLM及智能体等策略,并识别分块不当的常见症状与修复方法。
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
本文介绍为RAG流水线构建语义缓存:用Qdrant存储历史问题向量,命中则跳过知识库检索和LLM调用,节省时间与成本。相似度阈值需按用例校准,建议用金标集划分训练、验证、测试集调优。高阈值只能覆盖近似重复问题,可用Jev分类器处理灰色地带。缓存需设置过期时间,并在源文档变更时失效。
文章介绍用Python实现声明级RAG证据门禁:模型输出候选声明及来源ID,再由确定性代码逐条校验来源是否存在、是否过期、是否覆盖声明,并输出ALLOW、REVIEW或BLOCK。强调引用应细到声明级,结合语义蕴含、版本化索引与权限过滤,适用于制度问答等场景。
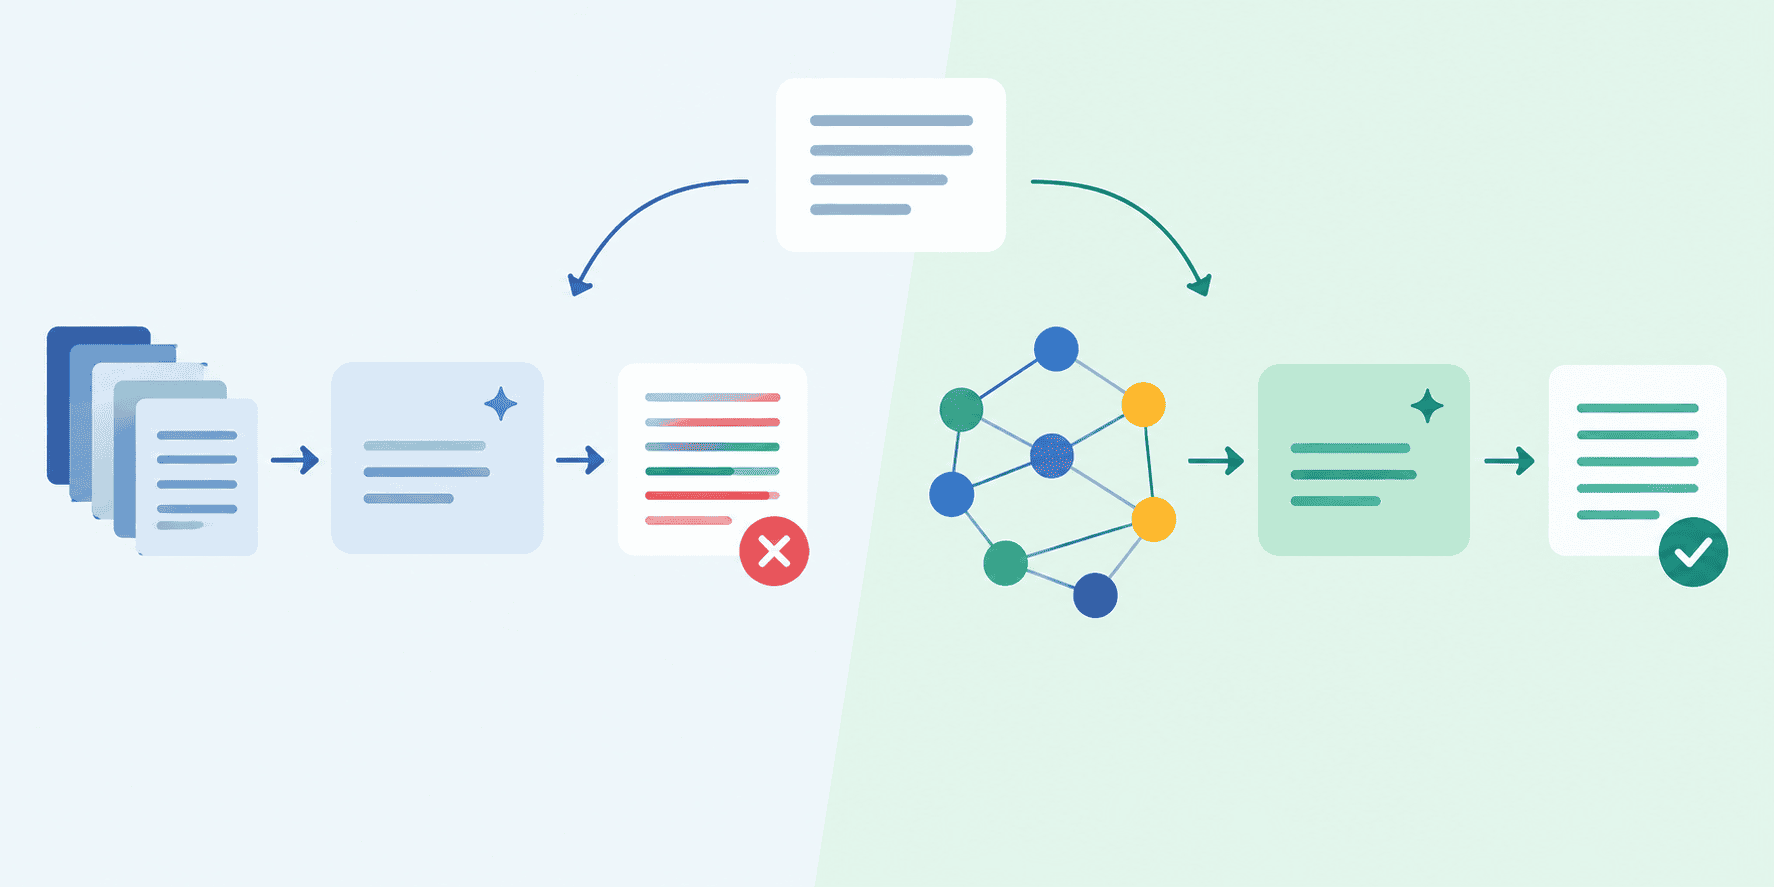
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
文章介绍了决策模型Jev在分类任务中的实验,测试了重排序、减少重复结果、查询理解和语义分块。重排序中Jev优于交叉编码器,但迭代法收益有限;结合MMR可兼顾相关性与多样性;查询理解需谨慎过滤,短查询易误判;语义分块在QASPER上IoU提升13%。建议RAG优先用其分块,产品搜索结合MMR,查询理解潜力大但需更多验证。
谷歌发布开源轻量多模态嵌入模型 EmbeddingGemma 2,基于 Gemma 4 架构,7.4 亿参数,Apache 2.0 许可。该模型首次将文本、图像、音频、视频统一映射到同一嵌入空间,支持端侧运行,文本模式最低约 191MB 内存。其采用模块化设计,支持向量维度动态截断,存储最多减少 6 倍,上下文窗口扩至 8K,代码性能显著提升,适用于本地搜索、RAG 与多模态检索。
谷歌发布EmbeddingGemma 2,基于Gemma 4架构,7.4亿参数,采用Apache 2.0许可。该模型首次将文本、代码、图像、视频和音频统一到同一嵌入空间,支持端侧多模态检索。文本任务仅需2.7亿参数,输出向量可压缩至128维,存储减少6倍。在Pixel 11 Pro上,纯文本仅占约191MB内存。支持8K上下文,可处理5.5分钟音频或29张图像,适合离线隐私检索与RAG。
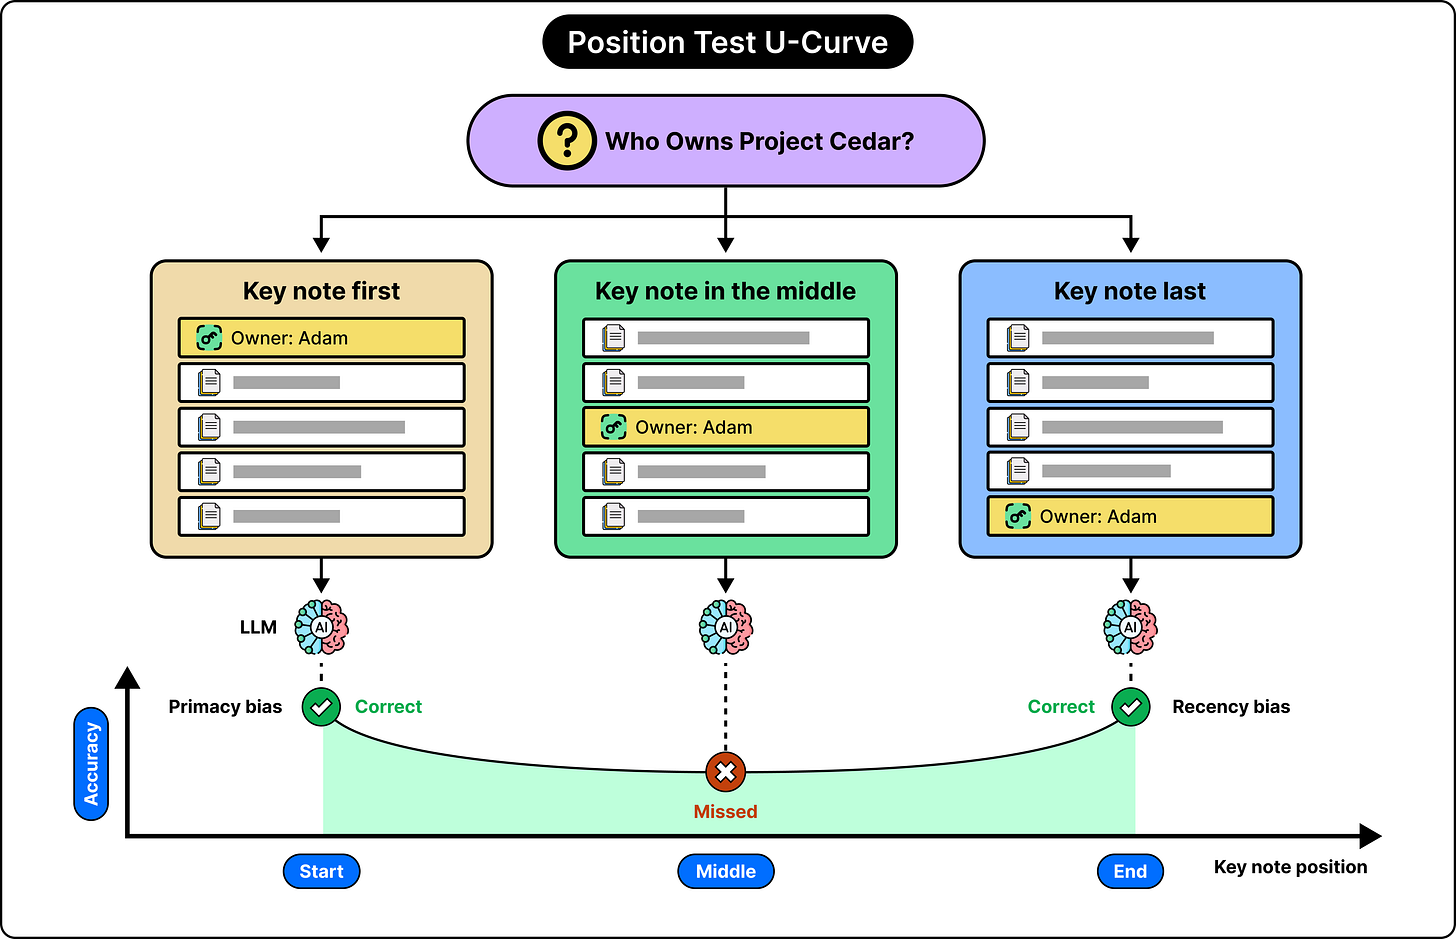
大语言模型存在“中间迷失”现象:关键信息位于长提示词中部时易被忽略,准确率呈U形曲线,开头和结尾表现更好。原因是注意力机制更偏向早期和临近结尾的信息,扩大上下文窗口也无法根治。可通过优化提示结构、精简无关内容、使用RAG检索缓解,但无法完全避免。
该文本仅为 Tanzu Spring 的订阅推广信息,无实质文章内容可总结。
Docling 是 IBM 开源、现由 LF AI & Data 托管的文档处理工具,可将 PDF、扫描件、PPT 等格式统一转为结构化 DoclingDocument,支持导出 Markdown、JSON、HTML,并具备 OCR、表格结构识别、分块和基于 Pydantic 模式的字段提取能力,便于接入 RAG 与自动化流程。
向量检索擅长按语义找相似文本,但无法证明事实关联。当答案依赖多跳关系(如漏洞库→服务→客户→合同→通知政策)时,应引入Graph RAG:将业务记录建模为节点和有向边,显式记录USES、SUPPORTS、GOVERNED_BY等关系。图回答“什么相连”,原文回答“政策怎么说”,二者缺一不可。遍历需限制边类型、跳数、租户边界与时效,缺失边应如实报告而非推断。
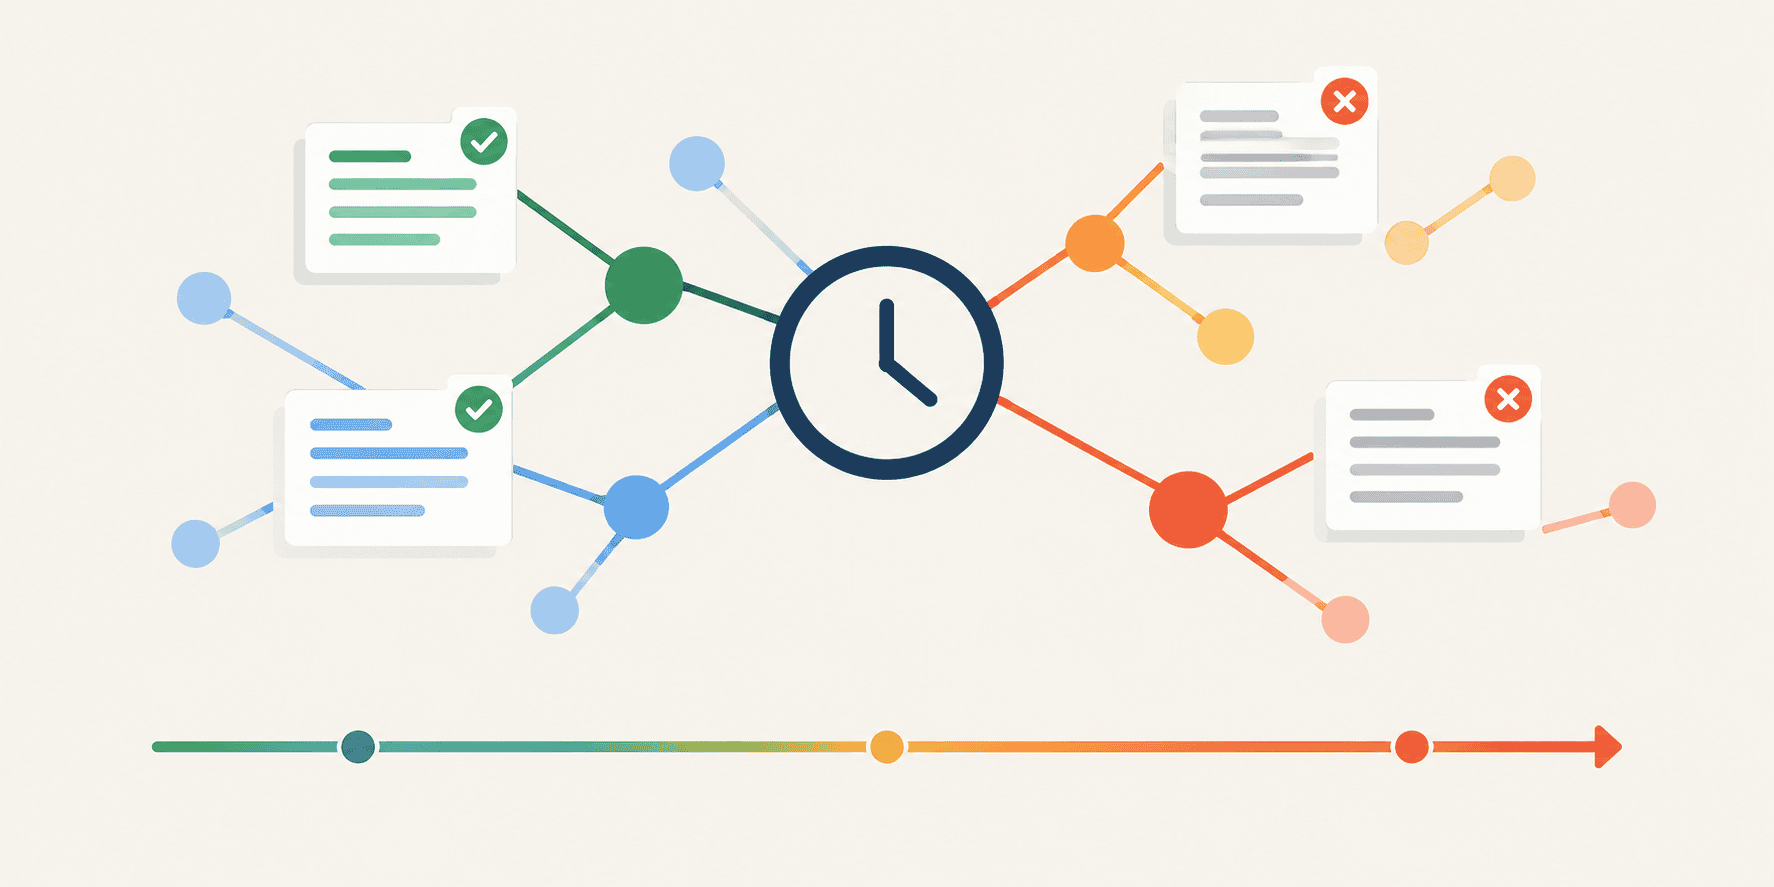
文章介绍为Graph-RAG加入轻量级时间推理层:将传统主谓宾三元组扩展为带时间戳的四元组并存入时间图,用指数衰减计算事实新鲜度权重,按查询日期对冲突事实排序。示例追踪公司CEO变动,展示不同查询日期下答案权重变化,并建议调整半衰期参数。最后提出将时间图接入三层Graph-RAG检索流程,只把最高权重事实传入提示,减少模型猜测。
完成下面两步后,将自动完成登录并继续当前操作。