


NVIDIA Hopper在MLPerf生成式AI中领先
内容提要
NVIDIA使用TensorRT-LLM软件将Hopper GPU在GPT-J LLM上的性能提升了近3倍。H200 GPU在MLPerf的最大生成AI测试中提供了最快的推理性能。NVIDIA还推出了具有更多内存的H200 GPU和GH200 Superchips。NVIDIA的Hopper GPU在MLPerf的每个AI推理测试中表现出色。NVIDIA展示了结构稀疏性、修剪和DeepCache等创新技术。MLPerf基准测试是透明客观的。
延伸解读
H200的显存优势与兼容性
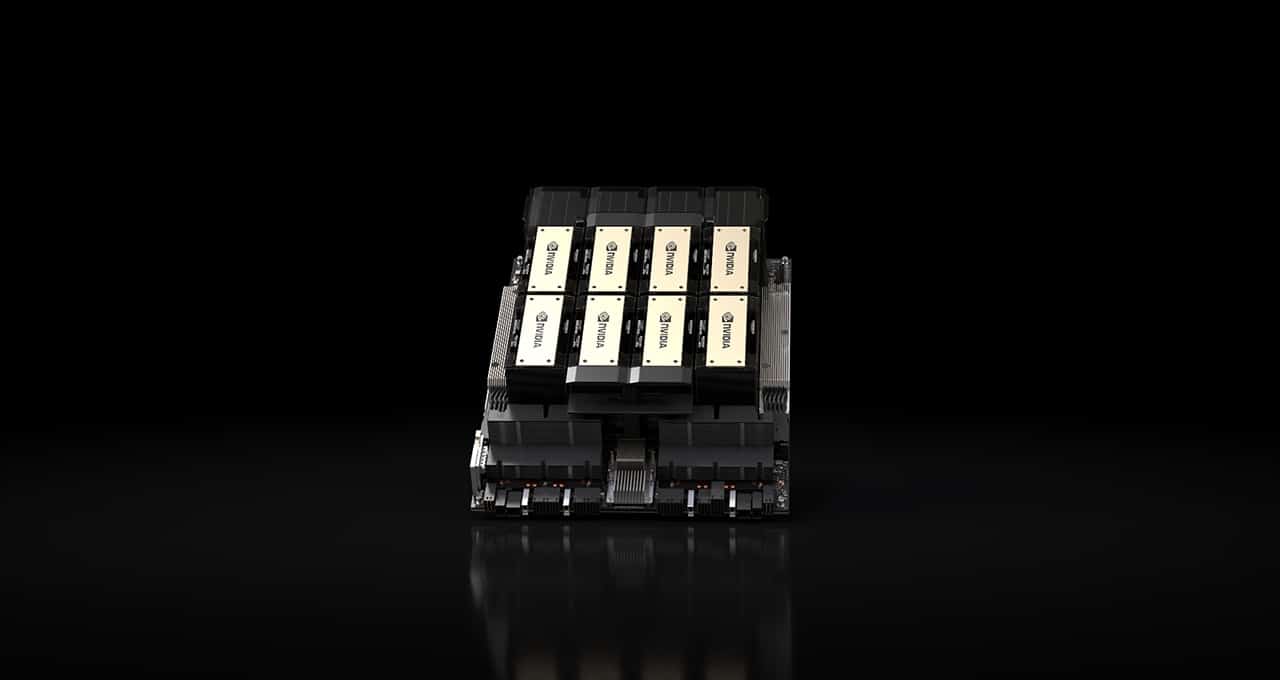
H200 GPU配备141GB HBM3e显存,带宽4.8TB/s,相比H100显存容量提升76%,速度快43%。这使得单张H200就能运行完整的Llama 2 70B模型,无需多卡组合,简化了推理部署。同时,H200与H100使用相同的板卡、系统和软件,现有H100用户可无缝升级,降低了迁移成本。
GH200 Superchip的大内存应用场景
GH200 Superchip结合了Hopper GPU和Grace CPU,提供高达624GB快速内存,包括144GB HBM3e,内存带宽近5TB/s。这种超大内存特别适合推荐系统等内存密集型MLPerf测试,能处理需要大量内存的AI工作负载,为复杂模型提供硬件基础。
开放 division 中的优化技术
NVIDIA在MLPerf开放部门展示了三种创新技术:结构化稀疏性在Llama 2推理中提速33%,修剪技术提速40%,DeepCache优化Stable Diffusion XL提速74%。这些技术均在H100 GPU上运行,展示了通过算法优化进一步提升推理性能的潜力,为未来AI推理效率提升提供了方向。
MLPerf基准的客观性与行业参与
MLPerf测试透明客观,用户可依赖结果做出购买决策。NVIDIA是唯一在最新一轮及自2020年10月以来每轮MLPerf数据中心推理基准中提交所有工作负载结果的公司。众多合作伙伴如华硕、戴尔、HPE、微软Azure等也提交了基于NVIDIA AI平台的结果,帮助客户评估AI系统。
Q&A
NVIDIA Hopper GPU在生成AI推理性能上有什么突破?
NVIDIA Hopper GPU在MLPerf的最大生成AI测试中提供了最快的推理性能,使用TensorRT-LLM软件将性能提升了近3倍。
H200 GPU的内存和速度相比H100 GPU有什么优势?
H200 GPU配备141GB的HBM3e内存,速度比H100 GPU快43%,并且内存容量增加了76%。
GH200 Superchips的特点是什么?
GH200 Superchips结合了Hopper架构GPU和NVIDIA Grace CPU,提供高达624GB的快速内存,具有近5 TB/秒的内存带宽。
NVIDIA在MLPerf基准测试中表现如何?
NVIDIA的Hopper GPU在最新的MLPerf基准测试中在每个AI推理测试中表现出色,成为唯一在所有工作负载中提交结果的公司。
TensorRT-LLM软件的作用是什么?
TensorRT-LLM软件用于加速和简化大型语言模型的推理过程,显著提升了NVIDIA Hopper架构GPU的性能。
MLPerf基准测试的透明性和客观性如何影响用户决策?
MLPerf的测试是透明和客观的,用户可以依赖结果做出明智的购买决策,评估AI系统和服务。
