


基于流的深度生成模型
内容提要
本文介绍基于流的深度生成模型。与GAN、VAE不同,它通过可逆变换显式学习数据分布,损失函数为负对数似然。核心是归一化流:用一系列可逆函数将简单分布逐步变换为复杂分布,要求函数易求逆且雅可比行列式易计算。文章回顾雅可比矩阵与变量替换定理,并介绍RealNVP、NICE、Glow、MAF、IAF等模型。
延伸解读
基于流模型的核心优势:显式密度估计
与GAN和VAE不同,基于流的模型显式地学习数据分布p(x),损失函数直接为负对数似然。这意味着模型可以精确计算数据的概率密度,从而支持密度估计、异常检测等任务。而GAN和VAE只能隐式地学习分布,难以直接获得概率值。这种显式建模使得流模型在需要概率解释的场景中更具优势。
归一化流的设计约束与实现技巧
归一化流要求变换函数易求逆且雅可比行列式易计算。RealNVP通过仿射耦合层满足这些条件,其中部分维度保持不变,另一部分进行仿射变换,且尺度和平移函数可以是任意复杂的神经网络。Glow进一步用可逆1x1卷积替代通道反转,并引入ActNorm,提升了模型性能。这些设计在保证可逆性的同时,增强了表达力。
自回归流:MAF与IAF的权衡
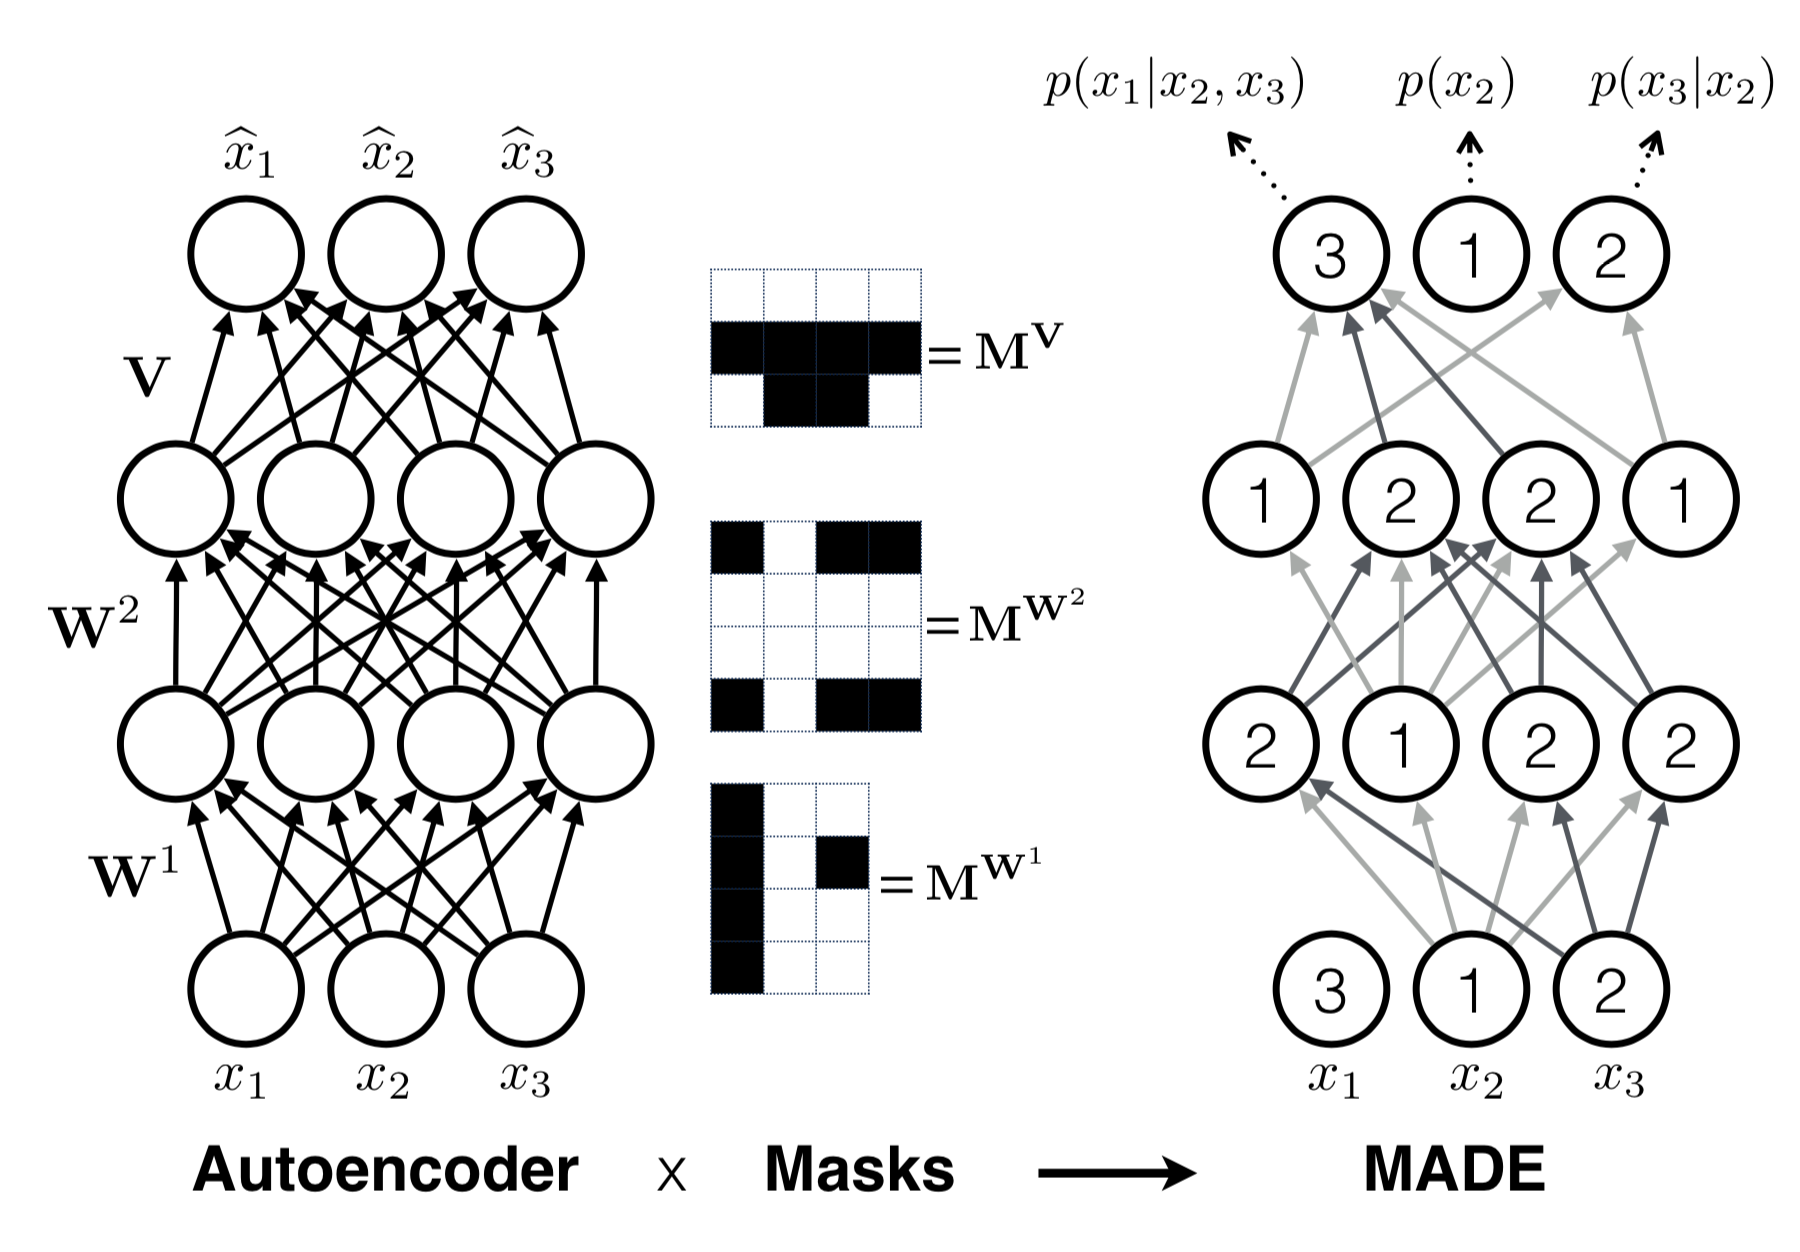
MAF和IAF都是自回归流,但生成和密度估计的效率不同。MAF生成数据时需顺序进行,速度慢,而密度估计只需一次前向传播;IAF则相反,生成快而密度估计慢。选择时需根据任务侧重:若需快速采样,IAF更合适;若需高效密度估计,MAF更优。这种权衡体现了流模型在灵活性与计算效率之间的平衡。
Q&A
基于流的生成模型与GAN、VAE在原理上有什么主要区别?
基于流的生成模型通过一系列可逆变换显式地学习数据分布p(x),损失函数直接是负对数似然;而GAN通过对抗训练隐式地学习生成数据,VAE通过最大化证据下界(ELBO)隐式地优化对数似然。
归一化流中的变换函数需要满足哪两个关键性质?
变换函数需要满足:1) 容易求逆;2) 其雅可比行列式容易计算。
RealNVP模型中的仿射耦合层是如何实现可逆变换的?
仿射耦合层将输入维度分为两部分:前d维保持不变,后D-d维进行仿射变换(缩放和平移),其中缩放和平移参数是前d维的函数。该变换容易求逆,且雅可比矩阵为下三角矩阵,行列式易于计算。
Glow模型相比RealNVP做了哪些改进?
Glow用可逆的1x1卷积替代了RealNVP中的通道反转操作,并引入了激活归一化(actnorm)和仿射耦合层。1x1卷积的雅可比行列式易于计算,且其逆依赖于权重矩阵的逆。
MAF和IAF在数据生成和密度估计的效率上有何不同?
MAF的数据生成是顺序的,速度慢;密度估计只需一次网络前向传播,速度快。IAF则相反:数据生成只需一次前向传播,速度快;密度估计需要顺序恢复潜在变量,速度慢。
在VAE中如何利用归一化流来改进后验分布的建模?
在VAE中,可以使用归一化流将基础高斯分布变换为更复杂的分布,以更好地近似后验p(z|x)。编码器预测一组缩放和平移参数(μ_i, σ_i),这些参数都是输入x的函数。
