


图解 Stable Diffusion
内容提要
Stable Diffusion是一种高性能AI图像生成模型,由文本编码器、图像信息生成器和图像解码器三部分组成。文本编码器将提示词转为向量;生成器在压缩的潜空间中用UNet和调度算法逐步去噪,速度远快于像素空间扩散;解码器最后还原出图像。其扩散原理是先给图像加噪训练噪声预测器,生成时逐步去噪。文本通过注意力层注入UNet以控制生成内容。
延伸解读
潜空间扩散:速度提升的关键
Stable Diffusion 不在像素空间直接扩散,而是通过自编码器将图像压缩到潜空间,扩散过程在潜空间进行。这大幅降低了计算量,使生成速度远快于像素空间扩散模型。文章指出,这是性能提升的重要来源,也让模型能在消费级硬件上运行。
文本编码器:CLIP 的作用与局限
文本编码器采用 CLIP 的 Transformer 语言模型,将提示词转换为 token 向量。CLIP 通过图像-文本对训练,使匹配的图文嵌入相似。文章提到,早期 Stable Diffusion 使用 OpenAI 的 ClipText(6300万参数),而更大语言模型可能提升生成质量,后续 V2 换用了 OpenCLIP。
UNet 中的注意力机制:文本如何控制生成
文本信息通过注意力层注入 UNet。在 UNet 的 ResNet 块之间加入注意力层,将文本嵌入与潜空间表示融合,从而控制生成内容。文章强调,ResNet 块本身不直接处理文本,而是通过注意力层合并文本表示,后续层再利用这些信息。
训练数据决定生成风格
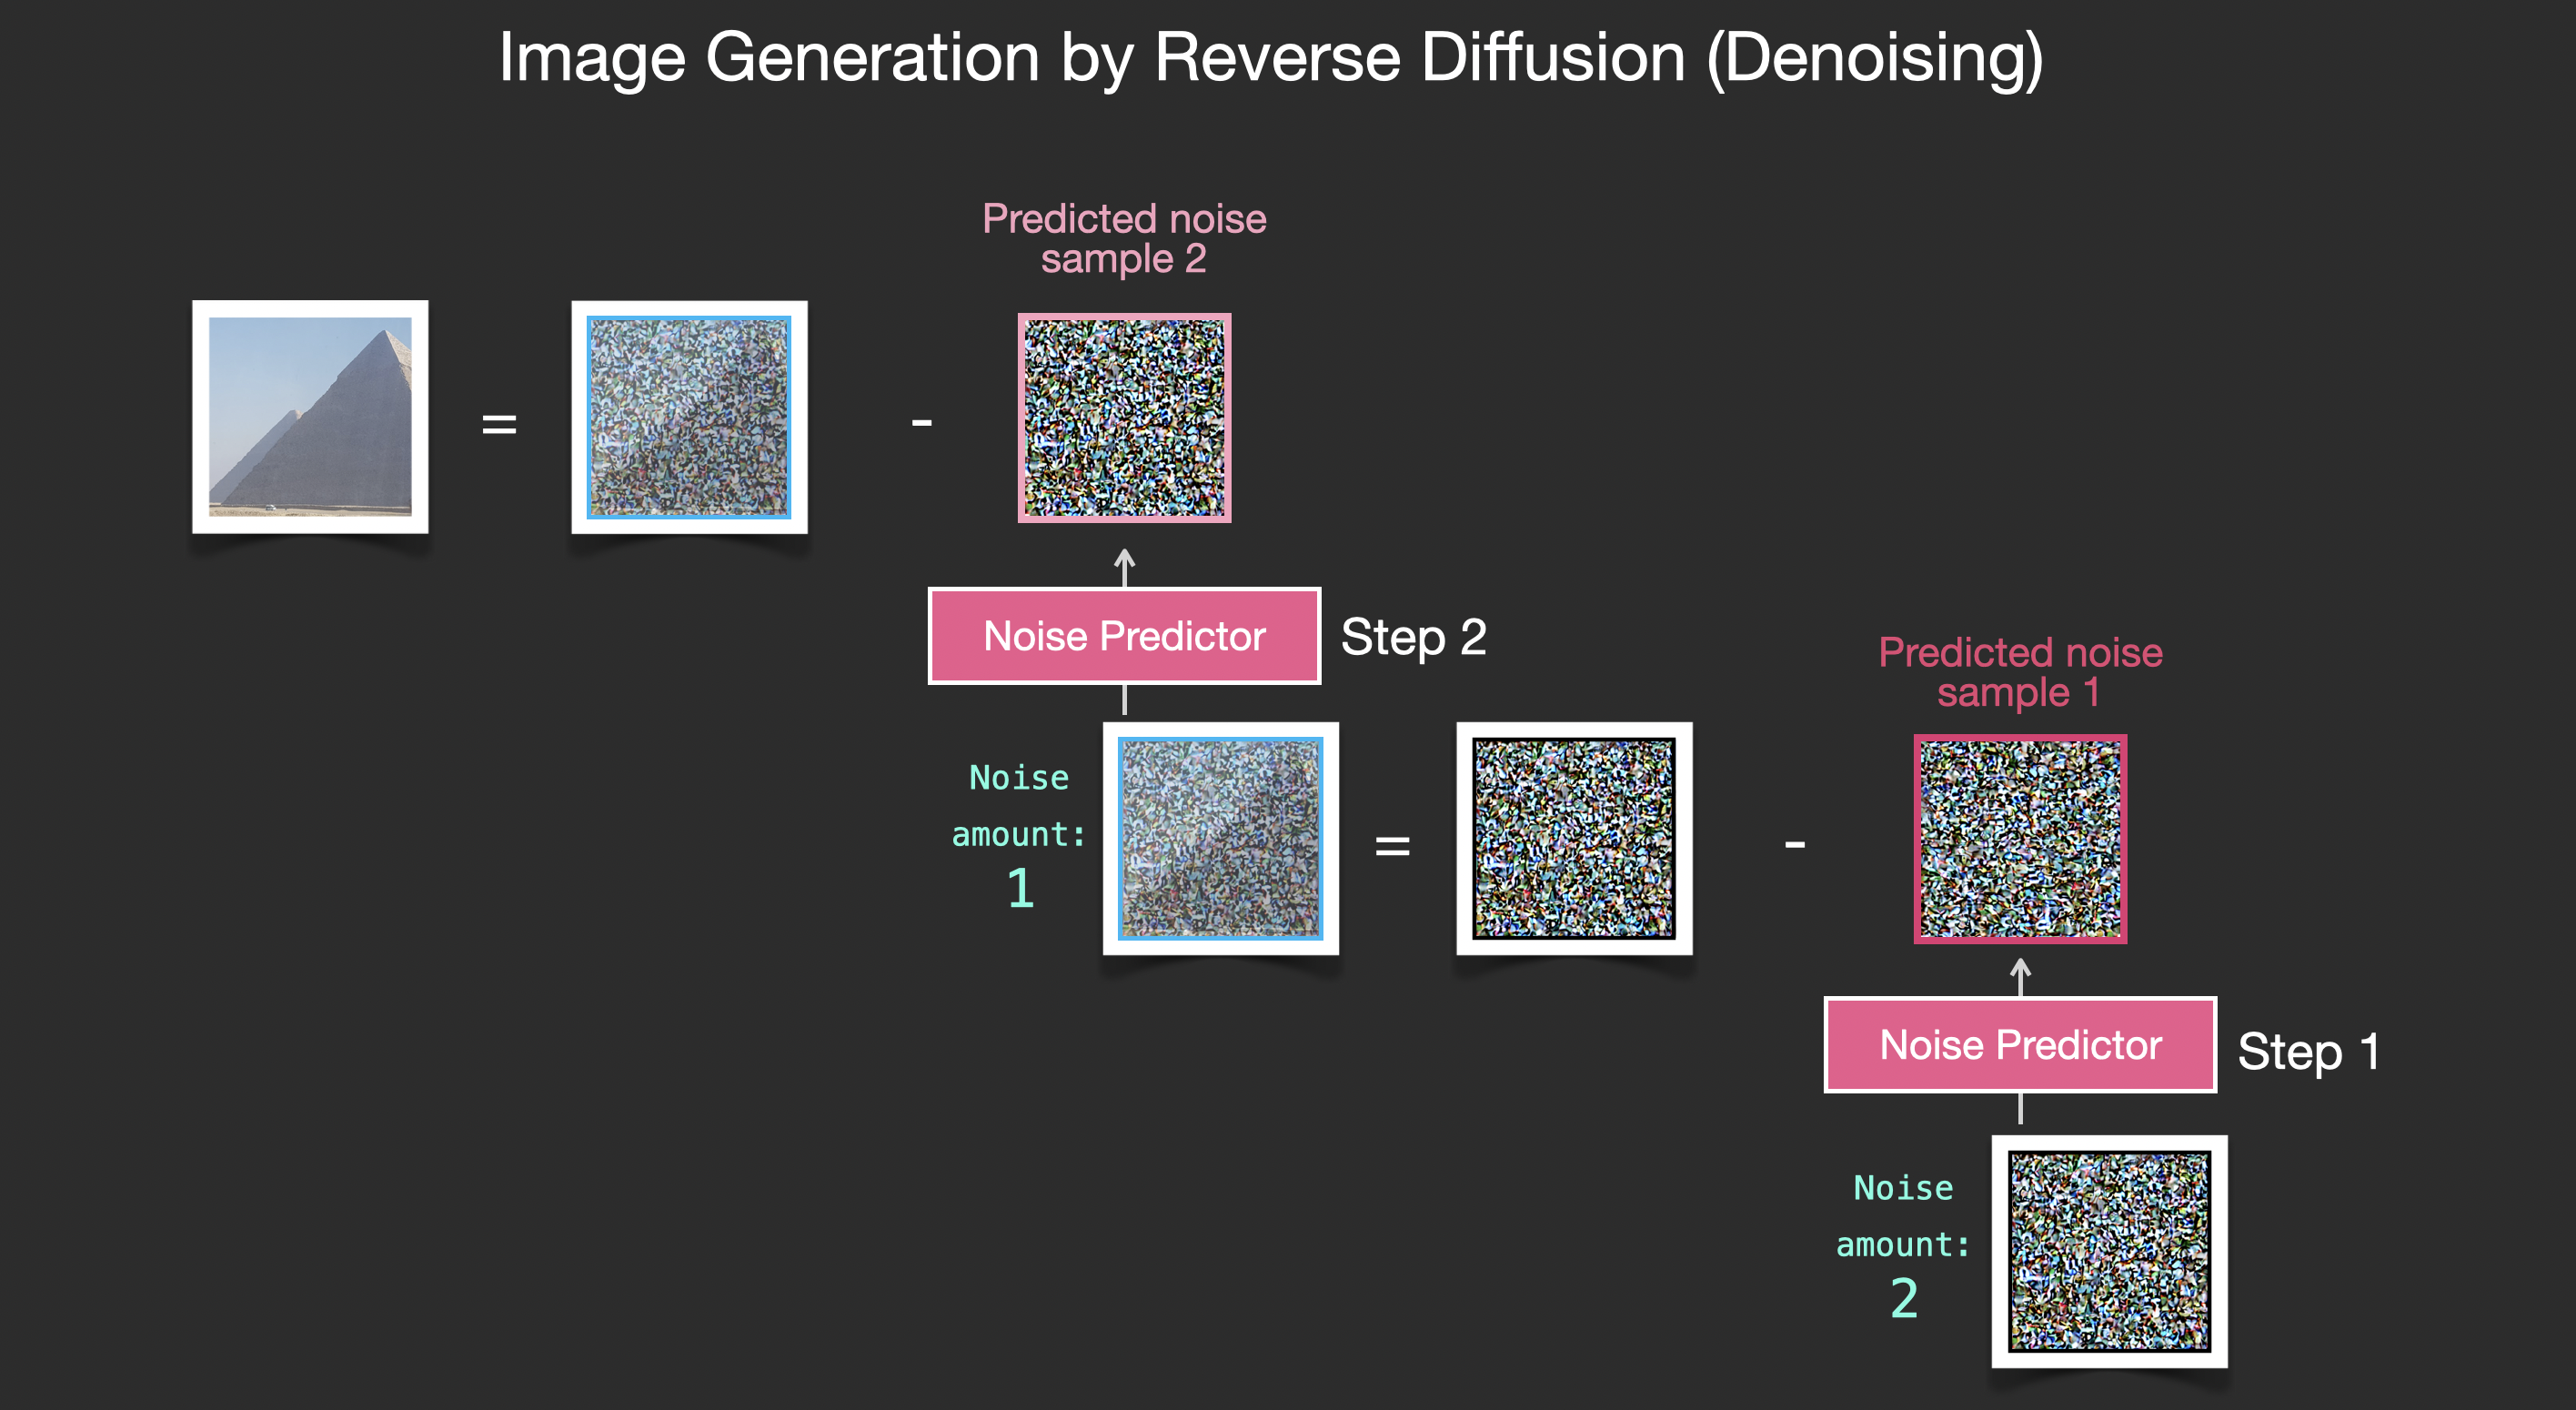
扩散模型通过向图像加噪训练噪声预测器,生成时逐步去噪。文章指出,若训练数据是美学图像(如 LAION Aesthetics),生成结果倾向于美观;若训练数据是标识,则得到标识生成模型。这表明模型输出风格受训练数据分布影响。
Q&A
Stable Diffusion 由哪些主要组件构成?
Stable Diffusion 由三个主要组件构成:1) 文本编码器(ClipText),将输入文本转换为 token 嵌入向量;2) 图像信息生成器(UNet + 调度器),在潜空间中逐步去噪生成图像信息;3) 图像解码器(Autoencoder Decoder),将处理后的信息数组还原为最终像素图像。
Stable Diffusion 中的扩散过程是如何工作的?
扩散过程分为训练和生成两个阶段。训练时,给图像逐步添加噪声,训练一个噪声预测器来预测所加的噪声。生成时,从随机噪声开始,噪声预测器在每一步预测噪声并从当前表示中减去,逐步去噪,最终得到与训练数据分布相似的图像。整个过程在潜空间中进行,由 UNet 和调度算法执行多步(通常50或100步)。
为什么 Stable Diffusion 比之前的扩散模型速度更快?
因为 Stable Diffusion 在压缩的潜空间(latent space)中进行扩散,而不是在像素空间。它使用自编码器将图像压缩为低维潜表示,扩散过程在这些潜变量上运行,大大减少了计算量,从而显著提升了生成速度并降低了资源需求。
文本信息是如何被注入到图像生成过程中的?
文本首先由文本编码器(如 ClipText)转换为 token 嵌入向量。在 UNet 中,通过在每个 ResNet 块之间添加注意力层,将文本表示与潜变量融合。这样,后续的 ResNet 块就能利用文本信息来指导图像生成,实现对生成内容的控制。
Stable Diffusion 的文本编码器 CLIP 是如何训练的?
CLIP 由图像编码器和文本编码器组成,训练数据是大量图像及其描述文本(如网络图片的 alt 标签)。训练时,将图像和文本分别编码,计算嵌入的余弦相似度,并通过对比学习调整模型,使匹配的图像-文本对相似度高,不匹配的相似度低。
Stable Diffusion 的 UNet 中,有文本和无文本时结构有何不同?
无文本时,UNet 仅处理潜变量数组,通过一系列层(包括 ResNet 块)进行变换,时间步被嵌入为向量供各层使用。有文本时,在 ResNet 块之间添加了注意力层,将文本嵌入融合到潜变量中,使后续 ResNet 块能利用文本信息。
