


读论文: Direct Fact Retrieval from Knowledge Graphs without Entity Linking
内容提要
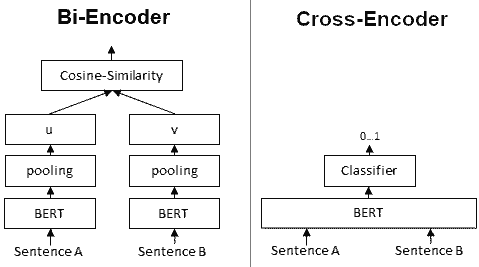
论文提出无需实体链接、直接从知识图谱检索事实的两步方法:先用双塔模型分别编码句子与三元组,通过对比学习计算相似度并召回候选;再用单塔模型拼接句子和三元组进行精排。召回阶段使用DistilBERT,精排阶段使用MiniLM。作者指出不加精排效果不佳,且未开源代码。
延伸解读
两阶段设计的取舍
文章采用召回加精排的两阶段流程:召回阶段用双塔模型独立编码句子和三元组,三元组向量可离线预计算,适合大规模知识图谱的快速筛选;精排阶段用单塔模型拼接句子与三元组做精细打分。这种设计在效率与精度之间取得平衡,但召回质量直接决定最终上限,若候选未包含正确事实,精排无法弥补。
跳过实体链接的代价
方法直接学习句子与三元组的相似度,省去了实体识别和链接步骤,避免错误传播。但这也意味着模型需从句子中隐式捕捉实体信息,对表达多样或实体模糊的句子可能不够稳定。文章未开源代码,复现和进一步比较存在门槛,读者需注意其实际部署的可行性。
模型规模与效果
召回使用DistilBERT(66M参数),精排使用MiniLM(22M参数),整体参数量较小,利于实际部署。但作者指出不加精排效果不佳,说明单靠双塔召回难以保证精度,精排环节不可省略。训练细节上,问答任务批大小为512,对话任务为32,学习率2e-5,训练30轮,这些设置对复现结果有影响。
Q&A
这篇论文提出的方法主要解决什么问题?
该论文提出一种无需实体链接、直接从知识图谱中检索事实的方法,跳过传统的实体识别和实体链接步骤,直接学习句子与三元组的相似度。
该方法的两步流程具体是怎么做的?
第一步召回:用双塔模型分别编码句子和三元组,通过对比学习计算相似度并召回候选三元组;第二步精排:将句子和三元组拼接后输入单塔模型进行精排。
召回阶段和精排阶段分别使用了什么模型?
召回阶段使用DistilBERT(66M参数),精排阶段使用MiniLM(22M参数)。
如果不加精排步骤,效果会怎样?
论文指出不加精排的效果不好,说明精排步骤对最终性能至关重要。
三元组的嵌入是如何处理的?
三元组的嵌入是线下预先计算好并存储的,与句子编码独立进行(双塔结构)。
论文是否开源了代码?
没有开源代码。
