

LeetCode DFS 刷题模板
内容提要
深度优先搜索(DFS)是一种遍历树或图的算法,主要步骤包括从起始节点开始,标记已访问节点,递归访问相邻节点,直到所有路径搜索完毕。常见应用包括计算岛屿数量、填充被围绕区域和克隆图等。DFS模板通常包括确定结束条件、起始节点、访问节点及状态变量更新。
延伸解读
DFS 模板的通用性与变通
文章给出的 DFS 模板分为四步:确定结束条件、起始节点、单次访问节点和状态变量更新。这一框架在图和二叉树问题中通用,但具体实现需根据题目调整。例如,岛屿数量中状态变量是岛屿计数,而被围绕的区域中则无需返回值,仅修改数据。读者应理解模板的灵活性,避免生搬硬套。
图与二叉树 DFS 的关键差异
图 DFS 需要标记已访问节点以避免重复,通常使用 visited 集合或修改原数据;二叉树 DFS 则依赖递归边界(如 root == nil)和左右子树遍历。二叉树问题中,中间状态(如每层和、路径和)常通过指针参数或返回值传递。理解这些差异有助于快速套用模板。
状态变量传递的两种方式
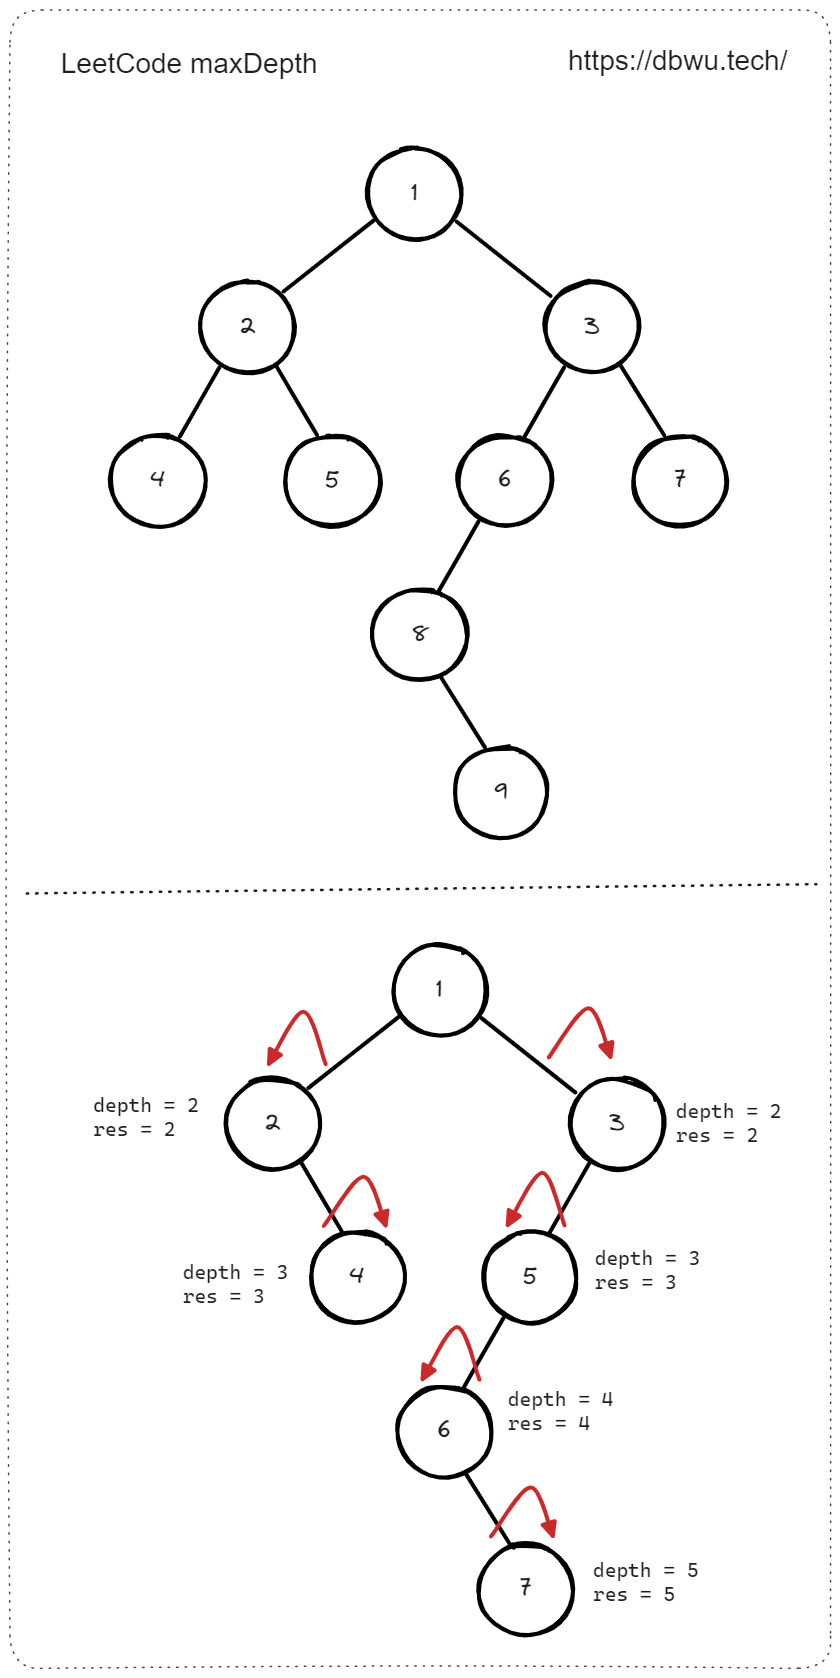
文章展示了状态变量的两种处理:指针参数(如最大深度、层平均值)和返回值(如根到叶数字之和)。指针方式适合需要累积或更新全局状态的场景,返回值方式则适合自底向上计算。选择哪种方式取决于问题是否需要“中间状态数据值”在递归中持续更新。
边界条件与剪枝的重要性
DFS 的递归结束条件不仅是防止死循环的关键,还能及时剪枝提升效率。例如,在二叉树中,if root == nil 是最常见的边界;在图中,需检查坐标越界或节点不满足条件。文章强调,正确处理边界能提高代码可读性和执行效率,是刷题时不可忽视的一环。
Q&A
深度优先搜索(DFS)的基本步骤是什么?
DFS的基本步骤包括从起始节点开始遍历,标记已访问节点,递归访问相邻节点,直到所有路径搜索完毕。
DFS在计算岛屿数量时如何应用?
在计算岛屿数量时,DFS用于标记相邻的陆地,并避免重复访问,从而统计岛屿的数量。
如何使用DFS解决被围绕的区域问题?
在被围绕的区域问题中,DFS用于标记与边界相连的区域,避免填充被包围的区域。
DFS的伪代码是怎样的?
DFS的伪代码包括初始化状态,定义DFS函数,递归调用相邻节点,并处理递归结束条件和状态更新。
DFS在克隆图问题中的关键步骤是什么?
在克隆图问题中,DFS需要使用一个Hash存储源节点与克隆节点之间的关系,并递归克隆邻居节点。
DFS在二叉树问题中如何处理左右子树?
在二叉树问题中,DFS需要分别递归处理左右子树,并更新状态变量以计算中间结果。
