Igor Suhorukov:无需分叉的Greenplum:将Apache Cloudberry作为PostgreSQL 19扩展
内容提要
作者借助LLM,仅用12天、629次提交,将Apache Cloudberry(Greenplum的开源延续)移植为PostgreSQL 19扩展而非分支,移植了约93%的数据库代码,59%的原测试通过。核心仅22个小补丁,未加载扩展时行为与原生PG 19一致。ORCA优化器原样复用,TPC-H和TPC-DS全部121条查询均由ORCA规划,比回退方案快3-4倍。
延伸解读
扩展化移植的核心优势
将Cloudberry作为PostgreSQL 19扩展而非分支,最大好处是能直接使用最新PostgreSQL及其生态工具。文章指出,升级新版本只需迁移22个小补丁(约1600行),而非分支模式下的数月合并。同时,上游PostGIS 3.7和pgvector 0.8.6可原样运行,为原生PG 19编译的二进制模块也能直接加载,因为核心ABI未变。
性能表现与适用场景
在TPC-H和TPC-DS SF1测试中,ORCA优化器规划了全部121条查询,答案与DuckDB一致,且比回退方案快3.1倍和4.0倍。但ClickBench显示,在无连接的单表扫描聚合上,向量化引擎(如ClickHouse)比Cloudberry快一个数量级,因为后者执行器仍是行式。因此,该移植适合复杂SQL、大表连接、事务、PL/pgSQL及PostGIS/pgvector场景,而非日志事件分析。
当前限制与迁移代价
移植版尚不完整:Cloudberry的MPP规划器(Route B)未移植,ORCA拒绝的查询会走较慢的gather路线;ORCA规划短查询开销更高(13.7ms vs 0.25ms)。此外,迁移需逻辑dump/restore而非pg_upgrade,438个配置项重命名为gp.前缀,数据库级加密暂由操作系统卷加密替代。集群SERIALIZABLE实际为REPEATABLE READ,且需要打补丁的核心,难以进入托管PG服务。
工程方法与验证严谨性
项目通过严格规则保证核心纯净:未加载扩展时,服务器行为与原生PG 19无异。验证包括371个meson测试全过、abidiff仅新增32个符号、目录和查询ID字节一致、cachegrind指令开销在-0.005%到+0.155%之间。开发中借助LLM并行代理,12天完成629次提交,但关键架构决策和核心补丁仍由人工把控,体现了工程化流程而非单纯依赖代码生成速度。
Q&A
Igor Suhorukov 的 Greenplum 扩展项目是什么?
这是一个个人实验,将 Apache Cloudberry(Greenplum 的开源延续)移植为 PostgreSQL 19 的一组扩展,而不是分支。项目借助 LLM 在 12 天内完成,共 629 次提交,移植了约 93% 的数据库代码,59% 的原测试通过。核心仅需 22 个小的 PostgreSQL 补丁,未加载扩展时行为与原生 PostgreSQL 19 一致。
为什么要把 Greenplum 做成 PostgreSQL 扩展而不是分支?
因为分支方式导致 Greenplum 总是落后 PostgreSQL 几个版本,每次新版本都需要数月的合并工作。做成扩展后,可以直接使用最新的 PostgreSQL 及其生态系统(如 PostGIS、pgvector),升级时只需携带 22 个小补丁(约 1600 行),而不是数月的合并。
这个移植项目在 TPC-H 和 TPC-DS 基准测试中表现如何?
在 scale factor 1 下,ORCA 优化器规划了全部 121 条查询(TPC-H 22 条,TPC-DS 99 条),答案与 DuckDB 一致。相比回退到 PostgreSQL 原生规划器的 gather 路线,ORCA 的几何平均速度分别快 3.1 倍(TPC-H)和 4.0 倍(TPC-DS)。
移植过程中对 PostgreSQL 核心做了哪些修改?
PostgreSQL 19 核心仅需 22 个小补丁(47 个文件,+1578/−41 行),添加了新的扩展点,如 new_oid_hook、combo-CID 钩子、XactAdoptTransactionState() 等。这些补丁确保未加载扩展时服务器行为与原生 PostgreSQL 完全一致,包括相同的测试通过、ABI 稳定、目录和设置字节级相同。
这个扩展方案有哪些限制或不足?
限制包括:需要逻辑迁移(dump/restore)而非 pg_upgrade;438 个配置设置重命名为 gp. 前缀;数据库级加密暂时改为操作系统卷加密;未移植 Cloudberry 的 MPP 规划器(Route B),ORCA 拒绝的查询会走较慢的 gather 路线;短查询 ORCA 规划开销更高(13.7ms vs 0.25ms);集群 SERIALIZABLE 实际为 REPEATABLE READ;需要打补丁的核心,难以用于托管 PostgreSQL 服务。
ORCA 优化器是如何被复用的?
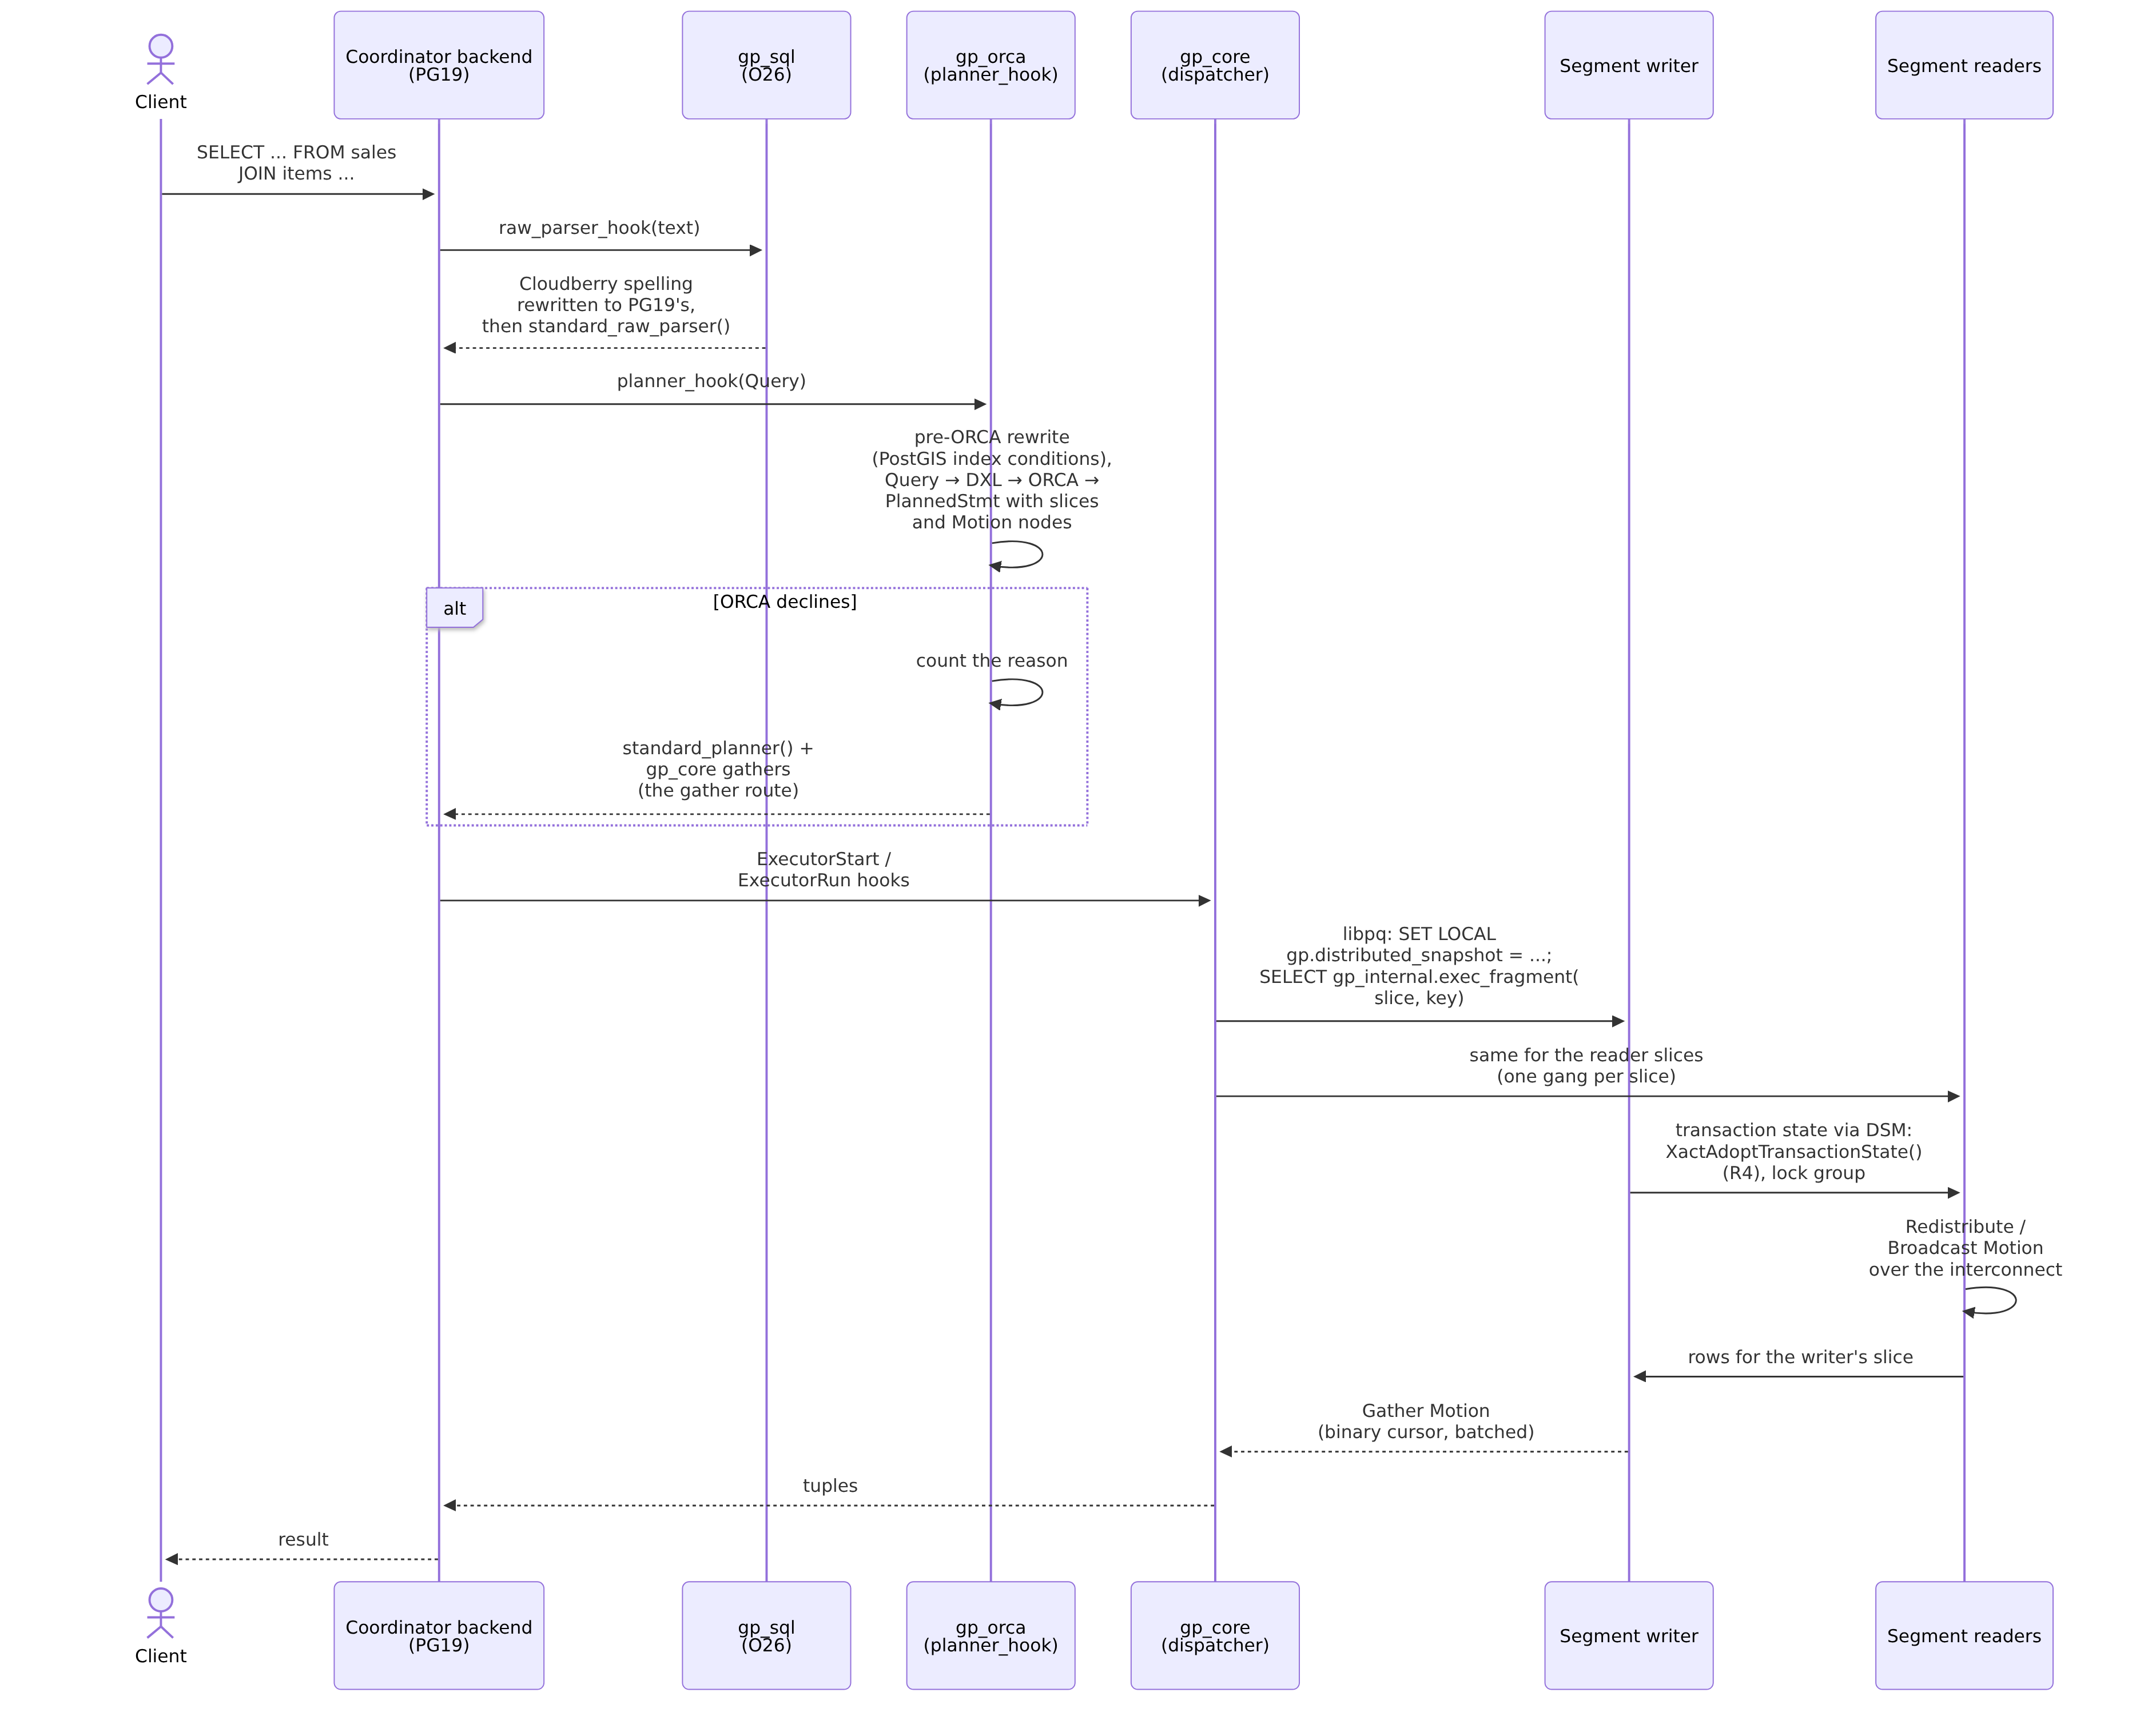
ORCA 的 920 个核心文件(约 38 万行)从 Cloudberry 源码树原样编译,无需修改,因为其核心库不包含任何 PostgreSQL 头文件。它通过移植的 Query ↔ DXL ↔ plan 翻译器(27 个文件,约 3.3 万行)和包装层与数据库通信。包装层的 198 个函数中,170 个只需修改 #include,仅 6 处需要适应 API 变化。
这个移植项目是如何在 12 天内完成的?
借助 LLM(Claude Code)在多个并行 git worktree 中编写代码,作者负责架构决策和结果检查。项目分为多个里程碑(M0 到 M8),从骨架、单节点、集群、事务到镜像和工具,逐步推进。研究阶段有 6 个代理分析代码,计划文档超过 16000 行,测试在 Docker 容器中并行运行。
