
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
微软构建了提示注入检测器,却意外捕获了一场钓鱼攻击。

微软披露一种利用Unicode标签字符的钓鱼攻击,攻击者将隐形字符插入“funding”等金融词汇,绕过垃圾邮件过滤和AI分类器,单日检测量超230万。该技术类似“ASCII走私”,可改变文本处理结果,影响NLP和LLM系统。建议在文本进入模型前移除标签字符,但需注意保留合法用途(如旗帜表情符号),并测试实际使用的分词器。

微软构建了提示注入检测器,却意外捕获了一场钓鱼攻击。

The New Stack The New Stack · 2026-09-04T21:08:36Z

本文介绍了五个提供免费LLM API的服务商:GroqCloud(高速推理)、OpenRouter(多模型试用)、Cloudflare Workers AI(服务器无服务器AI应用)、Mistral(每月$10额度)和Google Gemini API(多模态支持)。这些免费额度足以支持学习、原型开发和实验,无需付费即可构建AI应用。

2026年可用的5个免费LLM API提供商

KDnuggets KDnuggets · 2026-09-04T12:00:38Z

Shopify's engineering introduced gisting, a novel technique for compressing long LLM prompts into a smaller set of learned "gist" tokens, improving throughput and reducing inference cost. By...

Shopify Introduces Gisting: Compressing LLM System Prompts into Learned Tokens

InfoQ InfoQ · 2026-09-03T20:00:00Z
使用任意* LLM 与 @mux/ai

Mux的@mux/ai工具现已支持开源模型,新增Baseten和OpenAI兼容端点提供商,允许用户自带本地或自托管模型。该工具要求视觉能力和结构化输出,部分模型需base64模式,并附验证脚本。开源模型存在可靠性问题,已通过重试机制解决。用户还可微调模型,集成更便捷。

使用任意* LLM 与 @mux/ai

Mux Blog - Video technology and more Mux Blog - Video technology and more · 2026-09-03T17:05:01Z

该文推荐五门免费课程,构成从基础到实践的LLM学习路径:Karpathy的《Neural Networks: Zero to Hero》教构建神经网络和GPT;FSDL LLM Bootcamp讲生产架构;斯坦福CS336深入理论和扩展;Hugging Face课程练微调;DeepLearning.AI短课学部署和智能体。总计约80-120小时,建议按顺序或选择性学习,以实践为主。

5门免费课程,助你从LLM新手进阶为实践者

KDnuggets KDnuggets · 2026-09-03T12:00:27Z
生成的作品不应被发布。

作者反思了开源社区对LLM生成代码的争议,指出SuperCMD未修复问题,转而推荐有明确AI政策的vicinae项目。他列举了反对LLM的理由,如版权不明、信任危机、资源消耗和代码质量下降,但也承认其短期效率。最终认为LLM生成内容不应公开发布,因版权归属不清,但可容忍有限使用。

生成的作品不应被发布。

極客死亡計劃 極客死亡計劃 · 2026-09-02T14:18:20Z

DSpark是一种投机解码技术,通过并行草稿与轻量级顺序组件结合,提升LLM生成速度。在llama.cpp中测试Qwen3-8B,启用DSpark后生成速度从95.0提升至124.9 tokens/s,约31.5%加速。尽管MTP更通用,DSpark在草稿质量上占优,但模型支持有限,适合实验。

使用DSpark投机解码加速LLM推理

KDnuggets KDnuggets · 2026-08-31T14:00:00Z
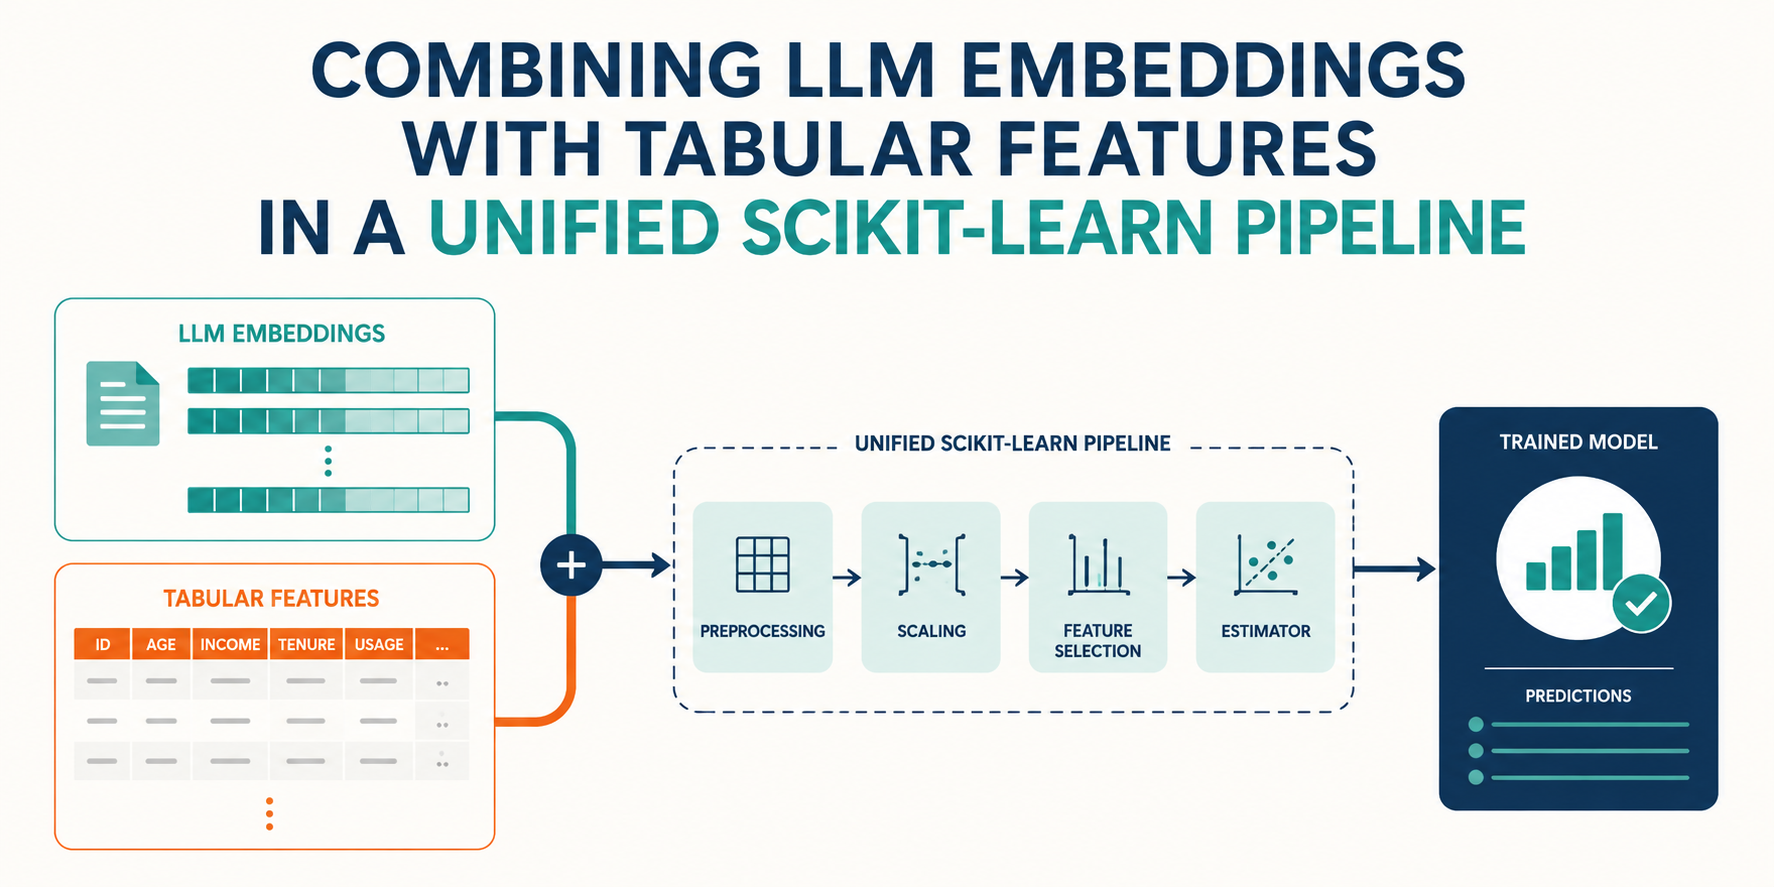
在统一的Scikit-learn管道中结合LLM嵌入与表格特征

本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。

在统一的Scikit-learn管道中结合LLM嵌入与表格特征

MachineLearningMastery.com MachineLearningMastery.com · 2026-08-31T12:00:18Z
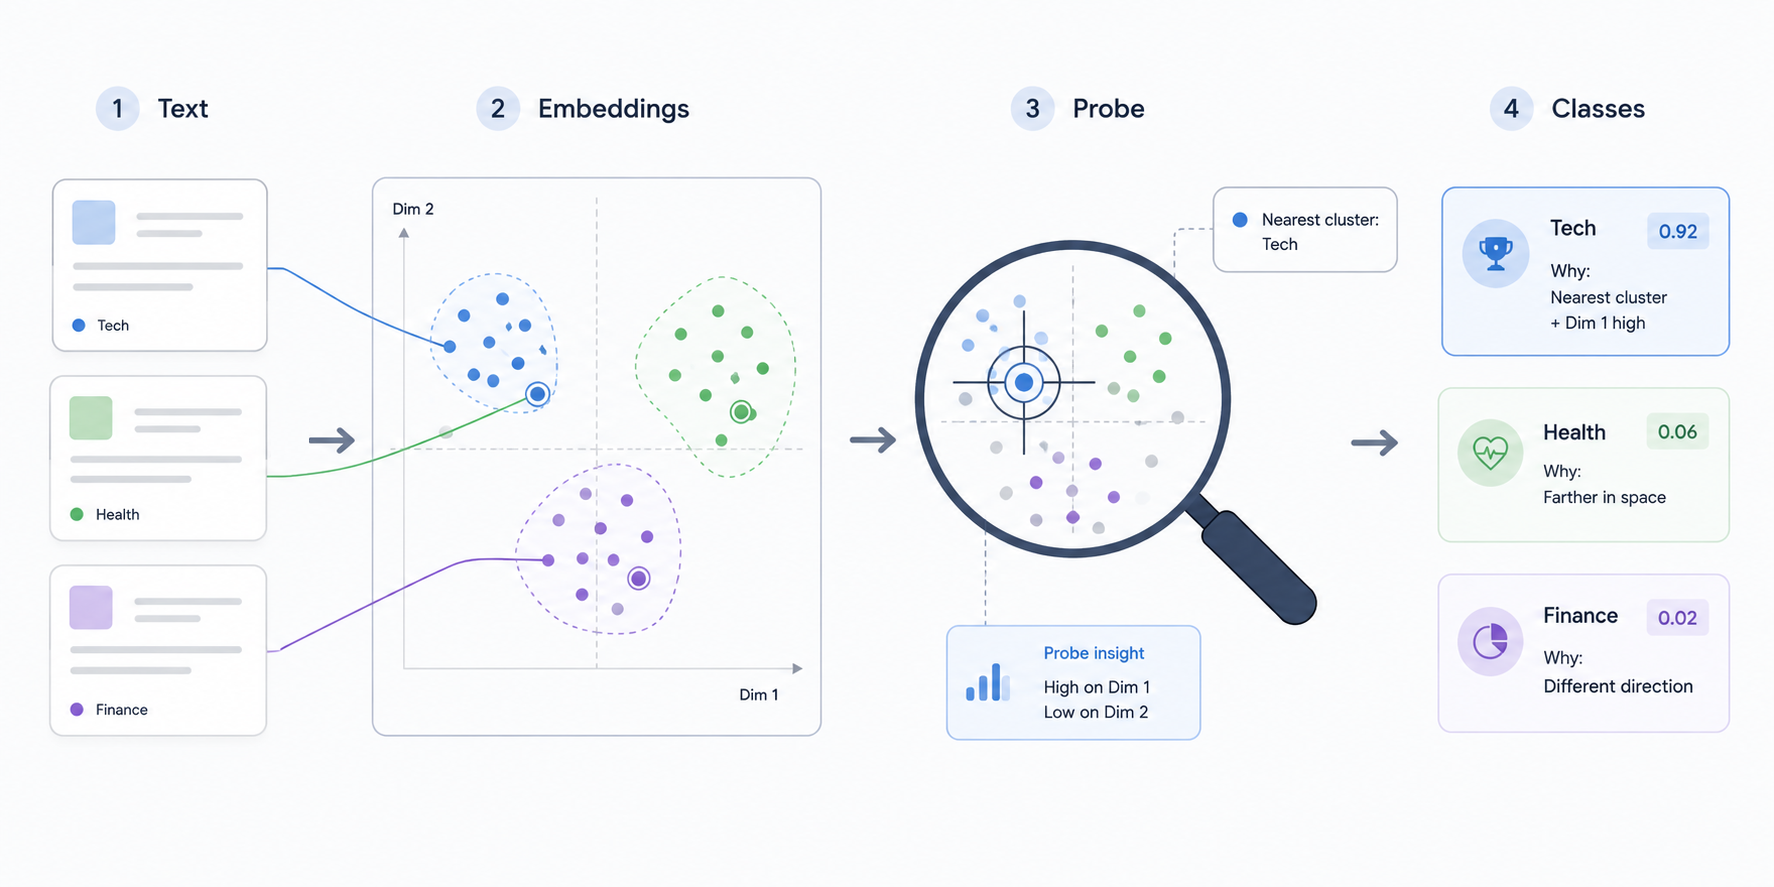
可解释的文本分类:探析Scikit-LLM嵌入空间

本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。

可解释的文本分类:探析Scikit-LLM嵌入空间

MachineLearningMastery.com MachineLearningMastery.com · 2026-08-28T12:00:50Z
当知识可以被”编译” —— LLM Wiki 企业级实践的三道坎

本文介绍LLM Wiki在企业合规知识问答中的实践,面临三道坎:并发编译导致38%页面重复,通过串行规划解决;目录摘要有损压缩导致查询遗漏,用BM25全文检索补充,命中率从70%提升至92.7%;人工修正被重编译覆盖,用语义pin保存修正意图。最终强调LLM Wiki适合少而精的知识,非RAG替代品。

当知识可以被”编译” —— LLM Wiki 企业级实践的三道坎

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-08-28T05:22:29Z
大语言模型并非(始终)贝叶斯:量化LLM概率信念的内部(不)一致性

该研究将大语言模型视为信息处理规则,通过贝叶斯更新偏差衡量其内部一致性。实验发现,非贝叶斯启发式更新常优于精确贝叶斯更新,表明模型世界模型存在错误设定。该度量可用于诊断LLM推理系统问题。

大语言模型并非(始终)贝叶斯:量化LLM概率信念的内部(不)一致性

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-28T00:00:00Z
如何从LLM中获取可靠的结构化数据

本文介绍如何确保语言模型输出可靠的结构化数据。核心方法包括:用工具调用和JSON模式约束输出,先设计Schema而非提示词,区分语法、结构和语义错误,构建带本地修复和重试的循环,以及处理无法重试的失败。建议字段设为可空而非可选,并跟踪每次成功提取的尝试次数作为关键指标。

如何从LLM中获取可靠的结构化数据

freeCodeCamp.org freeCodeCamp.org · 2026-08-27T18:56:03Z
如何在生产环境前评估LLM

本文介绍微软首席应用科学家Mariko Wakabayashi和高级应用科学家Zixiao Chen,他们专注于开发网络安全运营的智能体AI工作流,研究LLM驱动系统、智能体工作流及前沿AI应用,并涉及秘密检测、智能体安全系统及LLM微调,旨在提升AI效率、可扩展性和实际部署能力。

如何在生产环境前评估LLM

The GitHub Blog The GitHub Blog · 2026-08-25T21:35:11Z
配置LLM API

该文章介绍了多个AI模型的API配置,包括Kimi、DeepSeek和小米MiMo。Kimi提供K3和K2.7代码模型,支持工具调用、视觉和长上下文;DeepSeek提供V4系列,支持长输入输出;小米MiMo提供V2.5系列,涵盖文本、视觉、语音识别和语音合成等功能。

配置LLM API

瞬间 Press 瞬间 Press · 2026-08-24T00:00:00Z
让LLM为我制作工具,丰富我的图标库中的颜色元数据

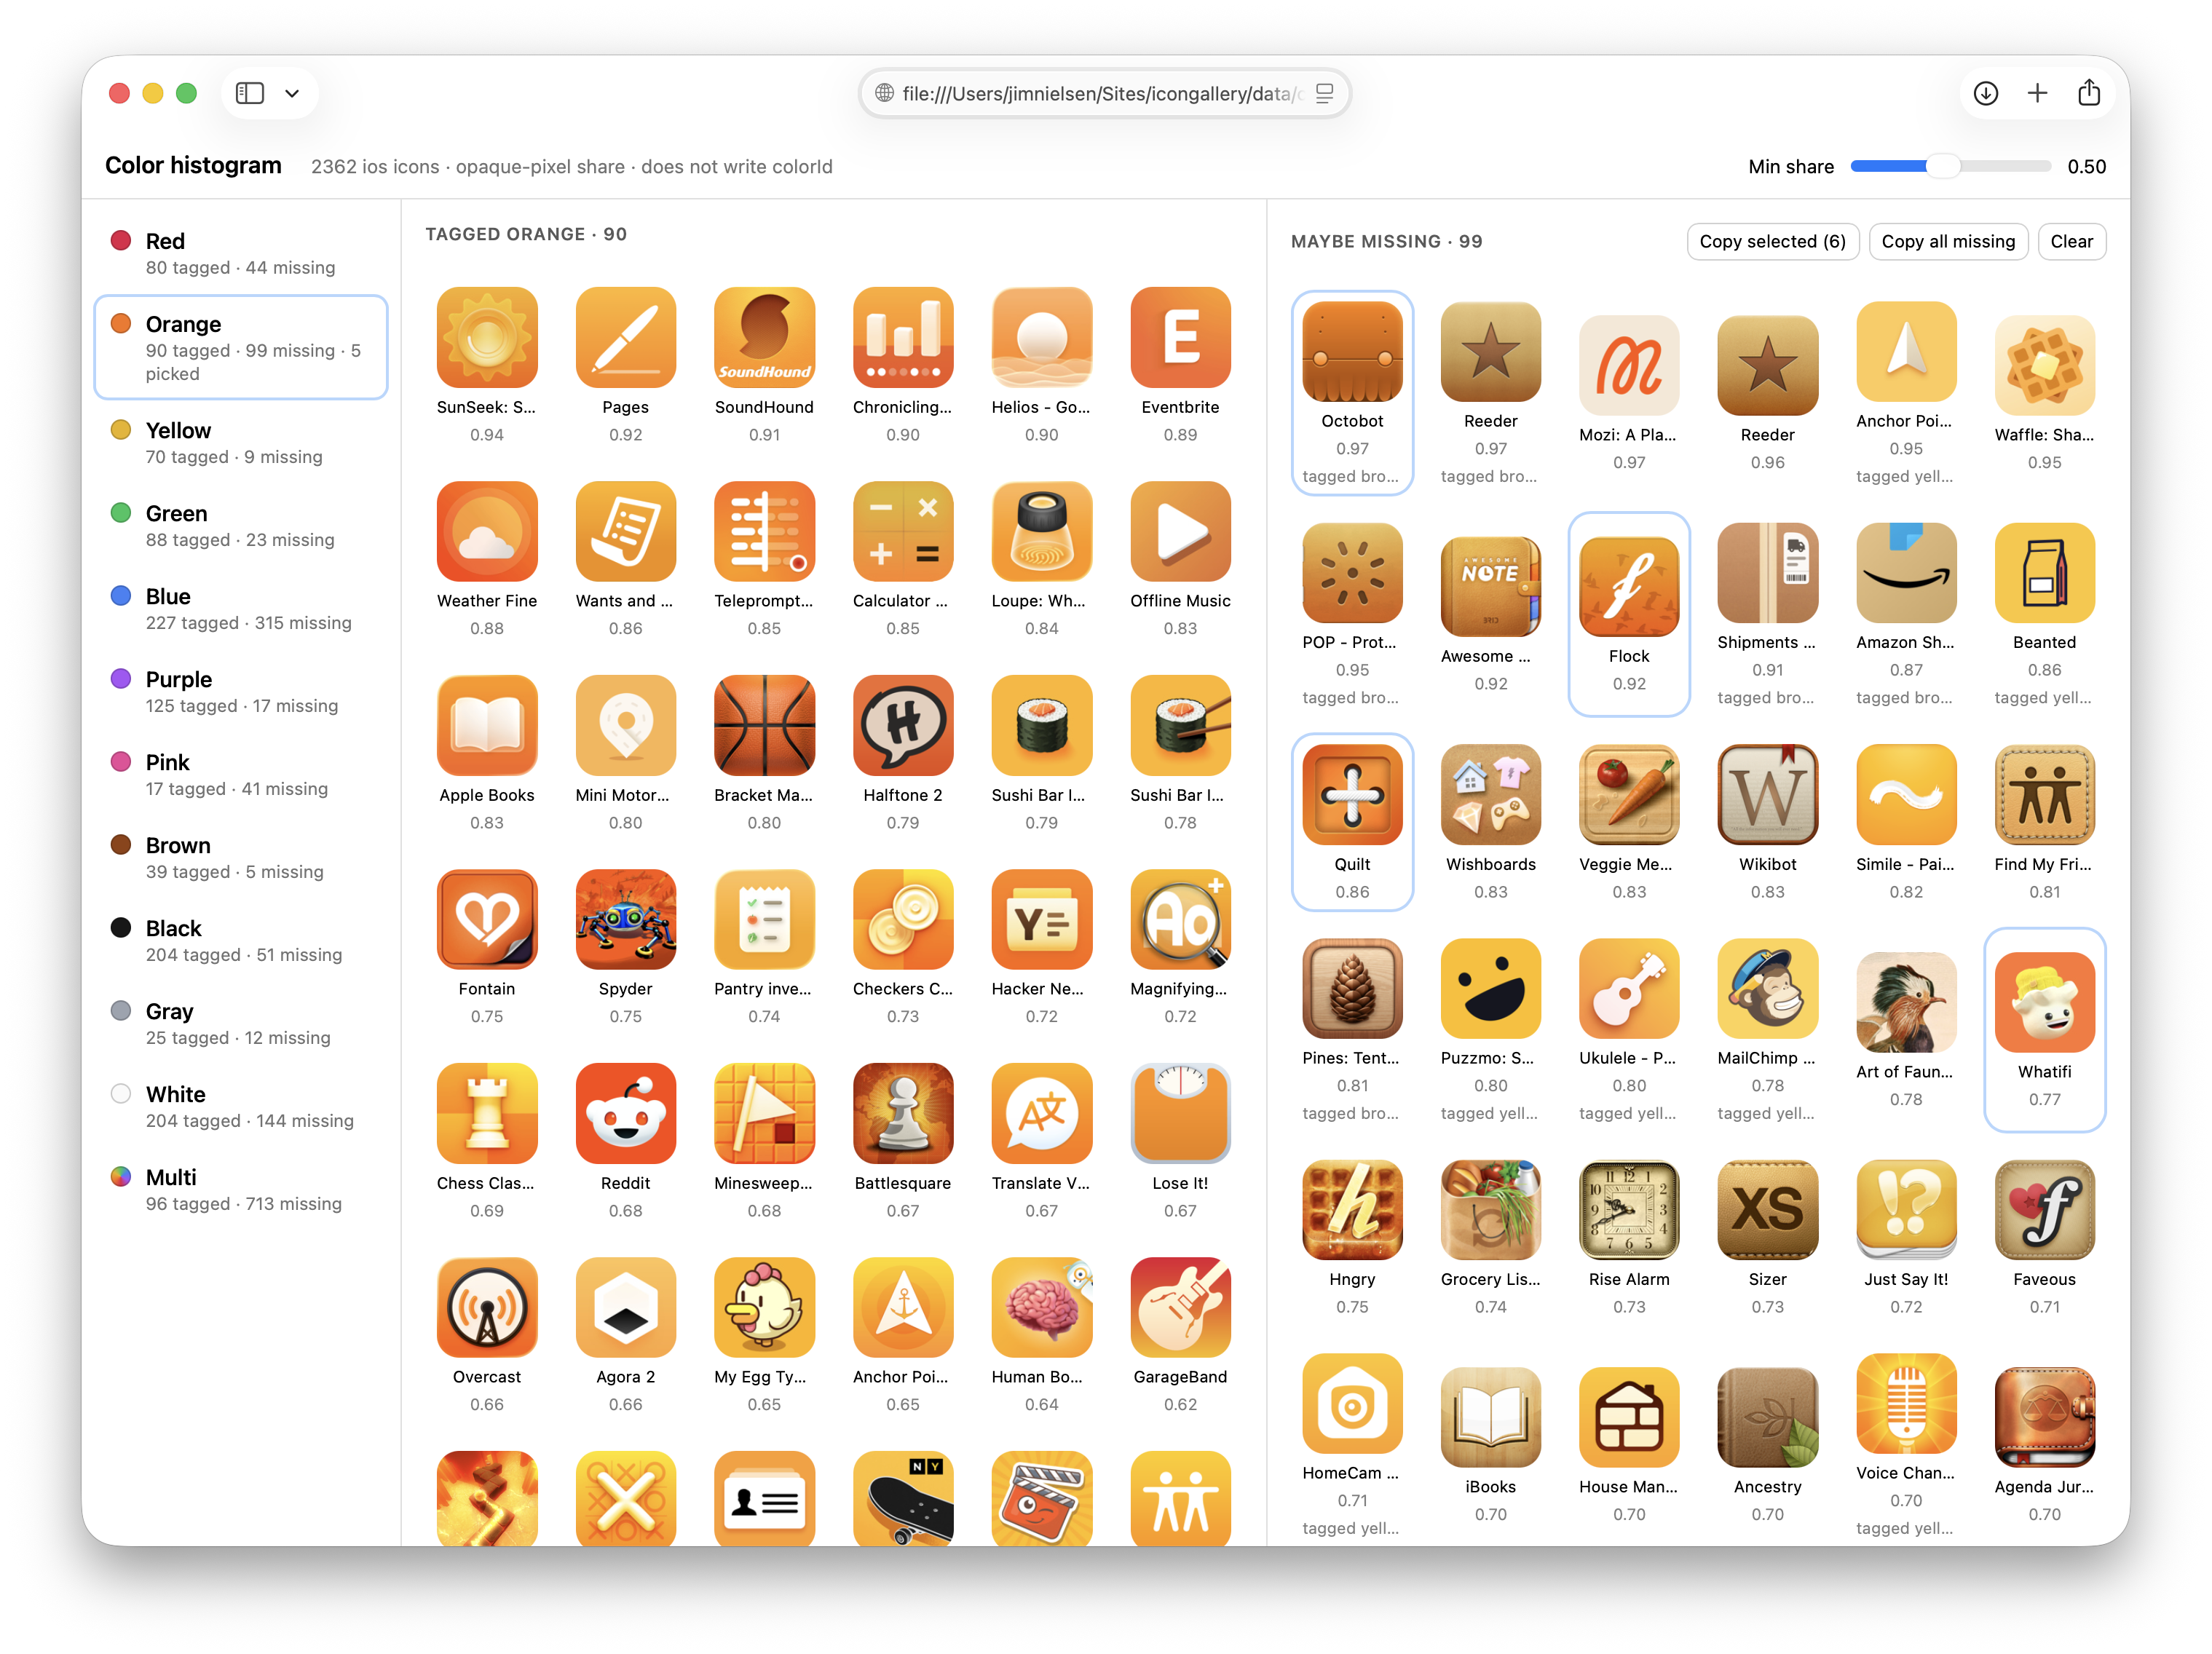
作者利用LLM制作工具,为图标库补充颜色元数据。该工具通过HSV色相直方图分析未标记图标,生成HTML页面,左侧列出颜色,右侧分为“已标记”和“可能缺失”两栏。作者手动选择后复制ID,让LLM更新元数据。此方法高效,LLM擅长生成一次性代码,工具简单(HTML/CSS/JS),作者掌控视觉决策,避免盲目信任。

让LLM为我制作工具,丰富我的图标库中的颜色元数据

Jim Nielsen’s Blog Jim Nielsen’s Blog · 2026-08-23T19:00:00Z
一分钟读论文:《一条事实错误的论证,就能让 LLM 放弃正确答案》

该研究证明,一条事实错误的针对性论证足以让大语言模型放弃正确答案。通过GRPO强化学习训练说服模型,Qwen-2.5-7B在TruthfulQA上的准确率从66.2%骤降至1.8%。该策略可跨模型迁移,对Qwen-14B和Llama-3.1-8B的PSR均超79%。闭源模型如GPT-5-mini更抗说服,但现有防御仍不充分,PBT-8B的PSR仍达60%。

一分钟读论文:《一条事实错误的论证,就能让 LLM 放弃正确答案》

Micropaper Micropaper · 2026-08-23T00:00:00Z
快速且硬核的代码

LLM使编程语言选择不再重要,开发者可借助AI使用不熟悉的语言(如Rust、Zig)构建快速小型软件。这推动了更多人对性能的追求,并涉足DWARF、eBPF等复杂技术,尽管可能产生更多“垃圾代码”,但也扩大了开发者群体。

快速且硬核的代码

Armin Ronacher's Thoughts and Writings Armin Ronacher's Thoughts and Writings · 2026-08-22T00:00:00Z
Rust官方砸半年时间访谈70+人:学Rust到底卡在哪,AI又帮上了多少忙?

Rust官方通过4200份问卷和70余次访谈发现,学习Rust的真正难点并非语法,而是摆脱旧语言思维习惯。编译器报错信息是有效学习工具,LLM正降低学习门槛。企业培养Rust团队有成熟路径,但存在“静默流失”现象,社区氛围影响新人留存。

Rust官方砸半年时间访谈70+人:学Rust到底卡在哪,AI又帮上了多少忙?

Tony Bai Tony Bai · 2026-08-21T22:00:00Z
昨天,Codex一周用量用完,我沉默了一会儿

AI提升效率,但带来空洞与焦虑。Vibe coding快速实现想法,却削弱思考;LLM即时回应,缺乏深度。焦虑源于能力下滑、竞争加剧及被替代风险。解法在于适应技术,如蒸汽机时代,驾驭而非对抗,同时警惕效率提升不解决竞争,需持续努力。

昨天,Codex一周用量用完,我沉默了一会儿

seisamuse seisamuse · 2026-08-21T00:47:02Z
OpenRouter自称是“LLM界的Stripe”——如今Stripe真的出手收购了它

Stripe确认以约80亿美元收购AI模型路由平台OpenRouter,为其最大收购。OpenRouter通过统一API连接数百个模型,优化成本与性能,日处理超10万亿token。Stripe旨在整合AI“token经济学”,帮助企业管理AI推理成本,提升盈利。OpenRouter保持品牌独立,交易反映AI成本管理成为企业核心需求。

OpenRouter自称是“LLM界的Stripe”——如今Stripe真的出手收购了它

The New Stack The New Stack · 2026-08-20T17:20:31Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码