


如何从大语言模型获得可靠的结构化输出:验证、重试与约束解码
内容提要
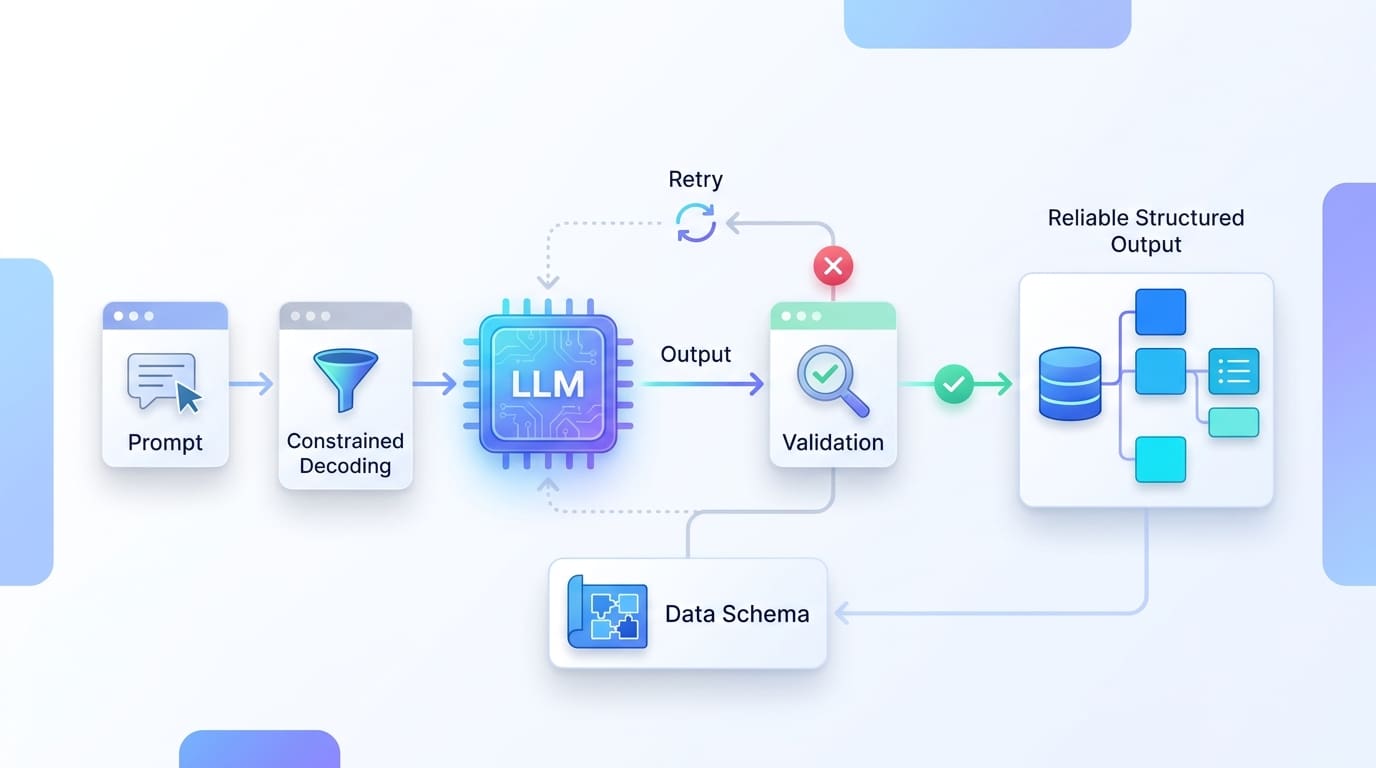
文章指出,仅靠JSON解析或模式校验不足以保证LLM结构化输出正确,例如发票金额12500与原文1250.00不符。应建立三层防护:用严格Pydantic契约校验形状;对照源文本检查引用、币种和金额一致性;仅在形状错误时有限重试(最多三次),并关闭SDK隐藏重试。优先使用约束解码减少格式错误,但保留源校验。结果分为接受、需人工复核、拒绝和形状错误,只有接受结果进入下游。
延伸解读
模式校验的盲区:金额正确性需对照原文
文章用发票示例说明,即使JSON解析和Pydantic模式校验全部通过,模型仍可能输出12500而非125000,因为12500是合法整数。模式只能保证形状,无法保证数值与源文本一致。因此必须在模式校验后增加源文本比对,例如检查引文是否逐字出现、金额数字是否与引文一致。这一步是应用自身的责任,不能依赖解码器或SDK。
重试策略:仅形状错误可重试,且需控制隐藏重试
文章建议最多三次尝试,且只在形状错误时重新生成,因为源文本不会变,内容错误重试无益。同时需注意OpenAI Python SDK默认对连接错误、超时、409、429和5xx自动重试两次,可能使三次应用尝试变成九次HTTP请求。应设置max_retries=0并添加每次调用超时,使重试预算真实可控。拒绝、配置错误等应直接停止。
约束解码减少形状错误,但不替代源校验
约束解码在生成时屏蔽会导致输出无效的token,从而消除格式错误、多余键和类型错误。但文章强调,约束解码只保证结构,不保证正确性:它仍可能生成12500而非125000。因此即使使用OpenAI Responses API的text_format=Invoice,仍需保留accept()中的源文本检查。此外,需检查响应状态是否为completed,无解析输出应视为拒绝而非空发票。
结果分流:仅接受结果进入下游,失败路径必须显式停止
文章将结果分为accepted、needs_review、rejected和shape_error。只有accepted进入下游;needs_review交人工复核并附原因;rejected和shape_error进入错误路径,记录后停止,不重试写入。部署时可自问:每个失败路径是否都在下游动作前停止?若证据缺失、响应不完整或三次尝试耗尽,结果必须是显式复核或错误,而非恰好能解析的看似合理对象。
Q&A
为什么仅靠JSON解析或模式校验不能保证LLM结构化输出的正确性?
因为JSON解析和模式校验只能检查输出的形状(如键是否存在、类型是否正确),但无法发现语义错误。例如,发票金额12500与原文1250.00不符,虽然12500是合法整数,但数值错误,只有与源文本对比才能发现。
如何设计一个严格的Pydantic契约来校验LLM输出?
使用Pydantic模型,设置strict=True禁止类型强制转换,extra='forbid'禁止额外字段,所有字段必填,但允许部分字段为null(无默认值),以便模型明确表示缺失信息而非编造。
在什么情况下应该重试LLM的结构化输出生成?重试次数有限制吗?
仅当输出出现形状错误(如JSON解析失败或模式校验失败)时重试,最多尝试3次(首次加两次重新生成)。对于已接受、需人工复核、拒绝或配置错误等终端状态,不应重试。
如何将LLM输出与源文本进行一致性校验?
检查输出中的引用文本是否逐字出现在源文本中,身份标识(如发票ID)和货币是否与源文本一致,金额是否可从引用行推导(如去除分隔符后的数字与total_cents匹配)。
约束解码如何帮助减少结构化输出的格式错误?它能否替代源文本校验?
约束解码在生成时屏蔽无效token,确保输出符合模式,从而消除格式错误。但它只能保证形状正确,无法保证数值等语义正确,因此仍需保留源文本校验。
LLM结构化输出的结果有哪些状态?每种状态应如何处理?
结果分为四种状态:accepted(接受)进入下游;needs_review(需人工复核)转交人工并附上原因;rejected(拒绝)进入错误路径记录;shape_error(形状错误)可触发有限重试。只有accepted结果允许进入下游。
