
RADAR:用异常检测捕捉灰色故障
内容提要
Databricks 的 RADAR 系统用于实时检测“灰色故障”,即表面健康但部分用户静默失败的问题。它监控用户错误等指标,当大量用户同时遭遇同类错误时自动告警,将故障发现时间缩短 95%,准确率超 90%。该系统基于 Databricks 平台构建,可复用于任意指标,并通过单一脚手架和 AI 代理快速部署。
延伸解读
灰色故障为何难以察觉
灰色故障的特点是表面健康但部分用户静默失败。传统监控指标如CPU、延迟、服务器状态均显示正常,但特定用户群体可能遭遇持续错误。这种差异源于监控视角与用户体验的脱节,即微软研究指出的“差异可观测性”。文章强调,依赖客户报告发现问题会导致数小时甚至数天的延迟,且无法覆盖所有受影响用户。
RADAR的检测逻辑与效果
RADAR通过监控用户错误等指标,当大量用户同时遭遇同类错误时自动告警。例如,多个用户在同一区域无法创建集群,均返回INVALID_ARGUMENT错误,这种“用户过错”的集中爆发实为系统问题。在Databricks内部实践中,RADAR将故障发现时间缩短95%,准确率超过90%,无需人工识别模式,有效控制了故障影响范围。
可复用的构建方式
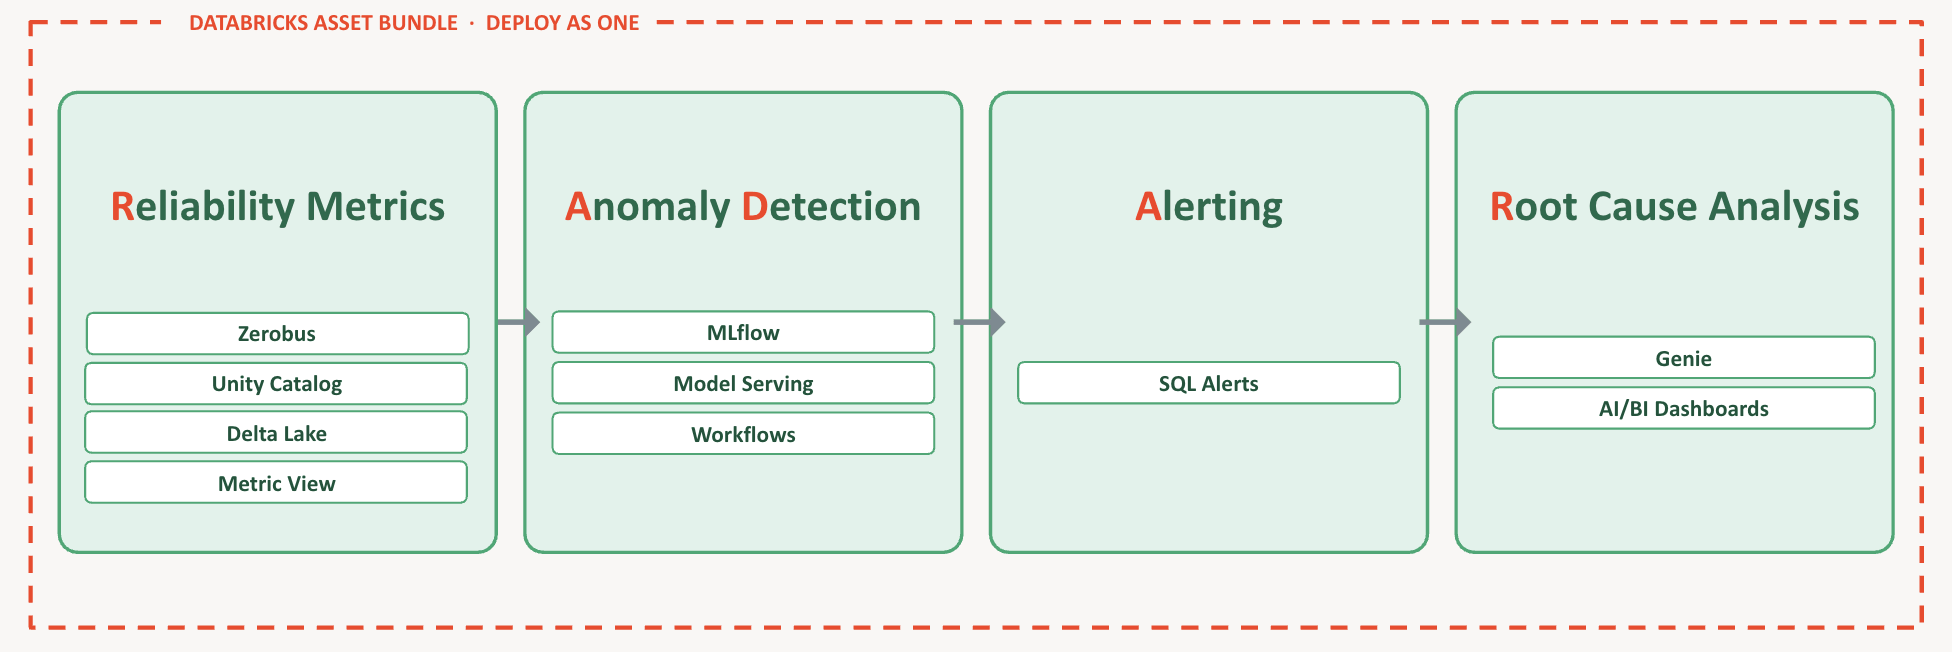
RADAR不限定具体指标,任何可能悄然出错的数值都适用。其四个阶段(收集存储、检测异常、告警去重、可视化)可映射到Databricks平台组件,并通过声明式资产包(DAB)整体部署。用户只需提供自己的指标、脚手架文件和简短提示,AI代理即可自动构建完整系统,降低了实现门槛。
Q&A
什么是灰色故障?为什么它难以被传统监控发现?
灰色故障是指系统表面看起来健康,但部分用户却静默失败的问题。传统监控难以发现,因为所有健康检查指标(如CPU、延迟、服务器状态)都显示正常,但实际已有特定功能失效,导致用户受影响而告警未触发。
RADAR系统是如何检测灰色故障的?
RADAR通过监控用户错误等指标,当大量用户同时遭遇同类错误时自动告警。它基于异常检测,能捕捉到看似用户错误(如INVALID_ARGUMENT)的突然激增,从而发现灰色故障。
RADAR在Databricks的实际效果如何?
RADAR将故障发现时间缩短了95%,准确率超过90%,无需人工识别模式,有效控制了灰色故障的影响范围。
RADAR可以用于哪些场景?
RADAR不限于用户错误指标,任何可能悄悄出错的数值指标都适用,例如延迟、吞吐量、业务指标等。只要指标可能异常,RADAR就能应用。
如何在Databricks上构建类似RADAR的系统?
利用Databricks平台组件:用Delta表收集存储数据,用Job检测异常,用工单告警去重,用仪表板可视化。通过声明式资产包(DAB)部署,并使用一个markdown脚手架文件作为配方,结合AI代理,只需提供指标和简短提示即可自动构建。
依赖客户报告来发现灰色故障有什么问题?
依赖客户报告会导致发现延迟(可能数小时甚至数天),影响范围和收入损失扩大,且客户不应成为监控系统。应增加自动检测来捕捉客户未报告的问题。
