Databricks面向公共部门推出AI治理方案Unity Gateway,集中管理模型访问、成本与合规。机构可控制可用模型及用户权限,按用户、团队或用例设支出上限,并通过智能路由降低成本。平台支持多供应商及开源模型,可按地域管理数据驻留,统一追踪请求、用量与费用,帮助合规和预算团队放心批准AI项目。
本文介绍如何让 Databricks 应用在用户增长时保持快速可靠,核心是按设计、构建、测试部署、运维四个阶段进行扩展:先设定延迟与峰值负载目标,将重负载交给专门服务,应用只负责 UI 和协调;采用异步代码,将会话状态分为可重建的软状态和持久化的硬状态;通过负载测试和遥测数据决定纵向扩容(更大实例)还是横向扩容(更多实例),而非盲目增加算力。
Databricks提供三种数据与AI资产共享方式,选择取决于与对方的关系:OpenSharing最简单,适合已知接收方,授予只读实时访问,无需建管道;Clean Rooms是封闭协作空间,多方在不暴露原始数据的前提下联合分析,仅见双方批准代码的结果;Marketplace是公开商店,适合无特定接收方、希望被发现或自行发现数据产品的场景。三者可并用。
Apache Spark 4.3 发布,核心是将有状态处理引入实时模式,三项基准测试的 P99 端到端延迟均低于 150 毫秒,支持流聚合、去重和 transformWithState。新增并发阶段调度与流水线 shuffle,实现持续数据流。还推出小数据单任务免 shuffle 执行、Auto CDC 的 SCD Type 2 历史追踪、Spark Connect 会话与操作可见性、DataFrame.zip、纳秒时间戳预览、JSON_TABLE 及 ASOF JOIN 等。发布节奏改为每季度一次。
企业AI策略正从依赖单一前沿模型转向多模型组合,原因包括成本回报不足、模型排名频繁变化、前沿模型护栏阻碍合法任务、数据保留政策变动、治理需求上升、模型运行框架影响性能,以及开源权重模型已追平前沿模型。Databricks的Unity AI Gateway统一接入开源与前沿模型,提供集中治理、路由和成本控制;Omnigent则让团队灵活更换模型或代理环境。客户使用的模型数量和开源模型流量均在增长。
Databricks MLflow 现已支持原生接收 Claude 平台的 OpenTelemetry 追踪数据,开发者可将 Anthropic SDK、Messages API 及托管代理的追踪发送至 Databricks,用于调试代理并评估改动。追踪数据经 Zerobus 低延迟写入 Unity Catalog 表,兼顾高吞吐与数据治理。借助 Genie Code 可分析失败原因,MLflow Issues 能识别重复问题并持续监控,评审队列可引入领域专家反馈,Agent Evaluation 则对比改动前后的表现,判断代理是否改进或退化。
Databricks 为 Unity Catalog Delta 表推出 UNIQUE 约束(公开预览),支持单表声明多个唯一性保证,列可为空,外键也可引用。约束默认仅记录元数据、不强制写入;验证数据后可用 RELY 标记,让优化器消除冗余连接和 DISTINCT 聚合。基准测试中连接查询提速 7.9 倍,DISTINCT 查询提速 12 倍。
Databricks宣布Lakebase Postgres在Google Cloud正式可用,可在Databricks数据与AI平台运行生产级无服务器Postgres。其架构分离计算与存储,与分析数据共享存储层,无需ETL管道,统一安全治理,降低运维与总成本,支撑AI代理和关键业务负载。
SAP与Databricks深化合作,在SAP TechEd上推出SAP Application Data Foundation,使SAP Databricks能更简便高效地访问云端及本地SAP应用数据,无需自建抽取管道,降低成本并保留业务语义。双方计划将Databricks完整的数据与AI能力嵌入SAP Business Data Cloud。SAF-Holland借此整合超1亿条记录,分析速度提升5倍。
Databricks宣布Spark声明式管道(SDP)的实时模式(RTM)正式可用。RTM采用持续流式处理,端到端延迟达毫秒级,比Flink快至92%。用户可在SDP中构建欺诈检测、实时个性化、特征计算等低延迟管道,并通过ForEach sink写入Lakebase、Redis等OLTP存储。该功能统一了流处理框架,减少运维开销,无需单独维护Flink等引擎。
Databricks为笔记本、作业和管道的无服务器计算引入成本控制,将管理重心从机器转向人员和工作负载。三项功能——标签归因(Beta)、访问控制(正式可用)和速率限制(Beta)——帮助平台团队控制谁可运行、花费多少及成本归属。
Procore Analytics 2.0 基于 Databricks 与 OpenSharing 重构数据架构,取代旧版每日限次刷新的 API 抽取模式。新架构采用青铜、白银、黄金三层数据管道,跨区域处理,并通过 OpenSharing 向客户分发数百张治理良好的数据表,支持 Power BI、Tableau 及 Databricks 原生共享,并按用户和项目自动执行权限控制。可提取数据目录规模翻倍,构建时间减半,刷新频率不再受限,新功能数据几乎即时可用。
Procore Analytics 2.0 采用 Databricks 与 OpenSharing 重构数据架构,取代受限于每日刷新和 API 瓶颈的旧版。新架构通过分层数据管道和 OpenSharing 向客户共享数百张治理良好的数据表,支持跨云、跨平台消费,并实现按用户和项目的权限控制。数据目录规模翻倍、构建时间减半,刷新频率不再受限,新产品数据可更快交付客户。
Databricks提出企业AI应转向客户对话场景。语音智能体需结合受治理的数据、业务本体和快速决策模型,实时理解来电者身份与上下文,在规则内提供个性化服务,必要时转接人工。其架构分为对话层与运行于Databricks平台的“大脑”层,确保数据安全合规。每次通话可记录、评分并持续优化。建议从高频常规通话入手,用开源DIVA蓝图开展90天试点。
Databricks推出编码智能体Genie Code,结合Unity Catalog实现数据治理与安全。针对医疗与生命科学领域专业性不足的问题,推出开源Vital Skills技能包,为AI编码代理提供行业知识与标准流程。在BiomniBench基准测试中,带技能的Genie Code表现更优,能可靠完成队列构建、模型部署等任务,减少错误假设,助力团队高效完成数据分析与报告。
本文介绍从BigQuery分阶段迁移到Databricks湖仓的框架,涵盖流程、技术与人员三大支柱:流程上先评估现有资产,按价值与复杂度分批迁移,通过湖仓联邦双轨验证后及时下线旧系统;技术上数据转为开放格式,SQL分层转换并严格校验;人员上打破分析师与数据科学家壁垒,借助Genie和培训提升技能。
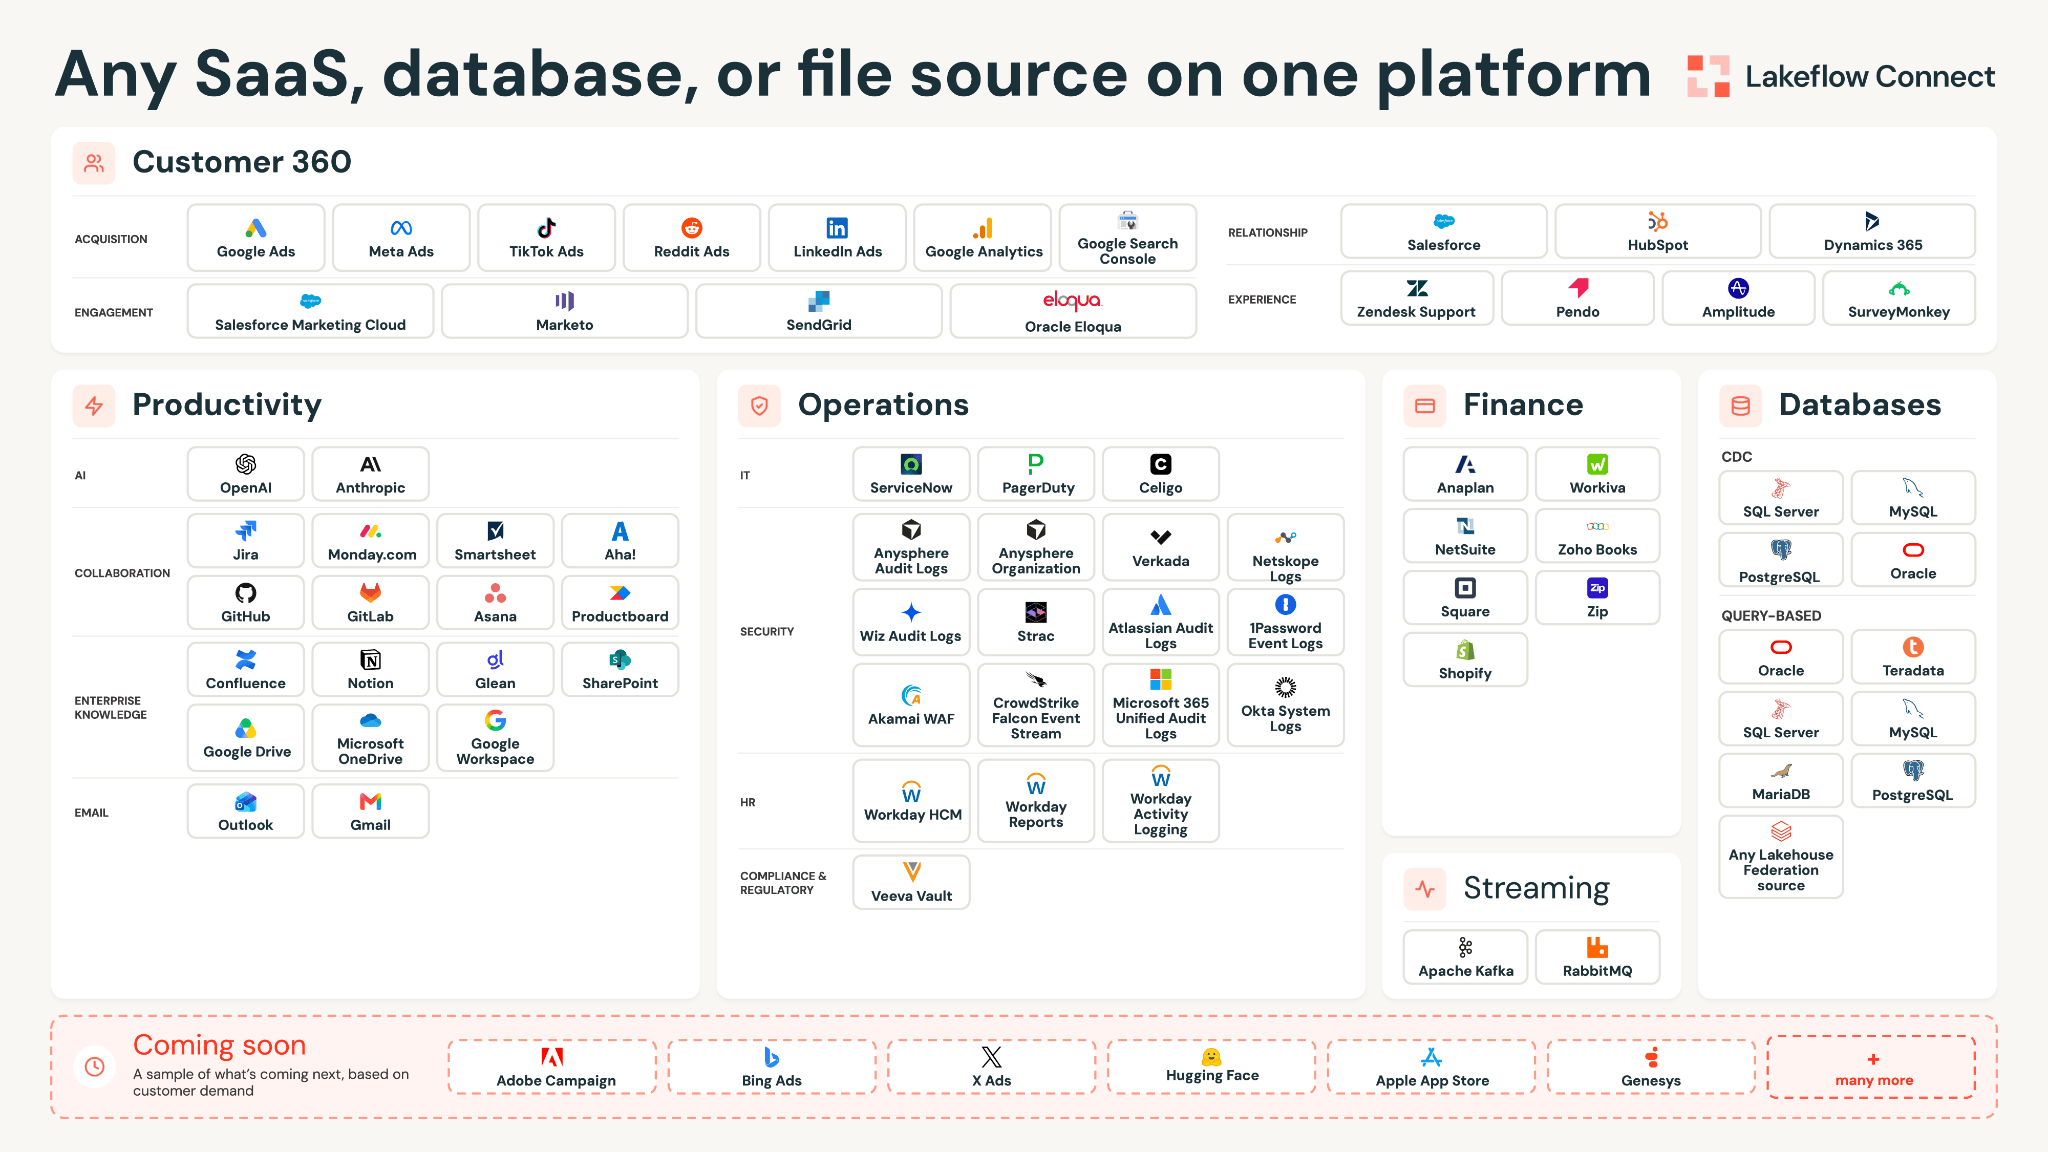
Lakeflow Connect 提供全托管原生连接器,可将维基、项目管理、邮件、代码库及 AI 模型等生产力工具的数据统一接入 Databricks,并以 Unity Catalog 治理表的形式落地,无需自建管道。它支持非结构化内容处理,可用于构建企业知识 AI 代理、Genie 自然语言分析及 AI 用量监控。丰田金融、VaxCare、DigiCert、Orizon 等客户已将其用于 Jira、Confluence 等数据集成。
Databricks推出永久免费的Free Edition,供师生在浏览器中使用真实生产平台学习数据与AI,无需付费、云合同或安装。学生可实操Spark、SQL、建模等,技能可直接迁移;教师可通过LMS或GitHub分发作业,支持协作与大数据集共享。平台按公平使用限额运行,额度每日重置,适合教学但不可商用。
AI Search 原生支持流表、物化视图和 Iceberg v3+ 托管表,无需再建中间 Delta 表及同步管道。流表可实时索引新数据,支持新品发现与实时推荐;物化视图增量维护个性化状态,实现会话感知推荐;Iceberg 表可直接作为搜索源,免迁移统一跨系统数据。建索引流程与 Delta 表一致,降低运维开销。
Databricks提出统一能源交易平台方案:通过Spark结构化流将市场数据毫秒级实时写入Lakebase运营数据库,支撑实时交易应用展示价格、持仓、盈亏与风险,并在接近限额时即时预警;同一份受Unity Catalog治理的数据同时用于机器学习训练与部署、历史分析与自然语言查询,避免运营与分析双系统导致的数据不同步、治理重复和模型交接复杂等问题。
完成下面两步后,将自动完成登录并继续当前操作。