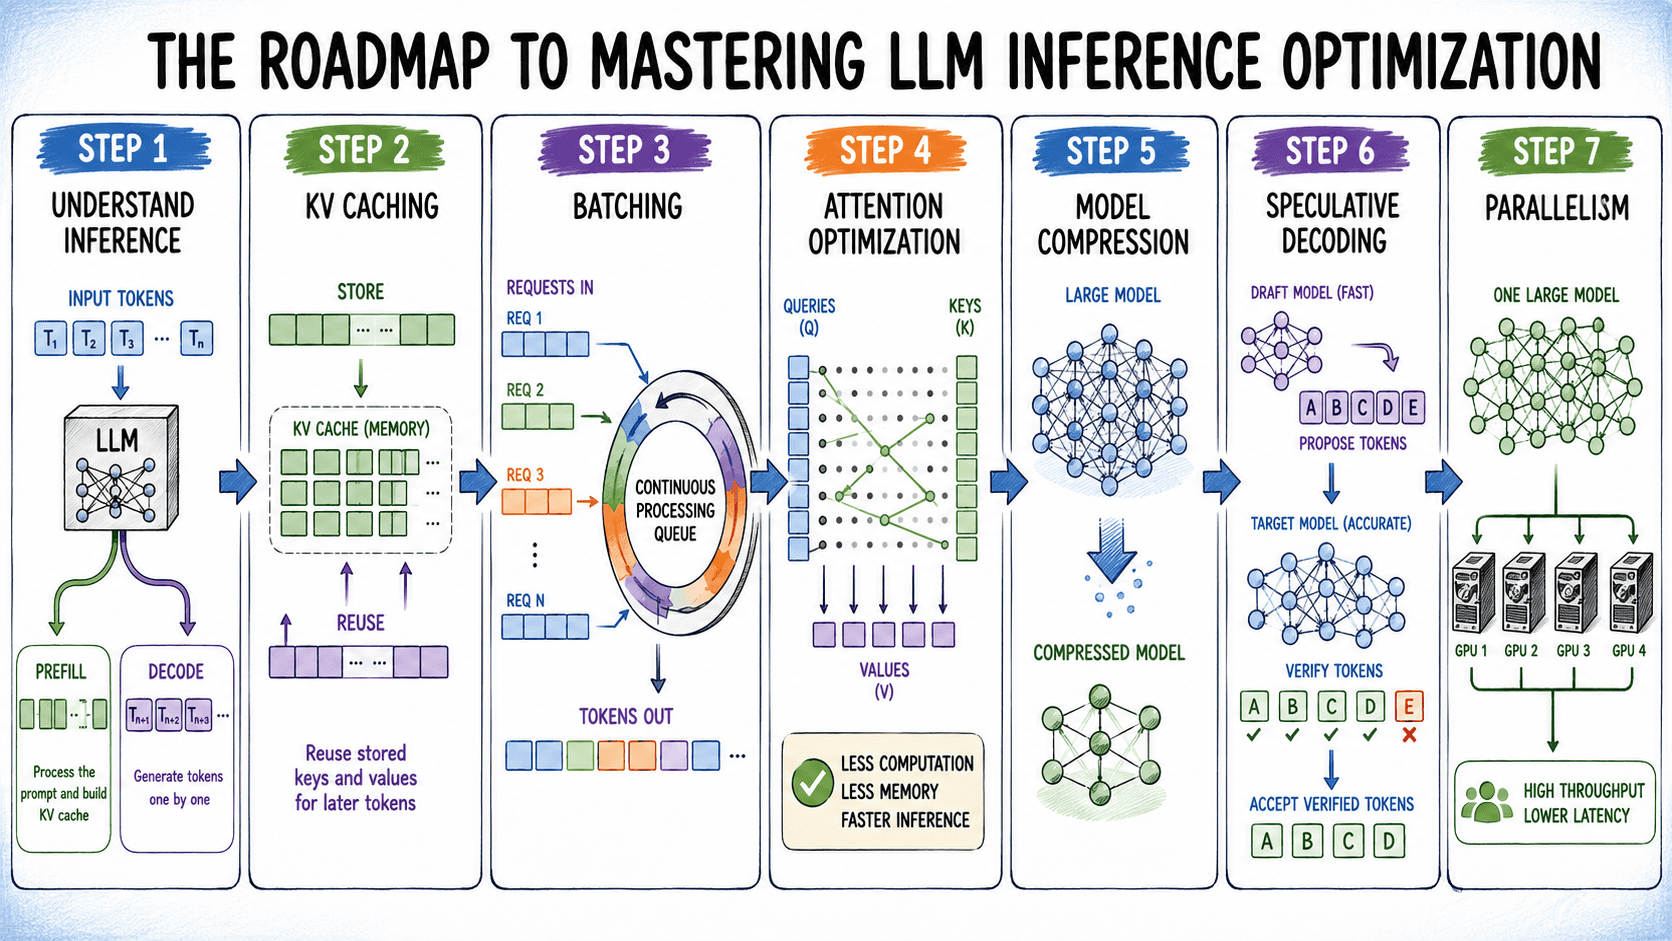

掌握大语言模型推理优化的路线图
内容提要
本文介绍大语言模型推理优化路线图。推理分为预填充(计算密集)和解码(显存带宽受限)两阶段。优化手段包括:KV缓存、PagedAttention与前缀缓存管理显存;连续批处理提升GPU利用率;MQA、GQA、FlashAttention优化注意力;量化、稀疏化、知识蒸馏压缩模型;投机解码降低延迟;张量并行、流水线并行及预填充-解码分离实现多GPU扩展。
延伸解读
预填充与解码:瓶颈不同,优化策略各异
文章指出,LLM推理分为预填充和解码两阶段。预填充阶段并行处理所有输入token,计算密集,决定首token延迟(TTFT);解码阶段自回归生成,显存带宽受限,影响生成速度(TPS)。优化时需明确目标:若关注TTFT,应优化预填充;若关注TPS,则需针对解码。混淆两者可能导致优化无效。
KV缓存与PagedAttention:显存管理的关键
KV缓存通过存储键值张量避免重复计算,但显存占用随批大小和序列长度增长,成为并发瓶颈。PagedAttention借鉴操作系统分页,将KV缓存分块非连续分配,减少碎片,提升批大小和吞吐。前缀缓存则复用共享前缀的KV,适用于RAG等场景。这些技术共同缓解显存压力,但需注意其适用条件。
连续批处理:提升GPU利用率的调度策略
静态批处理因输出长度差异导致GPU空闲,动态批处理通过超时平衡延迟与吞吐,但请求仍同步推进。连续批处理(如vLLM采用)在序列完成时立即替换新请求,保持GPU高利用率,尤其适合输出长度多变的生产环境。选择批处理策略时,需权衡延迟目标与吞吐需求。
模型压缩与投机解码:降低延迟与成本
量化(如GPTQ、AWQ)将权重降至4位,大幅减少显存占用,使大模型能在更低硬件 tier 运行;稀疏化利用2:4结构化稀疏获得加速;知识蒸馏训练小模型模仿大模型。投机解码用小模型草稿、大模型并行验证,保证输出不变的同时降低延迟,尤其适合交互式场景。这些技术可组合使用,但需评估精度损失。
Q&A
大语言模型推理的预填充和解码阶段有什么本质区别?
预填充阶段同时处理所有输入token,计算密集,决定首token延迟;解码阶段自回归逐个生成token,显存带宽受限,决定生成速度。
KV缓存为什么会导致显存问题?PagedAttention如何解决?
KV缓存显存需求随批大小和序列长度增长,且预分配最大长度会造成内部碎片。PagedAttention将KV缓存分成固定大小的块,按需非连续分配,减少显存浪费,支持更大批处理。
连续批处理相比静态批处理有什么优势?
连续批处理在序列生成完成后立即替换新请求,无需等待整批完成,能保持高GPU利用率,尤其适合输出长度变化大的场景。
MQA、GQA和FlashAttention分别如何优化注意力机制?
MQA让所有查询头共享一组键值头,减少显存传输;GQA分组共享,平衡内存和精度;FlashAttention通过分块和融合操作减少显存读写,不改变数学结果。
模型压缩有哪些主要方法?它们如何降低推理成本?
量化降低数值精度(如FP16到INT4),减少显存占用;稀疏化利用结构化稀疏加速计算;知识蒸馏训练小模型模仿大模型,降低延迟。
投机解码如何在不影响输出正确性的前提下加速推理?
使用小模型生成候选token序列,大模型并行验证,接受匹配的token,拒绝不匹配的,保证输出与原始模型一致,从而减少大模型调用次数。
多GPU并行有哪些策略?各自适用什么场景?
张量并行拆分层内计算,降低单卡显存;流水线并行按层拆分,适合超大模型;预填充-解码分离将两阶段分配到不同硬件,避免相互阻塞。
