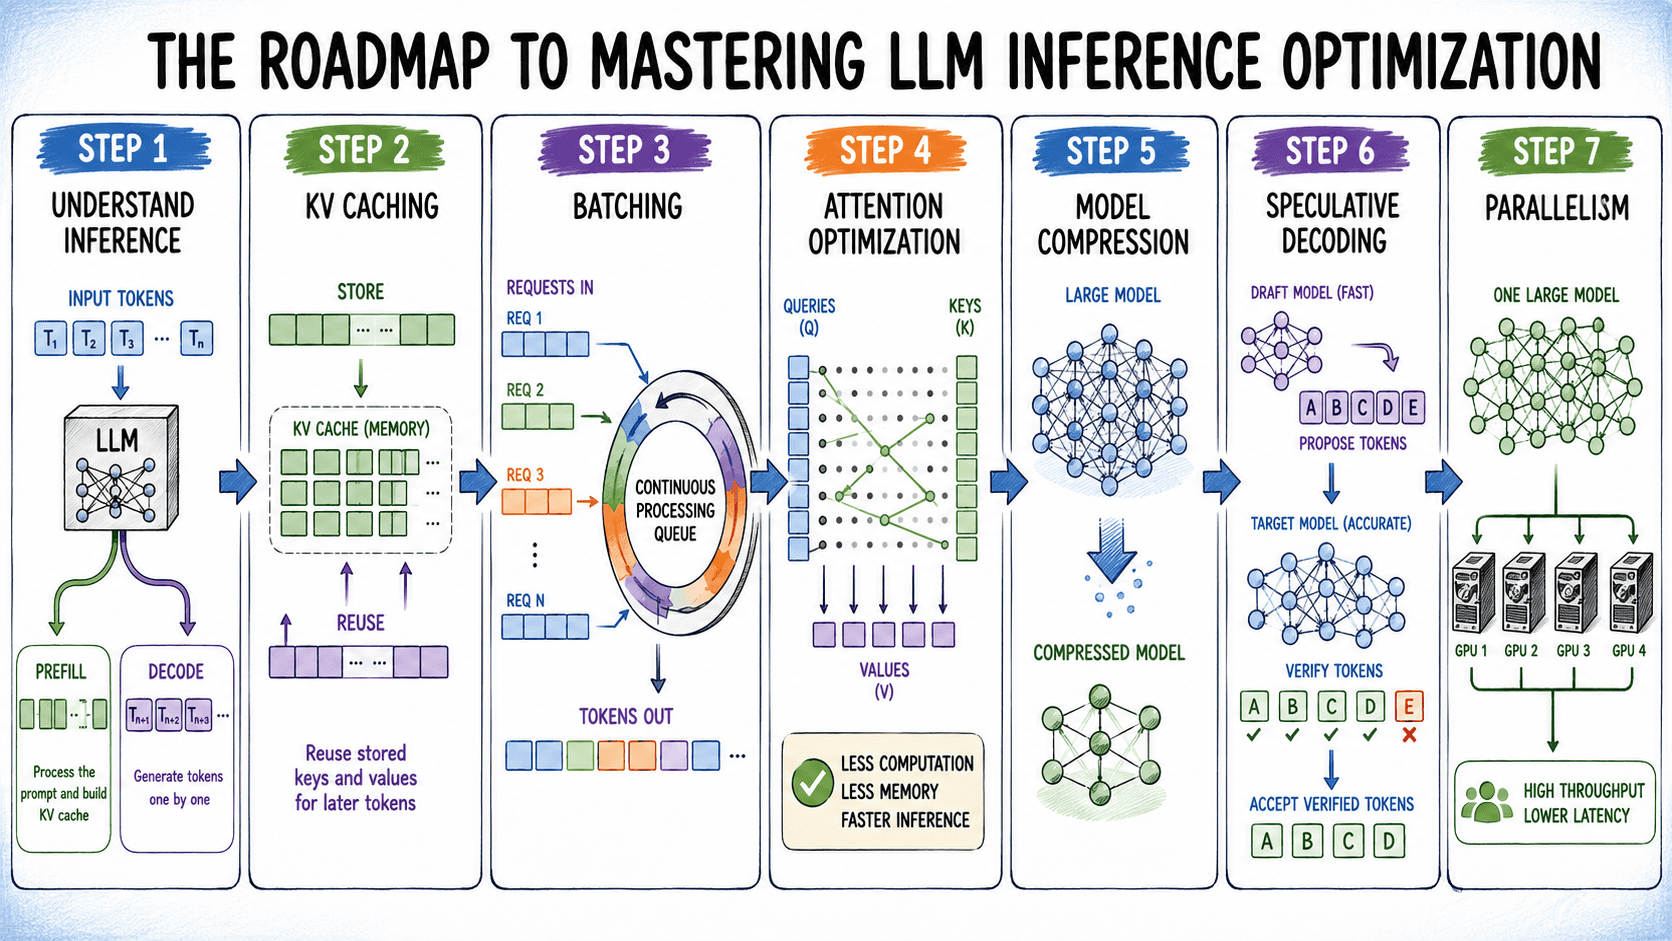
本文介绍大语言模型推理优化路线图。推理分为预填充(计算密集)和解码(显存带宽受限)两阶段。优化手段包括:KV缓存、PagedAttention与前缀缓存管理显存;连续批处理提升GPU利用率;MQA、GQA、FlashAttention优化注意力;量化、稀疏化、知识蒸馏压缩模型;投机解码降低延迟;张量并行、流水线并行及预填充-解码分离实现多GPU扩展。
该文汇总多项大语言模型优化研究:用量子Grover算法加速稀疏注意力并获多项式加速;以零阶算法优化softmax;用差分隐私保护注意力矩阵;改进前向梯度学习以降低方差,并在多个数据集上媲美反向传播;提出ScaleGrad缓解重复短语;研究双层优化与近似隐式微分;用局部辅助网络改进前向梯度;基准测试LLM预训练、微调与推理性能;分析注意力结构与Hessian近似最优解;证明线性自注意力Transformer可模拟线性回归梯度下降。
该文综述多种大语言模型推理加速方法,包括Medusa(通过额外解码头并行预测多标记,提速2.2至3.6倍)、级联投机解码、多候选验证、HydraSum多解码器、分块并行解码、自推测解码及Hydragen共享前缀注意力等,分别从草稿模型、并行验证和注意力计算等角度减少解码步骤,提升吞吐量。
本文综述了多种提升Transformer效率的方法:Hyena用长卷积替代注意力以降低训练成本;快速权重编程器增强线性注意力;CoT利用上下文优化注意力;轻量注意力加速翻译;实时分割网络动态生成解码器权重;斑马模型通过局部-全局注意力降低复杂度;SCL自动剪枝优化稀疏性。
完成下面两步后,将自动完成登录并继续当前操作。