


消息队列
内容提要
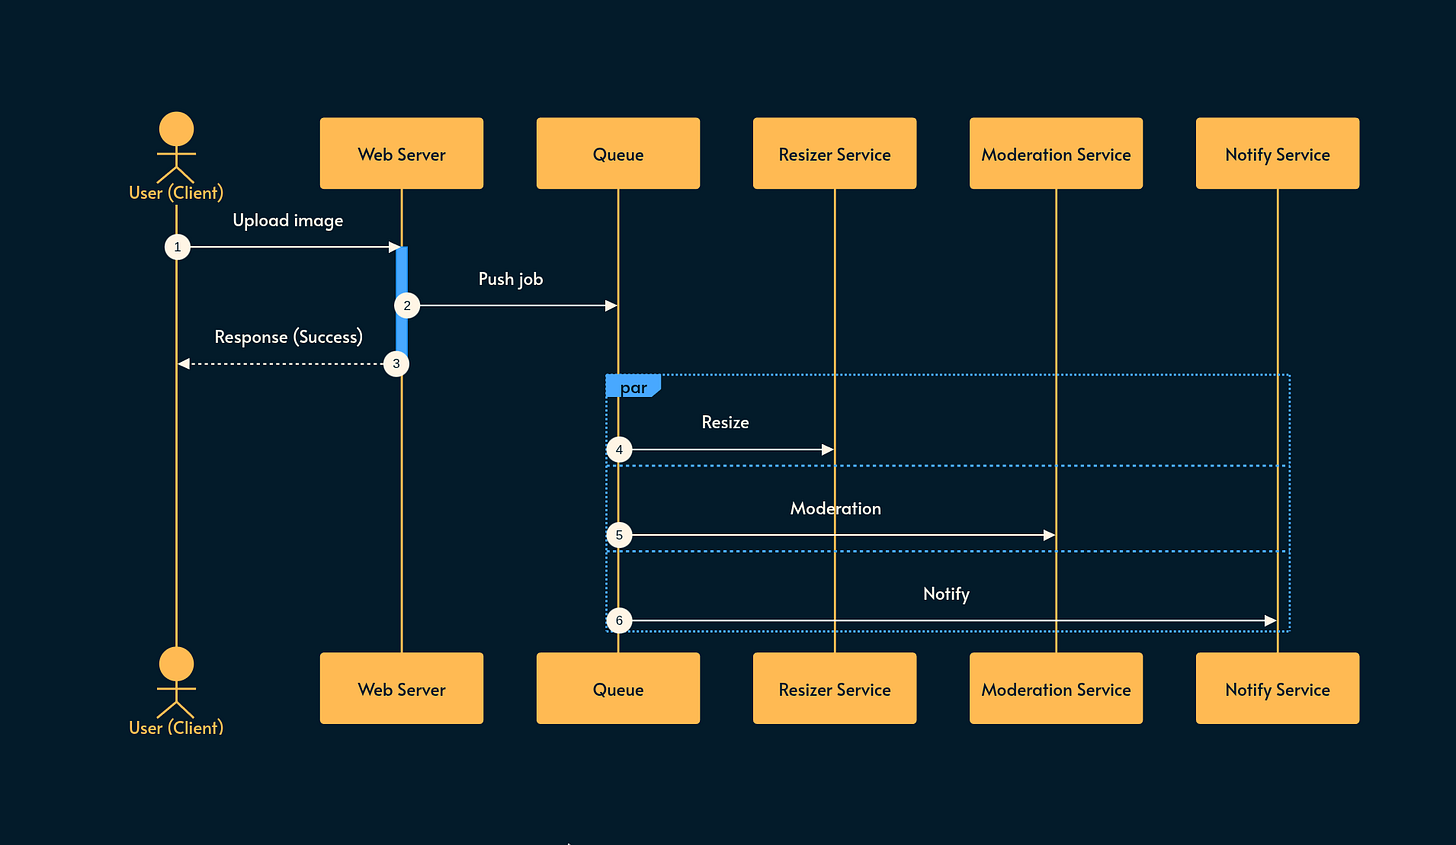
消息队列是解耦生产者与消费者的缓冲机制,支持异步处理、削峰填谷、故障隔离与独立扩展。核心机制包括确认(ACK)、防重复处理和投递保证(至少一次、至多一次、精确一次)。使用时需关注分区与顺序、背压、死信队列和持久化。Kafka适合高吞吐与重放,SQS为简单托管服务,RabbitMQ擅长复杂路由。
延伸解读
队列引入的延迟代价
文章明确指出,在延迟敏感的同步工作负载中引入队列几乎必然破坏延迟要求(如低于500毫秒)。队列适用于可以“稍后”处理的工作,即使“稍后”只是几秒钟。因此,在决定使用队列前,必须评估业务是否真的能容忍异步延迟,避免为了解耦而牺牲用户体验。
分区键的权衡:顺序与均匀
分区键的选择至关重要:相同的键保证消息顺序,但可能造成热点分区。例如,按城市分区会导致大城市过载而小城市闲置。文章建议选择能均匀分布负载的键(如用户ID或行程ID),但需在严格顺序和均匀分布之间做出权衡,这类似于数据库分片键的选择。
投递保证的实践选择
三种投递保证中,至少一次是SQS、RabbitMQ和Kafka的默认行为,适用于幂等操作;至多一次可能丢失数据,仅用于可容忍丢失的场景;精确一次难以实现,通常通过至少一次投递加幂等消费者(如去重键或数据库事务)来模拟。金融扣款等非幂等操作必须谨慎设计,避免重复处理。
队列产品的适用场景
Kafka适合高吞吐、持久化、事件流和重放场景,通过分区和消费者组扩展;SQS是AWS托管服务,标准队列追求最大吞吐但可能乱序和重复,FIFO队列保证顺序和精确一次但吞吐较低;RabbitMQ擅长复杂路由,适用于传统消息代理设置。选择时应根据吞吐、顺序、路由复杂度和运维成本权衡。
Q&A
消息队列为什么能提升系统可靠性?
消息队列通过解耦生产者和消费者,实现故障隔离:如果消费者处理失败,消息会被重新投递给其他消费者,避免整个操作失败。同时,队列缓冲流量峰值,防止系统过载,并支持独立扩展消费者。
消息队列的ACK机制是如何工作的?
消费者从队列取出消息后,队列不会立即删除消息,而是等待消费者显式发送ACK确认处理完成。如果消费者在发送ACK前崩溃,队列会认为消息未被处理,并将其重新投递给另一个消费者。
至少一次、至多一次和精确一次投递保证有什么区别?
至少一次:消息保证到达但可能重复处理,适用于幂等操作;至多一次:消息不会重复但可能丢失,适用于可容忍少量数据丢失的场景;精确一次:消息恰好处理一次,实现难度大,通常通过至少一次投递加幂等消费者实现。
什么情况下不适合使用消息队列?
对延迟敏感的同步工作负载(如要求亚500毫秒响应)不适合引入队列,因为队列会引入额外延迟,很可能破坏延迟要求。队列适用于可以稍后处理的工作。
如何避免消息队列出现积压或内存耗尽?
可以通过自动扩展(根据队列长度增加消费者或分区)、背压(拒绝新消息或让客户端重试)以及监控队列深度并设置告警来防止积压导致的内存耗尽。
死信队列(DLQ)的作用是什么?
死信队列用于存放多次处理失败的消息(毒消息),避免无限重试浪费资源。设置最大重试次数后,失败消息转入DLQ,供后续调查分析,并应配置告警以便及时发现。
Kafka、SQS和RabbitMQ分别适合什么场景?
Kafka适合高吞吐、持久化、事件流和消息重放;SQS是AWS托管服务,简单易用,标准队列追求最大吞吐,FIFO队列保证顺序和精确一次;RabbitMQ适合需要复杂路由逻辑的传统消息代理场景。
