


低延迟视频流到底如何工作,代价是什么
内容提要
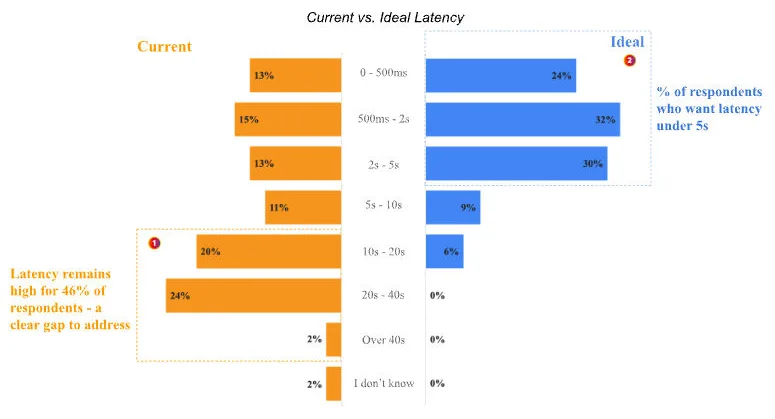
低延迟并非某种传输协议的固有属性,而是采集、编码、复用、传输、解码各环节延迟之和。SVTA 2025调查显示,仅28%受访者延迟低于2秒,86%期望在5秒以内。前瞻、B帧、音视频同步、输出缓冲及OTT分片都会增加延迟,压缩缓冲必然牺牲压缩效率或稳定性。Elecard在封闭球场项目中实现约1秒LL-DASH延迟,但公网大规模场景难以复制。看到“200ms”宣传时,应追问测量端点、网络条件及所付代价。
延伸解读
延迟是链路总和,而非协议标签
文章强调,低延迟并非某种传输协议的固有属性,而是采集、编码、复用、传输、解码各环节延迟的累加。即使传输协议本身很快,编码前瞻、B帧等待、音视频同步缓冲等环节也可能消耗数百毫秒甚至数秒。因此,看到“低延迟协议”宣传时,应关注整个链路的缓冲配置,而非仅盯传输环节。
压缩效率与延迟的取舍不可避免
编码前瞻和B帧能提升压缩效率,但需要缓存后续帧,直接增加延迟。关闭前瞻或减少B帧可降低延迟,却会导致同码率下画质下降,或需提高码率维持质量。体育赛事等复杂内容最需要这些工具,却对延迟要求最严,矛盾尤为突出。系统设计必须根据场景权衡,而非一味追求毫秒数。
封闭环境与公网大规模场景差异巨大
Elecard在球场项目中实现约1秒LL-DASH延迟,但该系统仅服务最多40台平板,且网络完全可控。若直接用于公网成千上万用户,轻微网络波动便会导致持续缓冲。公网场景需应对设备差异、带宽波动和播放器能力不一,仅缩短分片或削减缓冲并不足够,还需更强的传输稳定机制。
追问测量端点与代价,而非轻信毫秒数字
文章建议,看到“200ms”宣传时,应追问测量取哪两个端点、基于何种网络条件,以及为达到该数值牺牲了什么。实验室环境达标只是成功一半,真实环境中的内容不可预测性和终端多样性才是挑战。脱离具体条件谈低延迟,无法反映系统真实能力,读者应关注端到端实测和稳定性代价。
Q&A
低延迟视频流的总延迟由哪些环节构成?
总延迟是采集、编码、复用、传输、解码等各环节延迟之和,涵盖从原始画面被采集到显示在观众屏幕上的全过程。每个环节都需要一定缓冲时间来完成其功能,削减缓冲必然伴随取舍。
SVTA 2025调查显示的行业延迟现状和理想目标是什么?
调查显示,44%的受访者延迟在10至40秒,24%在2至10秒,仅28%低于2秒;而86%的受访者将理想延迟目标设定在5秒以内。行业当前技术与用户期望仍有较大差距。
编码中的前瞻(Lookahead)和B帧如何增加延迟?
前瞻会缓存后续帧进行分析以优化码率分配,窗口设为50帧、25fps时需缓存2秒视频;B帧需要等待其参考的后续帧到达,例如参考第3帧需等待约120ms。关闭前瞻或减少B帧可降低延迟,但会牺牲压缩效率。
TS复用器为什么会产生延迟?
复用运算本身很快,延迟主要来自音视频等基本流的同步处理。复用器需精细交织数据,确保各路流同时到达接收端且不溢出缓冲。若输入流间时间差较大,需更大缓冲吸收,工程经验建议PTS差值保持在1秒以内。
输出缓冲大小对网络抖动和延迟有什么影响?
关闭输出缓冲时IAT峰值可达200-400ms,增加缓冲至700ms可降至10-20ms,增至1400ms则稳定在3-4ms。缓冲越大码流越平滑,但延迟也相应增加,低延迟场景需找到满足下游要求的最小缓冲。
OTT场景中传统HLS/DASH为什么延迟高?LL-HLS/LL-DASH如何改善?
传统HLS/DASH使用2-10秒的固定分片,播放器预缓存多个分片导致延迟达数十秒。LL-HLS/LL-DASH允许在完整分片生成前传输和播放其中的小块(chunk),从而降低延迟。
Elecard在球场项目中实现的1秒延迟能否复制到公网大规模场景?
不能。该项目面向最多40台平板、完全可控的封闭网络,通过极小播放器缓冲实现约1秒延迟。公网大规模场景中用户设备、带宽和播放器能力各异,网络波动会导致持续缓冲和卡顿,无法保证系统正常工作。
看到“200ms超低延迟”宣传时应该追问什么?
应追问:测量取哪两个端点?基于何种网络条件?最重要的是,为获得这些毫秒究竟牺牲了什么(如压缩效率、稳定性或缓冲余量)。低延迟不是单一协议的固有属性,需结合具体条件和代价评估。
