Cloudflare 开源 9B 多模态决策模型 Clef-Flash,将决策从文本生成改为单次前向传播概率打分,中位延迟仅 38.8 毫秒,兼容 Jev System One API,适用于工单分类、内容审核、发票状态判断等结构化决策场景。
Inception 的 Mercury 3 已上线 AI Gateway,发布期五折。该模型采用扩散方式并行生成文本,速度超过每秒 1000 token,推理能力增强,适合浏览器代理、实时搜索、互动教育、客服等低延迟场景,支持 100 万 token 上下文。可通过 AI SDK 或 Chat Completions 调用,模型名为 inception/mercury-3,也可在 Claude Code、Codex、Cursor 等编码代理中使用。AI Gateway 提供统一 API、用量与成本追踪、重试与故障转移,无加价和平台费。
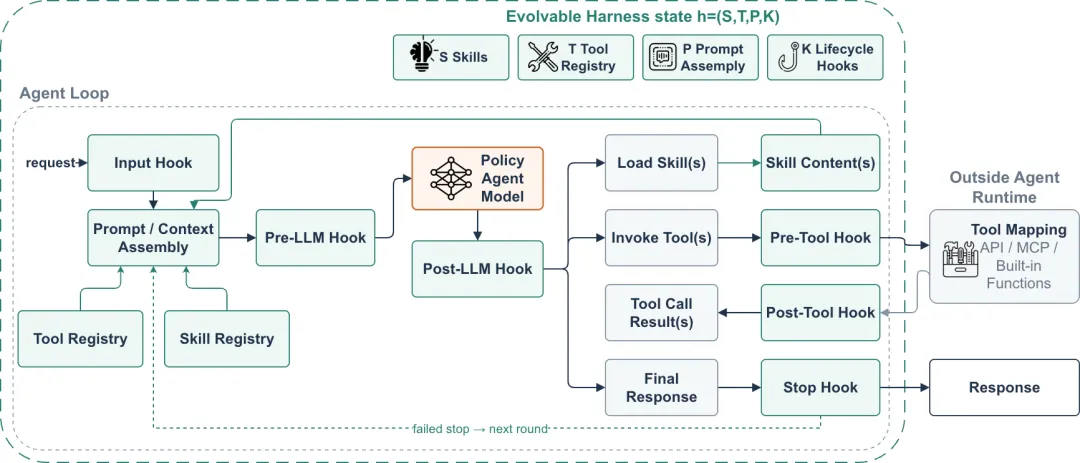
本文提出HAT训练法,用于解决直播数字人Agent在低延迟下适应业务规则频繁变化的问题。该方法将动态执行环境Harness状态纳入训练分布,分三阶段:HSA-SFT提升工具调用能力,通用指令蒸馏恢复通用能力,HSA-RL在仿真环境学习真实交互。基于Qwen3.6-35B-A3B的模型在直播问答达94.8分,超越千亿参数大模型,Harness变化下保持94.6分,端到端延迟P50仅3.407秒,已落地淘宝直播数字人业务。
G1 GC 是 JDK 9 起的默认低延迟垃圾收集器,替代 CMS。它将堆划分为多个 Region,分代收集,通过 Remembered Set 和写屏障追踪跨代引用。核心流程包括 Young GC、并发标记、Mixed GC 和 Full GC。主要调优参数有 MaxGCPauseMillis、InitiatingHeapOccupancyPercent 等,适合大堆、低延迟场景。
Cloudflare推出Workers KV Instant,基于内部Quicksilver存储实现全球即时复制。读取延迟比经典KV快100倍,p99低于2毫秒,写入复制快20倍。API与Workers KV相同,但不支持元数据和分页。读取费用低60%,存储和写入较贵,适合低频更新、高频读取的配置数据。目前处于私有测试阶段。
Inworld推出对话式文本转语音模型TTS-2,支持开发者用自然语言控制语气、停顿和笑声,并可克隆语音、跨语言使用。实时版TTS-2 Flash首字节响应仅25毫秒,适合高并发低延迟场景。Talkpal测试显示功能使用率提升7%、留存提高4%、成本降低40%。语音模型更新无需重构应用,可按需路由请求。
OpenJev Verdict 2.0 是开源非自回归决策引擎,基于 151M 参数的 ModernBERT-base,单次前向传播即可完成语义判断,延迟 20-25 毫秒,选项翻转率 4.76%,校准误差 1.44%。它用类型化原语替代生成式 LLM 进行路由分类,无需 JSON 解析,准确率 77.10%,超越参数量 2.8 倍的竞品,并可在消费级 GPU 训练及浏览器本地运行。
小米发布MiMo V2.6系列AI Gateway,包含Pro、Flash、Pro UltraSpeed三款模型。该系列融合编程、推理与工具调用能力,支持文本、图像、音频、视频理解,上下文长度达100万token,输出最高128K。Pro为1.02T参数稀疏MoE,适合复杂工程;Flash为309B参数,效率更高;UltraSpeed输出速度达Pro的20倍,适合低延迟场景。
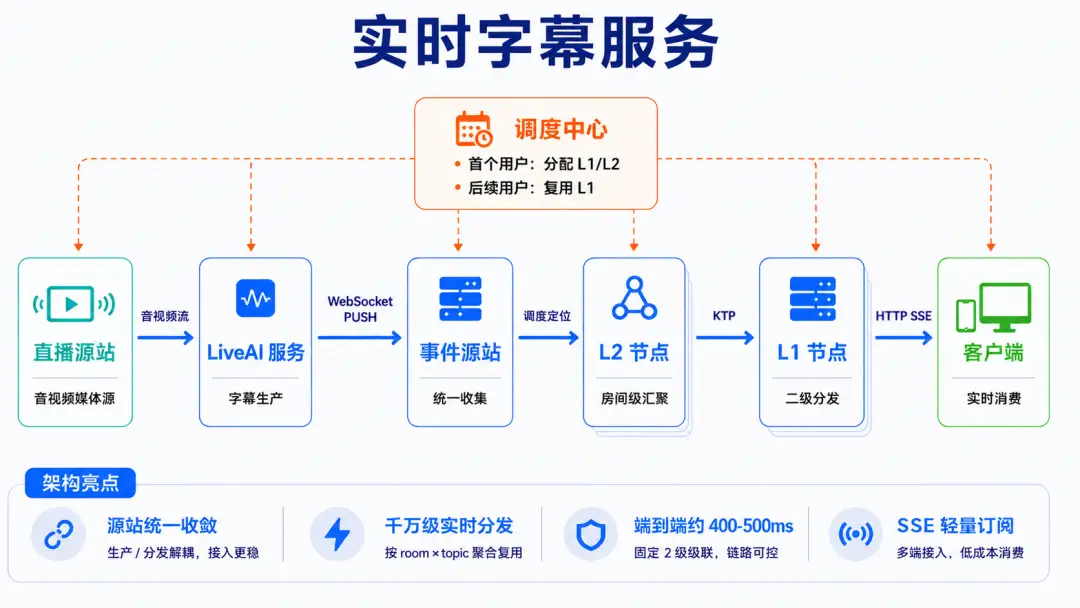
快手电商直播团队构建了业界首个大规模实时字幕系统,通过统一媒体PTS时间线、源站单份生产、两级级联分发和客户端版本化渲染,将端到端延迟从2秒降至500毫秒,字错率从7.81%降至3.51%,支撑千万级并发,并沉淀出可复用的实时AI工程范式。
实时浏览器应用需在100毫秒内完成响应,依赖网络、服务器与渲染协同。ZEGO RTC通过自研MSDN网络、全球500+节点、Web SDK及信令同步,将传输延迟降至60–70ms,弱网下仍保持稳定,并以监控体系保障体验,实现即时响应。
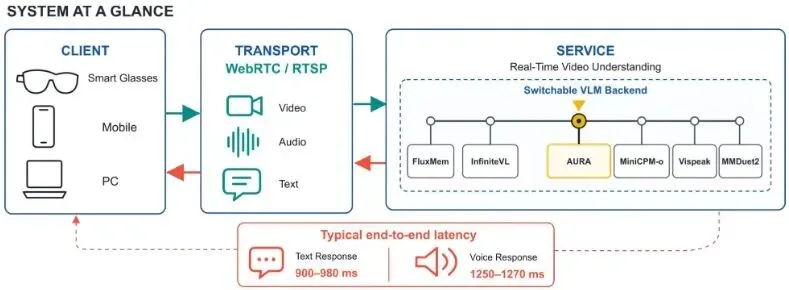
本文提出一套低延迟边云系统,集成六种流式视频VLM后端,共享ASR/TTS与统一编排,支持实时语音交互。实验显示,在合适后端与WebRTC传输下,首句VLM文本延迟约0.9–1.0秒,首段TTS音频约1.3–1.5秒。研究表明实时视频理解是分层系统问题,VLM到TTS交接尤为关键,低首token延迟并不保证快速语音响应。
随航功能在WWDC26迎来史诗级更新,支持iPad触控屏操控macOS。文章从技术层面解析其流畅体验:通过HEVC编码压缩画面,利用帧内预测、帧间预测及残差技术减少数据量,结合虚拟屏幕渲染、编码、传输、解码流程,实现低延迟无线传输。
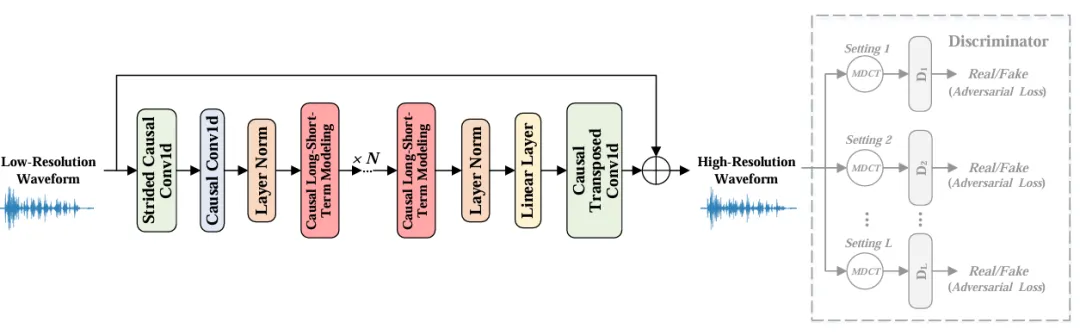
中科大团队提出StreamWSR模型,用于语音超分辨率。该模型采用全因果波形域架构,实现零前瞻流式推理,在低延迟下重建高质量语音。实验显示,其性能与现有方法相当,但计算量更低(2.12G FLOPs),且支持实时处理,适合通信和助听设备等场景。
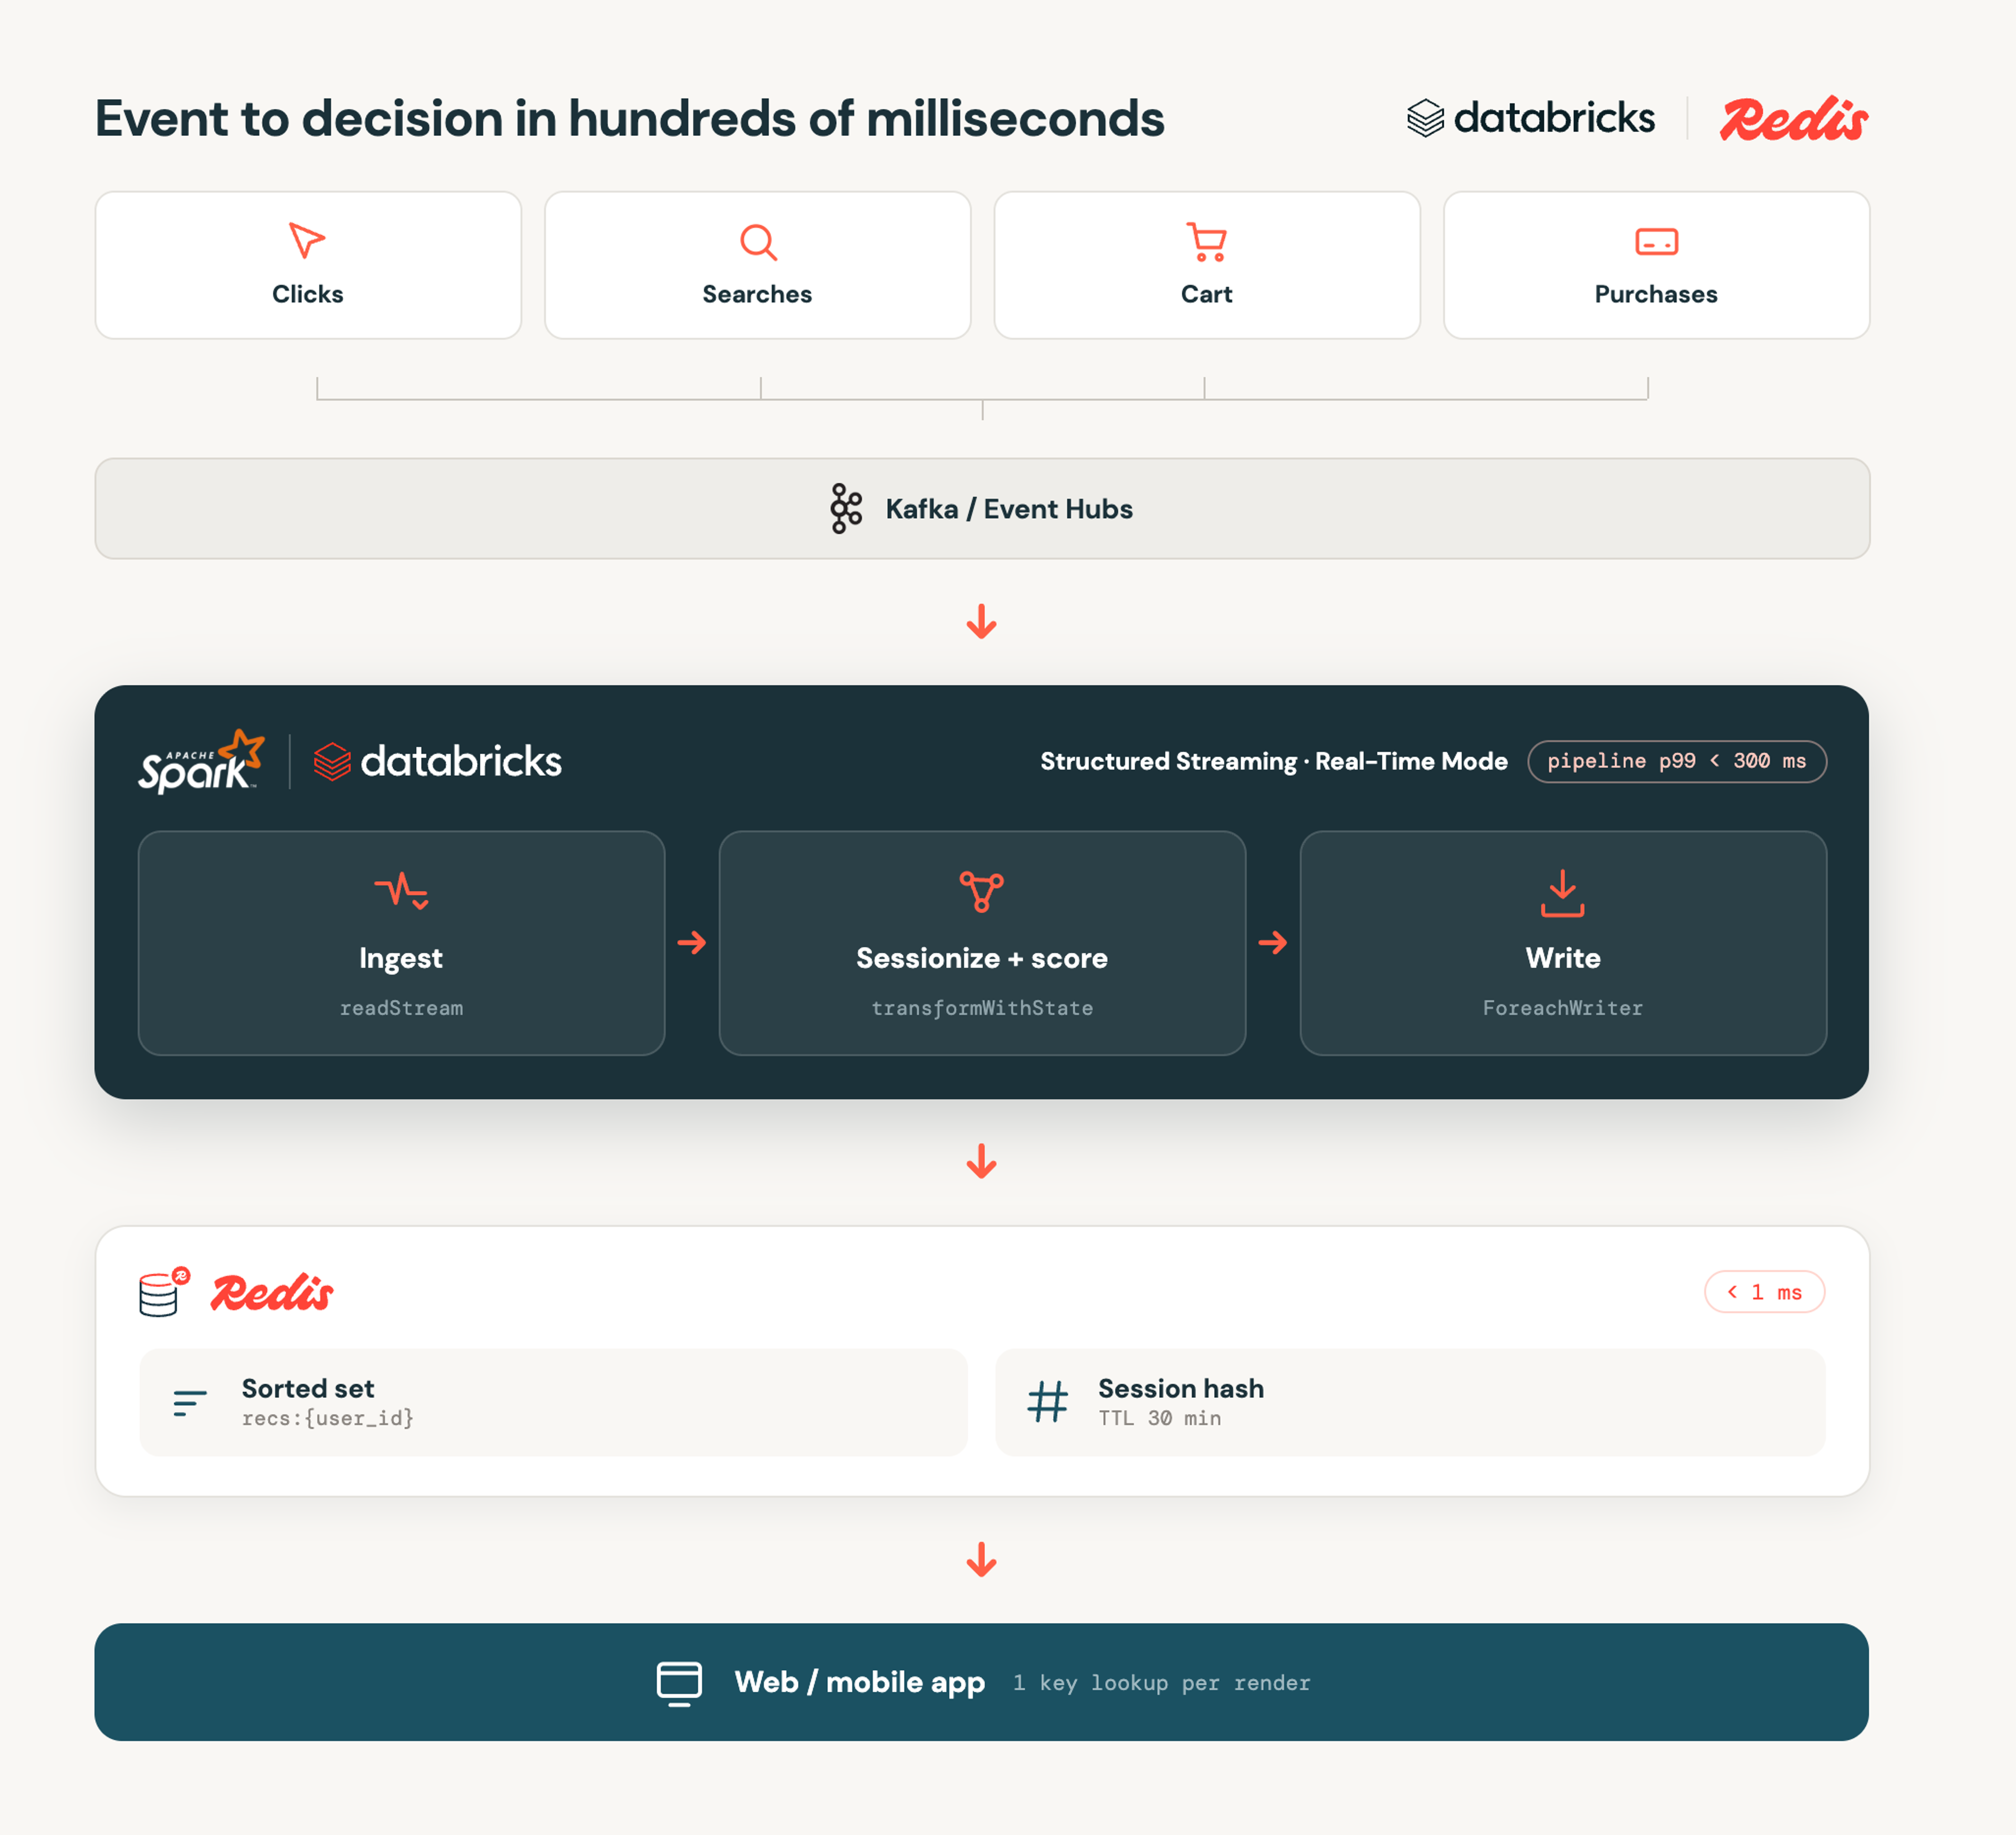
本文介绍Redis与Databricks Real-Time Mode结合,实现实时个性化推荐。RTM连续处理点击流事件,计算用户状态和产品评分,Redis作为毫秒级服务层存储结果。实测支持每秒10万事件,p99延迟低于160毫秒,适用于电商等场景,无需额外流处理引擎。
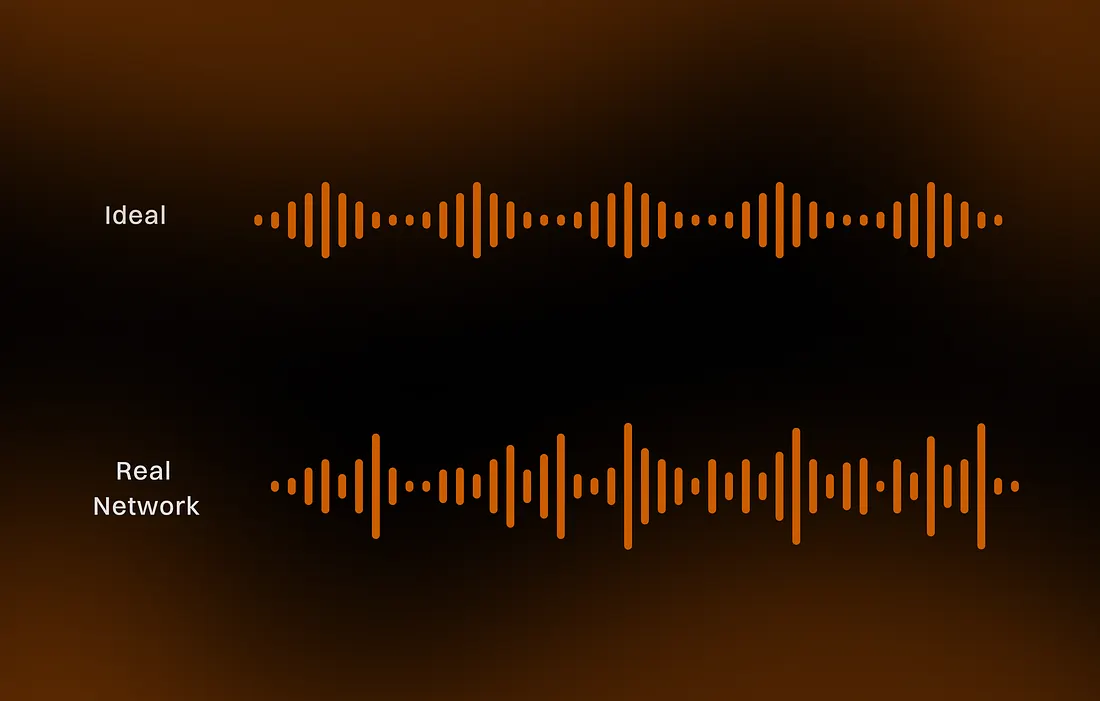
RTP抖动是互联网语音通话卡顿、断续的主因,因音频无法重传。语音AI对抖动更敏感,因延迟会叠加至ASR、LLM等环节。解决需八层协同:静态/自适应抖动缓冲、数据包重排、丢包隐藏、前向纠错、时间戳同步、QoS及智能路由。权衡在于降抖动与降延迟矛盾,语音AI偏向低延迟以保对话自然。
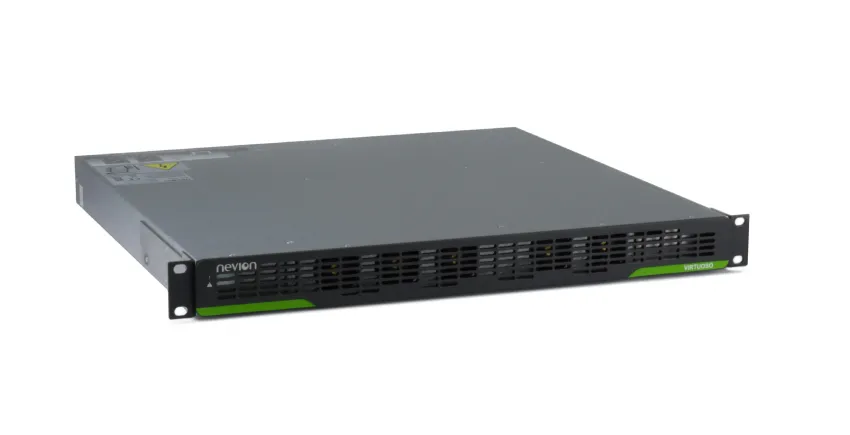
索尼旗下Nevion升级Virtuoso软件定义媒体节点,优化HEVC/H.265传输,新增音频压缩以降低带宽,并推出延迟降低约40%的模式,同时开发超低延迟方案。更新还支持自定义Inspect视图,提升监控效率,旨在满足直播制作多样化需求。
谷歌发布Gemini 3.5 Transcribe语音转文本模型,提升实时转写准确率、降低延迟,支持85种语言,自动去除口头语并修正表达,可区分说话者。流式转写延迟低于1秒,错误率低至2.6%。已通过Gemini API公开预览,未来支持Chrome浏览器。
Big Blue Marble将在IBC2026展示Nakolos 5G广播平台,与TREDESS等合作演示5G广播与QUIC(MoQ)无缝切换,实现超低延迟(低于一秒)的一对多分发,无需并行宽带流,支持体育直播等场景。首席创新官强调该技术简化部署,提升灵活性和商业可行性,为广播商提供清晰路径。
WinAirCast是一款面向Windows用户的低延迟音频串流工具,支持AirPlay 2并兼容AirPlay 1,解决了传统软件高延迟和兼容性问题。它提供设备集中管理、悬浮窗、停靠栏、十段EQ及单应用捕获等功能,定价$2.99,提供15天免费试用,旨在让Windows用户轻松连接HomePod等设备。
本文介绍中国出海企业全球视频会议双中心组网方案。利用AWS Direct Connect、DXGW(SiteLink)和Transit Gateway构建骨干,以中国总部和欧洲为双中心,实现就近接入、主备切换和成本优化,解决跨境延迟与合规问题,保障全球视频会议稳定低延迟。
完成下面两步后,将自动完成登录并继续当前操作。