
淘宝直播数字人互动Harness-Aware Training实践:让Agent Model随Harness一起进化
内容提要
本文提出HAT训练法,用于解决直播数字人Agent在低延迟下适应业务规则频繁变化的问题。该方法将动态执行环境Harness状态纳入训练分布,分三阶段:HSA-SFT提升工具调用能力,通用指令蒸馏恢复通用能力,HSA-RL在仿真环境学习真实交互。基于Qwen3.6-35B-A3B的模型在直播问答达94.8分,超越千亿参数大模型,Harness变化下保持94.6分,端到端延迟P50仅3.407秒,已落地淘宝直播数字人业务。
延伸解读
Harness自进化的收益与边界
文章显示,仅通过修改Skills、Hooks等Harness组件,在固定模型权重下,准确性从82.40%提升至92.55%,有效性从87.16%提升至92.75%。但Evolution 3-4阶段的长尾修复引发了跨类别回归,说明规则并非越多越好。当剩余错误为稀疏长尾时,继续添加规则的边际收益可能为负,因此团队设置了早停规则,并强调每次发布必须绑定Harness commit以便回滚。
HAT三阶段如何互补
HAT包含HSA-SFT、General OPD和HSA-RL三个阶段。HSA-SFT在多样化Harness配置下微调,提升工具调用与推理能力;General OPD在通用指令数据上做On-Policy Distillation,恢复领域训练中损失的通用能力;HSA-RL在仿真环境中通过多轮工具调用和失败恢复学习真实交互。消融实验表明,HSA预防泛化退化,OPD修复残余损失,RL需配合HSA才能避免固定环境下的过拟合。
低延迟部署的关键工程
为满足直播低延迟要求,团队在RL阶段对工具调用和回复的CoT长度分别抑制,工具调用CoT从290.6 token压缩到171.2,回复CoT从93.6压缩到37.0。同时采用MTP加速推理,在单张H20上,HAT模型端到端延迟P50为3.407秒、P95为8.114秒,MTP草稿接受率达78%,解码速度271 tokens/s。MTP是低并发优化,并发数1-2时效果显著,4-8时加速比下降。
评测体系的校准与分离
文章构建了超过4500条测评集,并采用Agent-as-a-Judge进行评分。Judge本身是一个Harness Agent,拥有评分规则、商品验证工具和Hooks,经过6轮自进化校准,与人工标注的Accuracy一致率从81.54%提升到90.46%,Effectiveness从63.70%提升到82.2%。团队强调训练reward judge和最终评测judge必须分离,校准集与测试集也必须分开,以保证评测的独立性与可靠性。
Q&A
淘宝直播数字人为什么要用HAT训练法,而不是直接用大模型或固定Harness微调?
直播场景要求低延迟,通用大模型如DeepSeek-V4延迟不可接受;而固定Harness微调的小模型会过拟合当前配置,无法跟随Harness进化。HAT将Harness状态显式纳入训练分布,让轻量模型既能低延迟响应,又能适应业务规则频繁变化。
HAT训练分为哪几个阶段,每个阶段分别解决什么问题?
HAT包含三个阶段:HSA-SFT在多样化Harness配置下监督微调,提升工具调用与推理能力;General OPD在通用指令数据上做On-Policy Distillation,恢复领域训练中损失的通用能力;HSA-RL在增强变化的仿真环境中通过多轮工具调用、失败和恢复轨迹学习真实交互理解。
Harness Evolution是什么,它如何在不重新训练模型的情况下提升Agent表现?
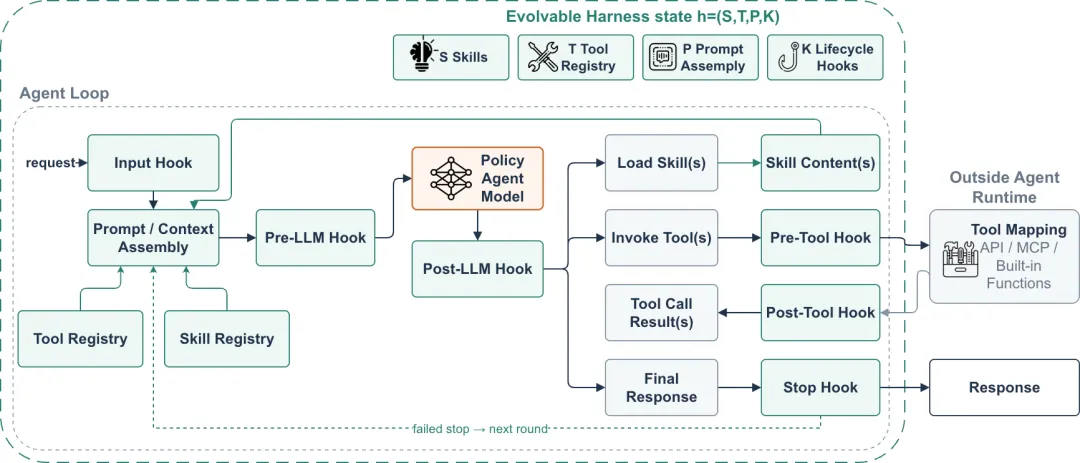
Harness Evolution是在模型权重固定下,通过修改Skills、Prompts、Hooks和Tools来改善Agent表现的人机协同机制。流程为Diagnose→Confirm→Edit Harness→Evaluate→Regression Check五步循环,AI负责诊断和编辑,人负责确认和决策。从Baseline到Evolution 2,准确性从82.40%提升到92.55%,有效性从87.16%提升到92.75%。
HAT模型在直播问答和Harness变化场景下的具体评测分数是多少?
基于Qwen3.6-35B-A3B的HAT模型在Live-Stream QA上达到94.8分,超越千亿参数级通用大模型GLM-5.2的93.0分;在Harness-Variant QA上达到94.6分,与固定场景几乎持平,说明对Harness变化高度鲁棒。同时IFEval Prompt维持在83.5,未出现固定Harness SFT的通用能力下降。
HAT模型在单张H20上的端到端延迟表现如何,MTP加速起了什么作用?
在单张NVIDIA H20、开启MTP的部署测试中,端到端延迟为P50 3.407秒、P95 8.114秒。MTP对HAT checkpoint的加速达1.69倍,高于Base checkpoint的1.11倍,因为垂域训练后投机解码接受率更高(平均0.780 vs 0.735),解码速度达271 tokens/s,且开启MTP后质量无损失。
HAT中的仿真环境是如何构建的,为什么需要故障注入?
仿真环境实现完整Harness Agent控制流,包含输入仿真、Harness Agent调度、工具执行仿真和增强Harness配置四个组件。工具执行在沙盒服务器上返回真实商品信息,同时注入超时、格式错误、权限拒绝等受控故障,让模型在训练中经历错误恢复场景,避免线上遇到工具超时等异常时崩溃。
HAT如何解决固定Harness SFT导致的通用能力下降问题?
固定Harness SFT会导致表层过拟合,如记住Skill名称而非理解语义,并造成IFEval下降7.7分。HAT通过HSA-SFT在多样化Harness下训练预防过拟合,再通过General OPD以基座模型为教师、在Tulu3通用指令数据上做On-Policy Distillation修复残余损失。两者互补:HSA预防损失,OPD修复损失,最终HAT的IFEval反而上升2.0分。
HAT模型在真实Harness进化后适应能力如何,相比固定Harness SFT有何优势?
从线上真实流量抽取1500条数据,在开发集上对Harness进行进化后测试,HAT模型的错误减少率是Fixed-Harness SFT的近3倍。这意味着当通过Harness Evolution修复线上问题时,HAT模型能更好地理解新Harness并随其一同进化,而固定Harness SFT模型表现较差。
