


解释Transformer语言模型的界面
内容提要
本文介绍Transformer语言模型的可视化方法:先用梯度×输入计算输入词对生成词的显著性,并以GPT-2等模型示例展示;再分析前馈网络神经元激活,通过聚类和非负矩阵分解发现不同神经元组分别对应数字、逗号、标签等模式,揭示模型内部机制。
延伸解读
输入显著性:定位影响生成的关键词
文章使用梯度×输入方法计算输入词对生成词的贡献度。例如,在生成莎士比亚出生年份时,名字“William”和“Shakespeare”分别贡献20%和33%,而“year”和“born”也有较高权重。这种方法能直观显示模型依赖哪些输入信息,有助于发现模型是否基于合理线索做出预测,或是否存在偏见。
神经元聚类:揭示模式对应的功能组
对前馈网络神经元激活进行聚类,发现不同神经元组对应不同模式:有的专门响应数字生成,有的响应逗号,还有的跟踪数字递增。这表明模型内部存在功能分化,不同神经元组负责不同语法或语义特征,为理解模型如何组合简单模式提供了线索。
非负矩阵分解:降维提取可解释因子
使用非负矩阵分解(NMF)将神经元激活降维为多个因子,每个因子代表一组协同工作的神经元。例如,两个因子分别对应数字和逗号;增加因子数可细分出序列开头、中间、结尾等模式。NMF比PCA更易解释,因为其成分非负,避免了负值带来的解读困难。
分层与因子分析:洞察模型内部机制
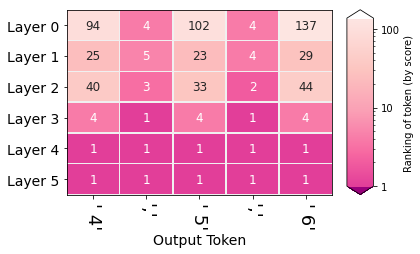
通过分析不同层的隐藏状态和神经元激活,文章发现早期层更擅长预测简单模式(如逗号),而数字递增需要更深层处理。因子分析还能识别出关注文本位置、语法特征(如代词、动词)甚至特定单词的神经元组。这些工具帮助研究者构建对Transformer内部运作的直觉。
Q&A
Transformer语言模型的可解释性分析有哪些常用方法?
文章介绍了两种主要方法:输入显著性(Input Saliency)和神经元激活分析(Neuron Activations)。输入显著性通过梯度×输入计算每个输入词对生成词的贡献度;神经元激活分析则观察前馈网络神经元的激活模式,并通过聚类或非负矩阵分解(NMF)发现神经元组与特定模式(如数字、逗号、标签)的对应关系。
梯度×输入(Gradient × Input)是如何计算输入词重要性的?
梯度×输入方法首先通过前向传播得到模型对每个输出词的logit分数,然后计算所选token的logit对输入词嵌入的梯度,将梯度与输入嵌入逐元素相乘,再取L2范数得到每个输入词的重要性分数,最后归一化。该方法基于一个假设:输入词的微小变化会导致输出显著变化,因此梯度越大表示该输入词越重要。
在分析神经元激活时,为什么使用非负矩阵分解(NMF)而不是主成分分析(PCA)?
因为PCA成分中会出现负值,而神经元激活值是非负的,负值难以解释。NMF将激活矩阵分解为非负因子的线性组合,更自然地对应神经元组的共同激活模式,从而更容易解释每个因子对应的模式(如数字、逗号等)。
文章中的神经元激活分析揭示了哪些类型的神经元组?
通过聚类和NMF分解,文章发现神经元组对应不同的模式:有的神经元组在生成数字时激活,有的在生成逗号时激活,还有的跟踪数字递增(激活随数值增大而增强)。在XML例子中,因子对应换行、标签、缩进、'<'和'>'字符等。此外,还有专注于第一个token的因子,以及对应代词、动词、名词等语言特征的因子。
输入显著性方法如何帮助理解GPT-2等模型的行为?
输入显著性通过可视化每个输入词对生成词的贡献度,帮助理解模型依赖哪些输入信息。例如,在生成莎士比亚出生年份时,模型主要关注人名(53%重要性),其次是'year'和'born';在生成列表时,模型会关注前一个token和序列开头的token。这有助于检测模型是否依赖正确的线索,以及发现潜在的错误或偏见。
文章提到的Ecco库是什么?它有什么用途?
Ecco是一个开源库,用于在Jupyter Notebook中为基于HuggingFace transformers库的GPT模型创建类似的交互式界面。它可以帮助研究人员可视化输入显著性和神经元激活,从而更直观地理解Transformer语言模型的内部工作机制。
