DeepSeek拟领投机器人AI初创公司Winverse AI数千万美元种子轮融资,投后估值约4亿美元。该公司由前腾讯杰出科学家胡瀚创立,专注机器人基础模型。这是DeepSeek两个月内第二次投资机器人领域,继8月入股宇树科技后,布局“身体”与“大脑”。
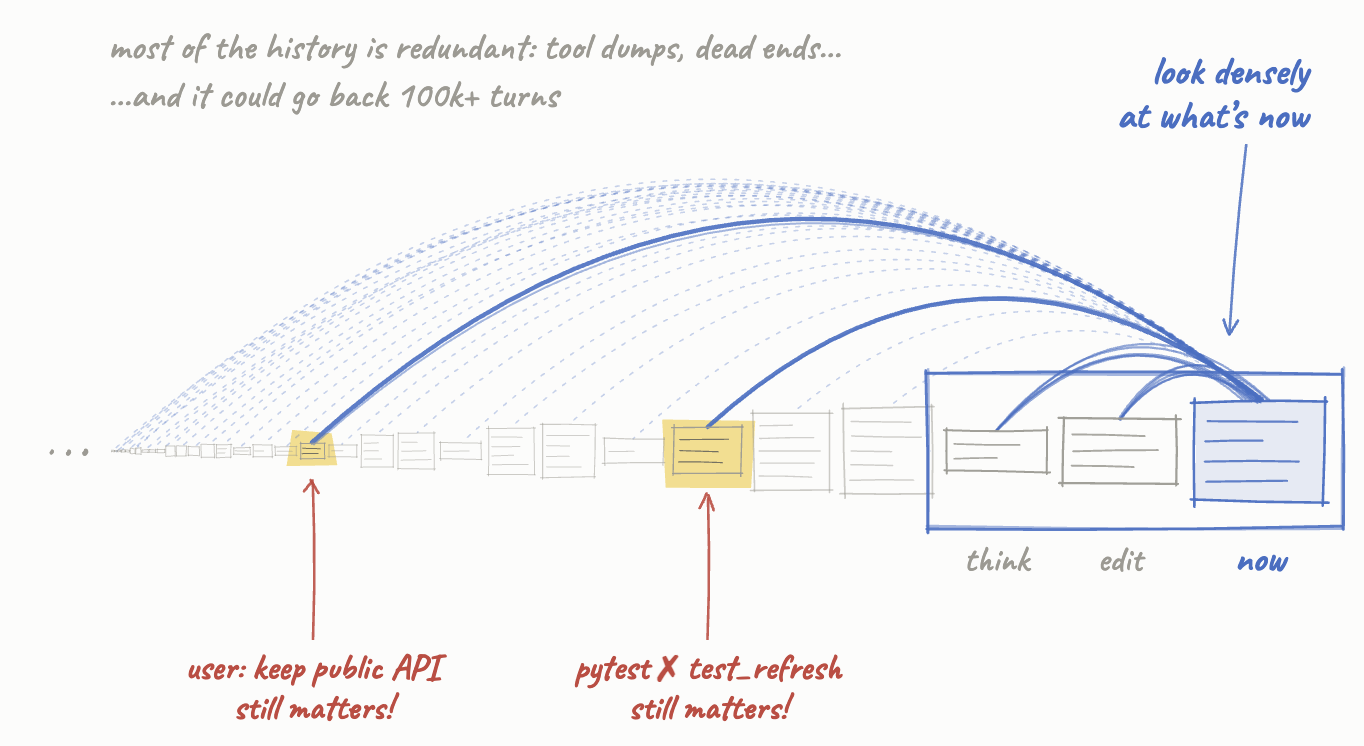
本文主张跳出仅修改harness适配模型的思路,探索改变语言模型的输入输出形态。作者认为decoder-only Transformer并非处理智能体轨迹的终极形态,可结合循环模型与Transformer,分别处理历史与当前观测,实现自动压缩与局部密集注意力。Jev等新形态证明替代权衡空间存在,需配套新目标函数。如今蒸馏与开放环境使这类研究更可行。
文章围绕LeCun对Transformer的四大批判展开:自回归token空间推理低效、自我改进受限、多模态编码分离、缺乏世界模型。作者结合ResNet、ViT寄存器token、Coconut潜空间推理等研究,指出模型正自发形成连续隐表示,类似人类默会知识与隐喻思维。最终提出:若寄存器token能跨会话沉淀为共享符号,或可突破自回归局限,迈向AGI。
A new era of increased demand and constrained supply is fundamentally changing the global transformer market and reshaping decision-making across the value chain.
循环MoE架构将MoE与循环Transformer结合,参数与算力比值虽与稠密模型相同,但行为迥异。MoE横向动态路由专家,循环机制纵向增加计算深度,二者叠加使知识容量与思考深度解耦,并可将显存瓶颈转为算力瓶颈。但训练难度大,存在路由坍缩、循环次数难定、梯度不稳等问题,实际部署尚少。
SimpleDesign是一种多模态蛋白质设计模型,无需多阶段训练,直接在数据空间端到端训练,结合序列交叉熵与结构回归目标,采用Transformer多模态骨干,在超200万序列-结构对上训练,在协同设计和无条件生成任务上表现优异。
2026年,OpenAI的GPT-6 Astra采用“循环深度”技术,在Transformer中引入深度循环,不增加参数却加深计算,引发AI安全争议。该技术区别于2017年废弃的序列循环,旨在提升参数效率,但面临训练不稳定、推理成本高等挑战。文章探讨了循环架构的复兴及其对AI发展的意义。
本文探讨Transformer注意力机制的计算复杂度问题,指出标准注意力在长上下文下时间和空间开销呈平方增长。文章概述了高效注意力、FlashAttention和线性注意力等优化方案,其中线性注意力通过将Softmax替换为elu+1特征映射,将复杂度降至线性,并引入RNN式递归状态,为后续Kimi等长上下文模型奠定基础。
阿里团队针对循环Transformer的计算冗余问题,提出两篇论文:MeSH通过动态记忆缓冲和路由器解决循环空转,提升零样本准确率;SpiralFormer通过多分辨率序列压缩,实现从全局到局部的计算,降低计算量并提升性能。两篇论文分别被ICLR和EMNLP接收,为高效大模型提供新思路。
2017年论文《Attention Is All You Need》提出Transformer架构,取代RNN,解决上下文丢失和训练慢的问题,实现并行处理,奠定现代生成式AI基础,并催生OpenAI等公司。
该论文提出Transformer架构,以“圆桌会议”式注意力机制取代RNN的排队传话,实现并行处理,成为现代AI基础。它通过Q/K/V机制理解词义,多头注意力和位置编码增强效果。实战中,上下文计算量平方增长,重要信息应放开头或结尾,提示词缓存可降成本,RAG能补充模型知识。
DeepSeek与阿里通义推出Engram/N-Gram记忆模块,为Transformer增加“记忆硬盘”,将固定知识查找从计算中分离,提升推理效率。实验显示性能提升,但社区测试发现其擅长短语补全而非事实回忆,且DeepSeek V4未采用Engram。该技术尚处探索阶段,可能改变AI竞赛格局。
本文面向初中生介绍人工智能基础知识,从哲学起源讲起,经图灵与计算机科学奠基,至1956年达特茅斯会议确立AI概念。重点阐述连接学派发展:万能近似定理、神经网络历经寒冬与复兴,最终Transformer架构实现并行训练,催生GPT等大模型,并迈向能调用工具的智能体生态。
HelixWorld 1.0是Noiz AI联合多机构发布的实时可交互音视频世界模型,支持24 FPS画面与48kHz双声道音频同步生成。它通过原生Transformer架构统一生成声画,并采用因果化、KV Cache等技术实现实时响应。团队计划数周内完全开源模型权重和代码,旨在推动世界模型生态发展。
LFM2.5-2.6B是面向端侧部署的轻量级AI推理模型,支持128K长上下文和智能体工具调用,性能可与大4倍参数模型竞争。在Apple M5 Max上推理速度达220 tok/s,AMD Ryzen CPU上113 tok/s,内存占用低于2.5GB,平衡了轻量化与高性能。HyperAI官网已上线该模型,并提供相关数据集、教程和百科词条更新。
本文回顾GPT系列发展:GPT-1确立Decoder-only预训练,GPT-2展现zero-shot潜力,GPT-3引入上下文学习,InstructGPT通过RLHF实现指令对齐,ChatGPT以对话形态普及,GPT-4迈向多模态。Decoder-only因训练简单、接口通用、扩展清晰而胜出,但存在推理延迟、长上下文成本、幻觉和对齐代价。
本文深入剖析BERT架构的机制与证据:MLM的80/10/10掩码策略在微调与特征提取场景影响不同;NSP被RoBERTa质疑的证据链复杂,其必要性取决于输入打包方式;BERT作为马尔可夫随机场可用吉布斯采样生成文本,但代价高昂;后续如ModernBERT等仍在升级Encoder-only路线,因其在分类、检索等任务上仍有成本优势。
KV Cache 是自回归推理中缓存历史 token 的 Key 和 Value,避免重复计算前缀。它利用历史 K/V 不变性,将重复计算转为显存占用,成为长上下文推理的核心瓶颈。推理分 prefill 和 decode 两阶段,KV Cache 内存随层数、序列长度和 batch 线性增长。GQA、PagedAttention 和量化等技术用于优化 cache 管理,平衡性能与资源。
大模型训练不稳定是常见问题,表现为loss尖峰、发散或NaN。关键预警信号是梯度范数异常,而非loss本身。常用修复手段各有针对:warmup解决Adam早期方差,Pre-LN保持恒等映射,BF16扩大数值范围,梯度裁剪仅作保险丝。loss spike根因包括数值、优化和数据问题。小模型稳定超参放大后失效,因学习率安全窗口随规模收窄,可用μP等方法解决。
Transformer 将进化为混合架构,结合注意力机制、长程状态和外部记忆等模块,以更高效地处理信息并支持多模态输入。硬件发展将影响架构设计,评估方式将变得复杂,强调系统协作和可控性。理解 Transformer 的成功在于其抽象层次和应对未来挑战的能力。
完成下面两步后,将自动完成登录并继续当前操作。