

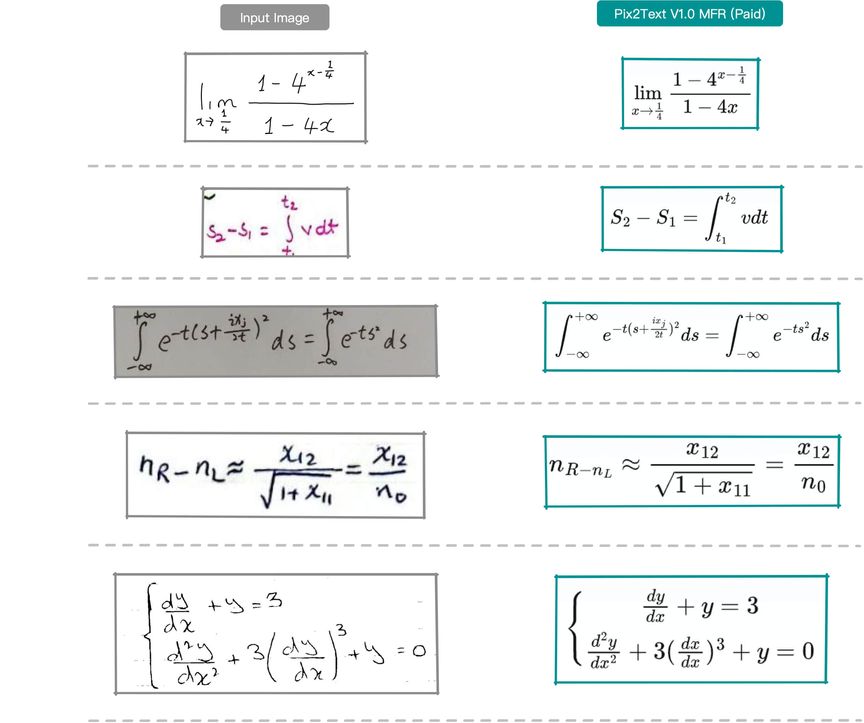

Pix2Text V1.0 新版发布,带来了最好的开源数学公式识别模型
内容提要
Pix2Text (P2T) V1.0 发布,推出了新的数学公式识别模型(MFR),显著提高了识别精度,成为开源领域的领先工具。该工具支持识别图片中的文字和数学公式,输出 LaTeX 表达式,旨在成为 Mathpix 的免费替代品。新版本移除了对旧模型的依赖,采用微软的 TrOCR 架构,支持多种语言,用户可免费使用网页版,每天识别上限为 10000 个字符。
延伸解读
技术架构转变:从 LaTeX-OCR 到 TrOCR
Pix2Text V1.0 的 MFR 模型放弃了原有的 LaTeX-OCR 架构,转而采用微软的 TrOCR。这一变化不仅提升了识别精度,还解决了旧项目依赖陈旧、维护成本高的问题。TrOCR 的引入使模型在保持小体积的同时,能够更高效地处理数学公式识别任务,为后续迭代奠定了更可持续的基础。
精度对比:开源模型中的领先地位
根据文章提供的测试数据,在包含 485 张真实用户图片的数据集上,Pix2Text V1.0 开源 MFR 模型的 CER 显著低于 Latex-OCR、Texify 及之前版本的付费模型。付费版模型精度进一步提升,已能与 Mathpix 以外的商用模型竞争。这表明小模型路线在公式识别领域同样能达到高水准。
实用性与资源限制
P2T 网页版免费开放,每人每天可识别 10000 个字符,适合日常使用,但明确禁止批量调用,以免影响他人。网页版目前仅支持简体中文和英文,其他语言需通过在线 Demo 尝试,而 Demo 硬件配置较低,速度较慢。付费模型提供 ONNX 和 PyTorch 版本,企业用户可根据需求选择不同授权。
Q&A
Pix2Text V1.0 的主要功能是什么?
Pix2Text V1.0 主要用于识别图片中的文字和数学公式,并输出 LaTeX 表达式。
Pix2Text V1.0 如何提高数学公式的识别精度?
Pix2Text V1.0 采用了新的数学公式识别模型(MFR),并移除了对旧模型的依赖,使用微软的 TrOCR 架构。
用户如何免费使用 Pix2Text V1.0?
用户可以通过网页版免费使用 Pix2Text V1.0,每天识别上限为 10000 个字符。
Pix2Text V1.0 与 Mathpix 有什么区别?
Pix2Text V1.0 旨在成为 Mathpix 的免费替代品,提供开源的数学公式识别功能。
Pix2Text V1.0 支持哪些语言?
Pix2Text V1.0 支持多种语言,包括简体中文、繁体中文、英文、法语等。
Pix2Text V1.0 的识别模型与其他开源模型相比如何?
Pix2Text V1.0 的 MFR 模型精度已超越多种开源模型,能够与商用模型竞争。
