

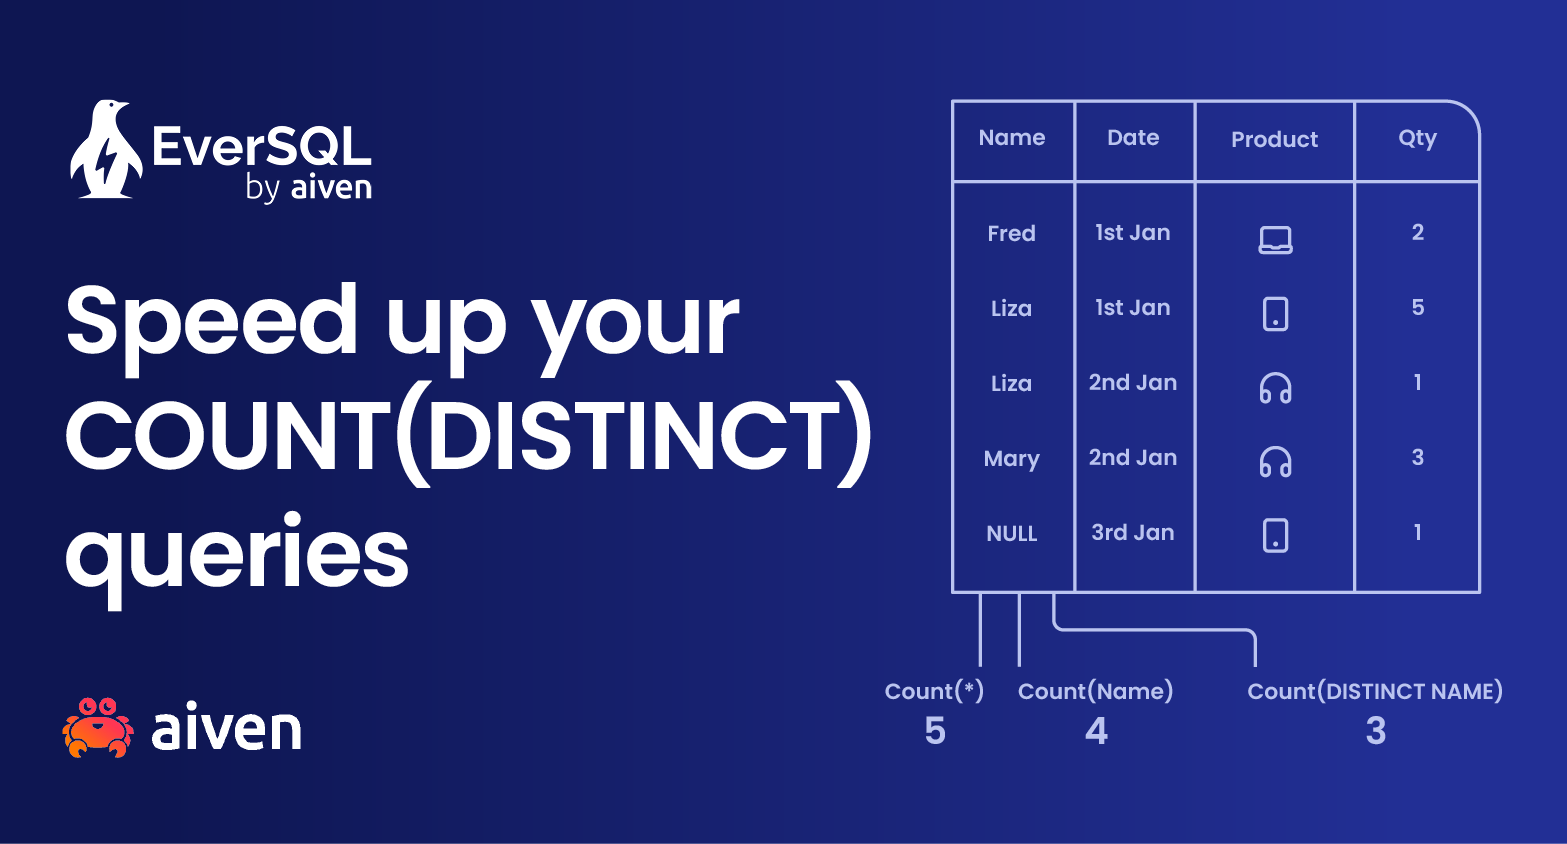
如何加速 COUNT(DISTINCT)
内容提要
在应用程序中,计数是常见的操作,但有时仅仅计数是不够的。本文介绍了加快COUNT(DISTINCT) SQL查询速度的方法,并提供了程序化的解决方案。
延伸解读
先确认瓶颈是否真的在 COUNT(DISTINCT)
文章建议,在尝试优化 COUNT(DISTINCT) 之前,先去掉 DISTINCT 子句执行同一查询,对比性能。如果没有明显提升,说明慢查询的根源可能在连接、过滤或其他部分,而非去重计数本身。这一验证步骤能避免盲目优化,将精力集中在真正的瓶颈上。
近似计数:用精度换速度的取舍
当业务不需要精确数字时,可利用数据库的基数估计(如 PostgreSQL 的 pg_class 或解析 EXPLAIN 输出)快速获得近似值。文章示例中,EXPLAIN 估算返回 2,而实际不同用户数为 3。这种方法适合展示“约 1.5 万用户”这类场景,但需注意估计值依赖统计信息的新鲜度,且可能因 WHERE 条件复杂而偏差。
预聚合方案:物化视图与 HyperLogLog 的适用边界
物化视图和 HyperLogLog 都通过预计算来加速,但适用场景不同。物化视图存储精确结果,查询快(示例中从 6346ms 降至 16ms),但刷新成本高(约 6490ms),适合写入稀疏的表。HyperLogLog 则提供可调精度的近似计数,支持跨时间粒度的聚合与集合运算,写入一次后可快速查询,适合需要灵活聚合的稀疏写入负载。两者都需人工维护数据新鲜度。
覆盖索引与查询重写:不预聚合的加速路径
覆盖索引通过包含查询所需列,使数据库仅扫描索引而非全表,示例中将查询时间缩短约一半。但索引会增加写入开销和存储空间,并依赖 Visibility Map 的维护。另一种思路是重写查询:用 EXISTS 子查询替代不必要的连接和 DISTINCT,示例中将 8287ms 降至 1658ms。这提醒我们,有时优化查询结构比加速 COUNT(DISTINCT) 本身更有效。
Q&A
COUNT(*)、COUNT(field) 和 COUNT(DISTINCT field) 有什么区别?
COUNT(*) 返回查询结果的行数;COUNT(field) 只计算该字段非 NULL 的行数;COUNT(DISTINCT field) 计算该字段不同非 NULL 值的数量。
为什么 COUNT(DISTINCT) 比普通的 COUNT 慢?
因为 COUNT(DISTINCT) 需要两步操作:先列出字段的唯一值,再对这些值进行计数,而普通 COUNT 只需直接计数行数。
如何利用数据库的基数估计来加速 COUNT(DISTINCT) 查询?
当不需要精确结果时,可以查询数据库的基数估计表(如 PostgreSQL 的 pg_class)或解析 EXPLAIN 命令的输出,获取近似的不同值数量,避免全表扫描。
物化视图如何帮助加速 COUNT(DISTINCT)?有什么注意事项?
物化视图将 COUNT(DISTINCT) 的查询结果存储为物理表,查询时直接读取,大幅提升速度。但物化视图不会自动更新,需要定期执行 REFRESH MATERIALIZED VIEW 来保持数据准确,适用于写入不频繁的场景。
HyperLogLog 数据结构如何用于加速 COUNT(DISTINCT)?
HyperLogLog 是一种固定大小的概率数据结构,可用于近似计算不同值的数量。通过扩展(如 Citus 的 postgresql-hll),可以按天等粒度存储 hll 类型,然后快速查询或合并多天的近似计数,甚至进行集合运算,适合稀疏写入的工作负载。
覆盖索引如何加速 COUNT(DISTINCT) 查询?
覆盖索引包含查询所需的全部列,使数据库能执行仅索引扫描(index only scan),避免回表查询,从而加速 COUNT(DISTINCT)。例如创建包含 Purchase_date 和 Username 的索引。但索引会增加写入开销和存储空间,需要定期维护。
在什么情况下可以避免使用 COUNT(DISTINCT)?如何改写查询?
当 COUNT(DISTINCT) 仅用于检查是否存在关联记录时,可以用 EXISTS 子查询替代 JOIN 和 DISTINCT,从而避免去重操作。例如将 COUNT(DISTINCT USERS.TAX_ID) 改写为 COUNT(USERS.TAX_ID) 配合 EXISTS 子查询,性能可提升数倍。
如何用 LIMIT 子句对 COUNT(DISTINCT) 进行粗略估计?
如果只需要展示大致数量(如显示“10000+ 用户”),可以在子查询中使用 LIMIT 限制扫描的行数,然后对子集进行 COUNT(DISTINCT),这样返回的结果是一个上限估计,能显著减少查询时间。
