

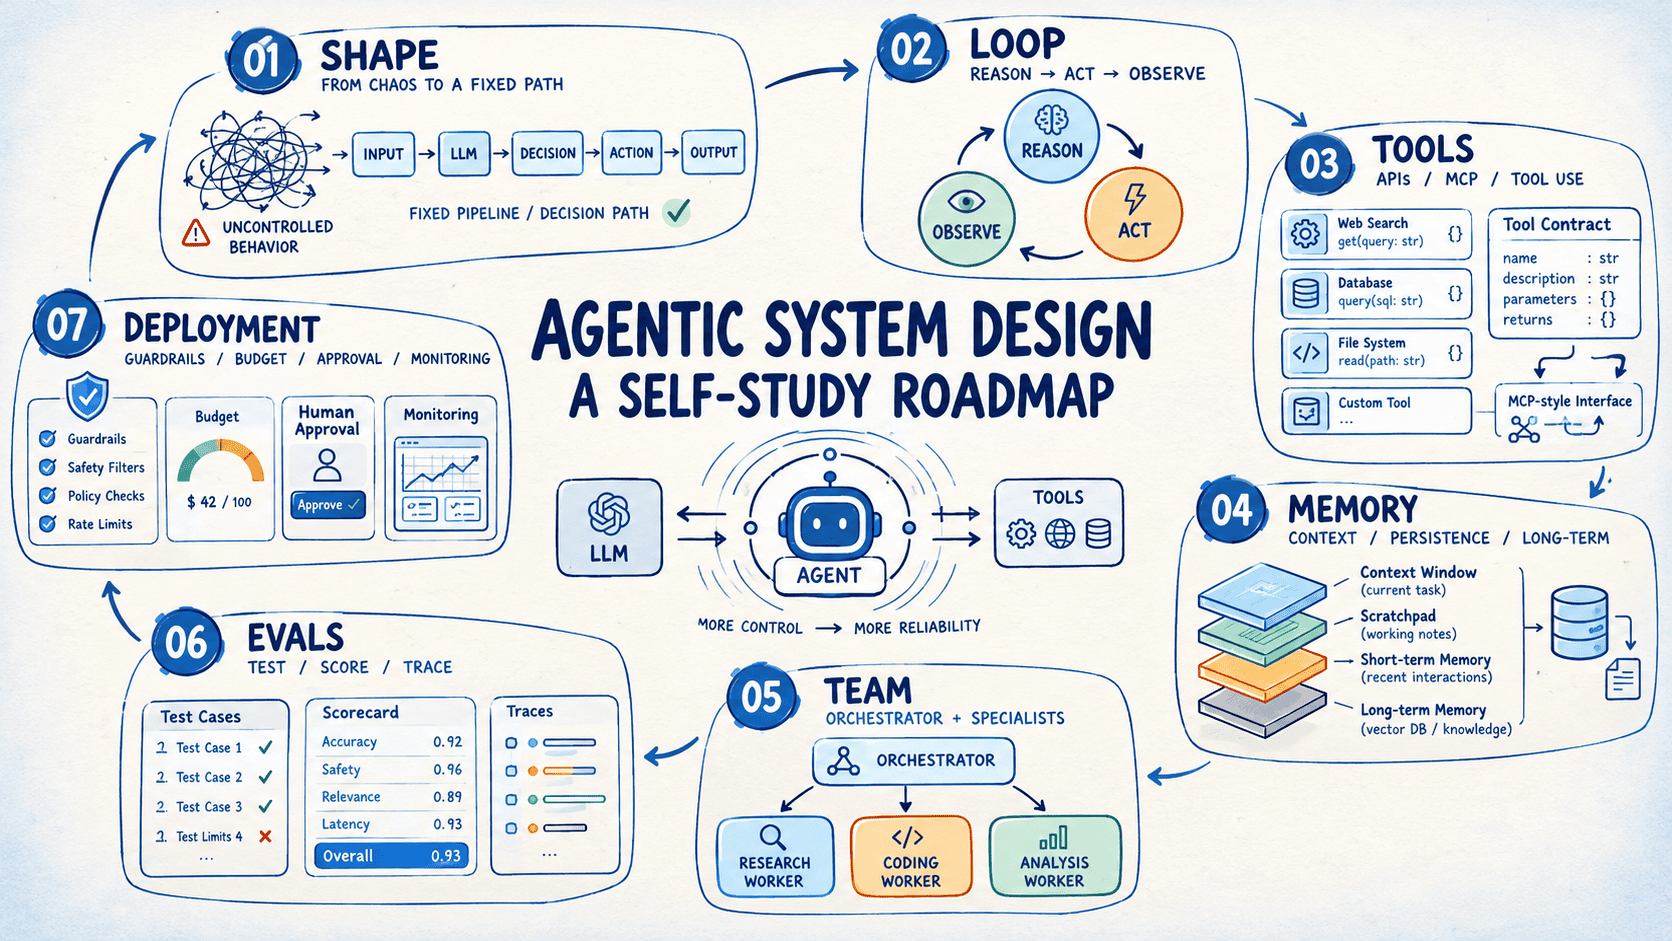

智能体系统设计:自学路线图
内容提要
本文以构建“事故调查员”智能体为例,分七步讲解智能体系统设计:判断任务适用工作流还是智能体;手写推理—行动循环;设计清晰的工具契约;分层管理记忆;用编排者—工作者模式并行调查;建立评测集量化质量;最后加入预算、只读权限、审批门与追踪等护栏,实现安全部署。
延伸解读
从失败模式出发的设计思路
文章开篇即指出,学习构建智能体应先学习它们如何失败。智能体常见的失败包括重复调用、编造参数或丢失关键细节,这些并非偶然,而是自主性带来的固有风险。因此,系统设计应提前规划控制循环、工具契约和每种失败的应对策略,而不是等运行时再补救。这种以失败为起点的思路,有助于开发者在项目初期就建立防御性设计习惯。
自主性光谱与任务分解
文章强调自主性是一个光谱,从单次提示到完全自主的智能体,每增加一分自主性都会带来成本、延迟和变异性的上升。设计时应从满足目标的最简形式开始,只有当测量到的失败需要更多灵活性时才升级。任务分解是背后的核心技能:将任务写成编号步骤,标记每个步骤是固定还是开放式,固定步骤留在代码中,开放式步骤交给模型。这为选择工作流还是智能体提供了可操作的判断依据。
手写循环与工具契约的价值
在转向框架之前,文章建议先手写一次推理-行动循环,以理解框架自动化的消息列表、工具注册、调度器和停止条件。同时,工具定义被视为契约,模型会严格遵循模式与描述。大多数智能体质量问题源于模糊的描述、不匹配的参数名或一个工具承担多个职责。通过将模式单独交给模型测试调用,可以验证描述是否清晰。这些实践能帮助开发者在早期发现并修复基础问题。
评测与护栏的部署闭环
文章将评测视为将质量转化为可改进数字的手段,建议在调优前构建代表性测试集,并检查工具选择、参数、最终答案和轨迹等多个层次。由于输出每次运行可能不同,需多次运行并跟踪通过率。部署时则需加入步数上限、时间与成本预算、最小权限工具、审批门、追踪和评测门等护栏,并以影子模式、辅助模式逐步扩大使用。这形成了一个从开发到部署的完整质量保障闭环。
Q&A
如何判断一个任务应该用工作流还是智能体?
先看谁决定下一步:工作流由代码固定步骤顺序,模型只填充内容;智能体由模型根据观察选择工具和行动。自主性是一个光谱,应从最简单的形状开始,只有当测量到失败需要更多灵活性时才升级。具体可把任务写成编号步骤,标记每个步骤是固定还是开放式,固定步骤留在代码中,开放式步骤交给模型。
智能体的推理-行动循环具体怎么运作?
循环是:模型推理后发出结构化工具请求,你的代码执行工具,结果作为下一条消息返回,模型继续推理,直到给出最终答案或触发步数上限。例如订单查询中,模型先调用order_lookup获取订单记录,再根据结果调用carrier_tracking获取物流延迟信息,最后综合回答。
设计工具时有哪些关键原则?
每个工具应只有一个目的,按领域命名(如logs_search、metrics_query),返回紧凑且有用的上下文并标记截断,错误信息要说明如何修复,并且每个智能体只暴露聚焦的工具集。描述中要包含工具做什么、何时使用、返回什么。可以用仅提供schema给模型测试调用来验证描述是否清晰。
智能体的记忆分为哪几层?如何管理?
记忆分三层:工作记忆是当前上下文窗口,可通过修剪、总结、清除旧工具输出来管理;会话记忆是当前任务的状态(计划、发现、待解决问题),可用暂存文件或状态对象实现;长期记忆是跨运行持久化的知识,用数据库加关键词或嵌入搜索。上下文工程要精选每轮进入窗口的token,工具结果累积快,提取完信息后应总结或清除原始输出。
多智能体协作适合什么场景?如何设计?
适合可拆分为独立调查线的任务,常用编排者-工作者模式:主导智能体规划,工作者在各自上下文窗口执行限定子任务,主导者综合结果。每个工作者需要清晰简报,包含一两句话的目标、结构化输出格式(如JSON)、可用工具、范围和努力边界。多智能体运行会成倍增加token消耗,只应用于有并行结构且价值足够的任务,先从两个智能体开始,按需增加。
如何评估智能体的行为质量?
先构建有已知好结果的代表性测试集,然后检查各层行为:工具选择(代码评分)、参数(代码评分)、最终答案(精确匹配用代码,质量用LLM评判)、轨迹(代码或LLM评判,如步数限制和避免重复调用)。由于输出每次运行有变化,每个任务应运行多次并跟踪通过率。失败时阅读完整轨迹,将失败归类为工具选择、参数、记忆或综合,每类指向不同修复方向。
部署智能体时需要哪些护栏?
需要步数上限(如25次工具调用)、时间和成本预算(如5分钟和0.50美元)、最小权限工具(只读凭证、白名单命令)、审批门(状态变更操作前人工确认)、追踪(记录每次模型和工具调用,JSONL轨迹和成本仪表盘)、评估门(CI中阻止分数下降的合并)。工具返回的文本应视为数据,用分隔符围栏并告知模型围栏内是数据。分阶段推出:影子模式、辅助模式、扩大使用。
